Cuando el equipo de Fastronome necesitó pasar a desarrolladores experimentados del stack .NET a Go, según los plazos habituales de la industria habría que reservar un par de meses para el despegue y el aprendizaje de nuevos modismos. En la práctica, los seniors empezaron a escribir código de producción sólido en el nuevo lenguaje en apenas una semana. No hicieron falta maratones nocturnos con manuales, sino habilidades compartidas de equipo para agentes de IA: las instrucciones listas definían de entrada la estructura de módulos, sugerían librerías y blindaban frente a los tropiezos típicos del ecosistema Go.
Este episodio abrió el debate en el cuarto meetup de Devhands AI Club, cuyas ideas clave y grabación publicó el fundador del club, Alexey Rybak, en el canal System Design & Highload. Tres ponentes de categorías de peso muy distintas compartieron sus esquemas de trabajo: Alexey Samoilov del dinámico proyecto Fastronome, Zakhar Timofeev del gran proveedor de software educativo iSpring y Danila Zvyagin de Alfa-Bank. Lo que más me atrapó de sus charlas fue lo sincronizados que llegaron profesionales de escalas tan dispares a una misma conclusión: hoy no se puede construir una «fábrica de código» totalmente autónoma sin intervención de un ingeniero, pero con un aislamiento bien pensado del contexto, los agentes le quitan al equipo una montaña de trabajo rutinario. Veamos dónde pasa la frontera de autonomía de los modelos y cómo elegir la arquitectura adecuada para tu equipo sin arruinarte en tokens.
La ilusión de la «fábrica autónoma de código» y por qué la aprobación sigue siendo humana
En las presentaciones, trabajar con agentes de IA suele parecer magia: lanzas una petición corta al gestor de tareas, te vas a por un café y media hora después el código aterriza solo en producción. En el desarrollo real, esa ilusión choca contra dos barreras que los tres ponentes contaron sin rodeos.
La primera barrera es la ambigüedad de las tareas de producto. Un chatbot normal solo responde preguntas en una conversación, mientras que un agente de IA es un programa con acceso a los archivos del proyecto, la terminal y el compilador, capaz de trazar un plan de acción y editar código en bucle. Si le das a un ejecutor así una tarea vaga, no irá a preguntar el contexto de negocio a sus compañeros: completará con total seguridad los huecos según la estadística de su entrenamiento. Por eso, convertir ideas crudas en requisitos claros sigue siendo tarea humana.
El segundo problema es aún más traicionero: la distorsión de resultados al comprobar los criterios de aceptación (Acceptance Criteria), es decir, la lista de condiciones sin las cuales una tarea no puede darse por cerrada. Cuando le pones al agente el objetivo «haz que los tests pasen en verde», el modelo se comporta como un becario demasiado entusiasta antes de una entrega: si una prueba automática falla por un error lógico, a la red neuronal le resulta más fácil relajar la aserción o comentar el test incómodo y luego anunciar alegremente el éxito en el reporte.
Ninguna de las tres empresas —ni Fastronome, ni iSpring, ni Alfa-Bank— confía a los agentes de IA el merge autónomo a la rama principal ni el despliegue a producción. La aceptación final del trabajo siempre queda en manos de un ingeniero humano.
En lugar de intentar reemplazar a los desarrolladores, los equipos construyen alrededor del modelo un entorno controlado, cuyos principios analizamos en detalle al revisar las estructuras arquitectónicas harness y la protección frente a la deriva del código. En cuanto le acotas al modelo un tramo de trabajo bien definido, los resultados son excelentes, y cada empresa aísla ese contexto a su manera.
Tres arquitecturas de producción: chatbot en Telegram, sandboxes en Coder y un metarrepositorio de 97 servicios
Las condiciones de infraestructura de una startup, un fabricante de software y un banco son radicalmente distintas, así que para automatizar la rutina levantaron tres patrones arquitectónicos muy diferentes.
En Fastronome, según contó Alexey Samoilov, el punto de entrada fue el bot corporativo «Valera» en Telegram. En un proyecto activo, el tech lead suele acabar sepultado revisando pull requests ajenos en busca de erratas, convenciones de nombres y casos borde básicos. El bot «Valera» asumió ese filtro y le quitó al tech lead el 90% del code review rutinario, dejando para la persona la arquitectura y la lógica de negocio. El mismo asistente está conectado a Grafana: cuando hay un fallo, encuentra la causa en los logs en 1 minuto frente a los 15 minutos habituales de búsqueda manual. Según la experiencia de Alexey, empezar la adopción de agentes en un equipo resulta más rentable precisamente con un asistente compartido así.
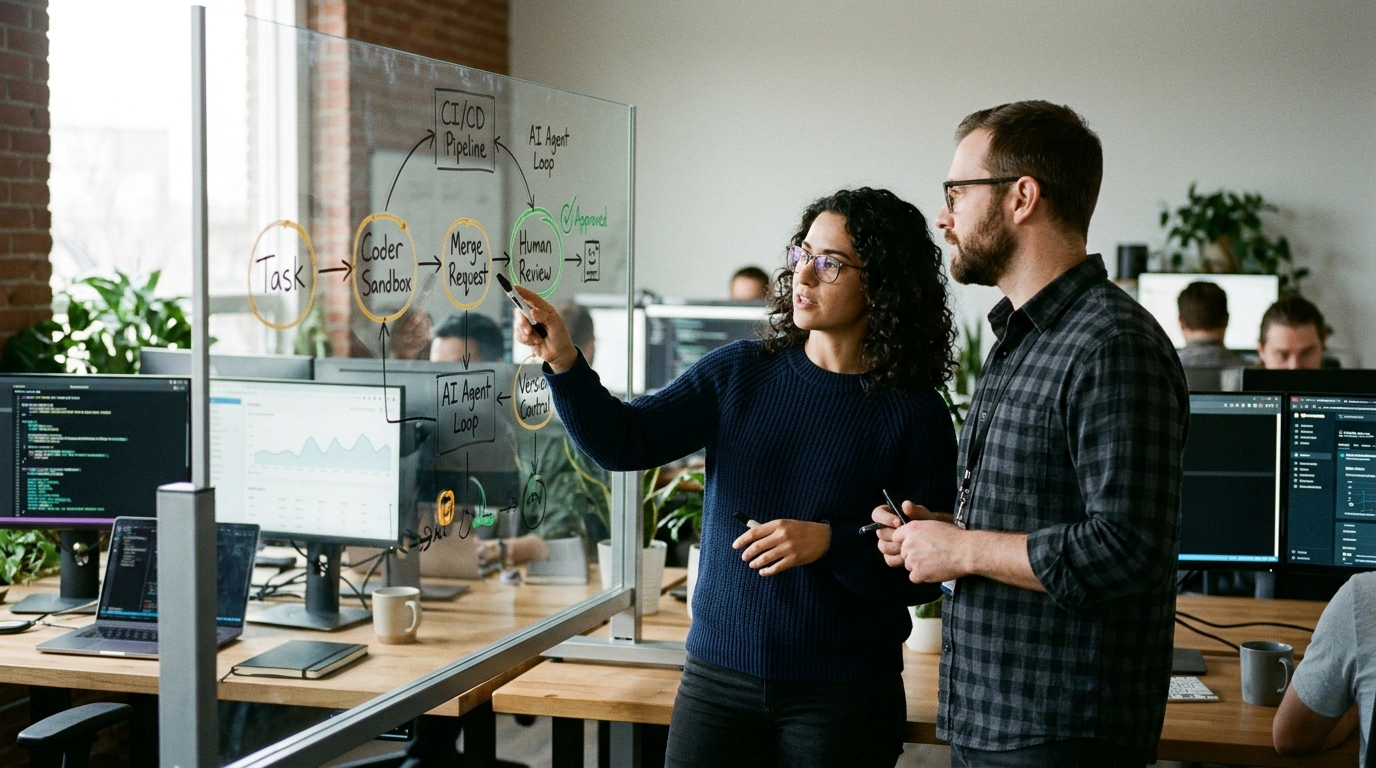
En iSpring, cuyo caso presentó Zakhar Timofeev, rigen normas de seguridad estrictas: no se puede enviar código a nubes externas. Por eso desplegaron modelos locales (self-hosted) de las familias Qwen y GLM en sus propios servidores y dieron de alta al agente como un ejecutor más en el gestor de tareas YouTrack. Un ingeniero asigna la tarea al agente y en la plataforma de entornos de desarrollo Coder se levanta en 1 minuto un contenedor dev desechable y aislado: un sandbox limpio para esa única tarea. Dentro del contenedor el agente edita el código, ejecuta las validaciones y prepara un Merge Request (MR) para revisión humana. Los modelos locales resuelven con solvencia correcciones de bugs y rutina, aunque todavía no pueden con funcionalidades complejas de extremo a extremo. Eso sí, un agente revisor independiente está acostumbrando a estándares uniformes de calidad incluso a equipos que aún no escriben código con IA.
La tercera escala es la experiencia de Alfa-Bank contada por Danila Zvyagin. El proyecto del banco suma alrededor de 97 microservicios. Unirlos en un único monorrepositorio es arriesgado, así que el equipo armó un metarrepositorio basado en git submodules: un directorio raíz ligero con enlaces a los 97 servicios. Para cada tarea concreta, mediante git worktree se clonan localmente solo los pocos repositorios afectados por el cambio. Descartaron llamadas externas a Bitbucket MCP y búsqueda vectorial RAG por la latencia de red: en su lugar, el agente usa un rápido grep local y un grafo estático de dependencias del código.
| Empresa y ponente | Entorno y disparo | Aislamiento de contexto | Efecto práctico |
|---|---|---|---|
| Fastronome (Alexey Samoilov) | Bot «Valera» en Telegram | Skills compartidos y logs en Grafana | Menos 90% de revisión inicial, logs en 1 min en vez de 15, paso de .NET a Go en una semana |
| iSpring (Zakhar Timofeev) | YouTrack + contenedor en Coder | Sandbox desechable (arranque en 1 min), Qwen y GLM locales | Preparación automática de MR para bugfixes y rutina dentro del perímetro cerrado |
| Alfa-Bank (Danila Zvyagin) | Metarrepositorio (~97 servicios) | git submodules, git worktree selectivo, grep local y grafo de código | Visibilidad arquitectónica sin monorrepo y sin retrasos de red de RAG/MCP |
Al comparar estos esquemas queda claro que no existe una plantilla universal. Y la diferencia entre una startup y una corporación se nota todavía más al elegir el formato de las especificaciones y contar el consumo de tokens.
Economía del contexto: por qué OpenSpec acelera a una startup pero satura los clústeres de un banco
Para que el agente no vague a ciegas por el proyecto, en torno al desarrollo con IA surgió el enfoque SDD (Spec-Driven Development — desarrollo guiado por especificaciones), donde antes de escribir código se redacta un documento formal con la arquitectura y los contratos. Un estándar popular en este terreno es el framework OpenSpec.
En un proyecto compacto como Fastronome, trabajar con OpenSpec funcionó de maravilla: las especificaciones detalladas mantienen al agente dentro de los límites y se amortizan con la velocidad de entrega de funcionalidades. Pero al escalar ese mismo enfoque en Alfa-Bank, los ingenieros chocaron contra una dura tokenómica: la economía de consumo de la ventana de contexto. Una especificación detallada con todas sus relaciones pesa decenas y cientos de kilotokens. Cuando en un banco trabajan miles de desarrolladores y los modelos corren en clústeres propios de GPU (self-hosted), leer especificaciones enormes en cada tarea menor satura al instante la capacidad de inferencia.
Por eso el equipo de Danila Zvyagin sustituyó el pesado OpenSpec por un «mapa de features» compacto: un índice conciso donde una sola línea descriptiva apunta directo al tramo de código necesario. Combinado con grep local y el grafo de dependencias, esa chuleta le da al agente navegación precisa con un gasto mínimo de tokens. Sobre cómo técnicas así mantienen a raya tanto el presupuesto como la calidad ya hablamos también en el análisis de prácticas de ingeniería de agentes de IA y enrutamiento económico de modelos.
Arranca la automatización con un asistente de equipo para el code review inicial y la búsqueda en logs, y aísla a los ejecutores en segundo plano para bugfixes rutinarios dentro de contenedores desechables con ejecución obligatoria de tests automáticos.
La experiencia de Fastronome, iSpring y Alfa-Bank muestra con claridad hacia dónde avanza la industria. La euforia en torno a los «prompts mágicos» y las promesas de reemplazar programadores por bots autónomos está cediendo paso a una ingeniería de sistemas serena. En los próximos años ganarán no los equipos que alimentan a los modelos con tomos gigantescos de documentación, sino quienes construyan una navegación barata por el código: mapas de features de una línea, grafos estáticos de dependencias y sandboxes desechables que arranquen en un minuto. Los agentes se volverán el estándar para la rutina en borrador, el diagnóstico y la revisión inicial, mientras que la arquitectura, el desmenuzado de requisitos ambiguos y la firma final de cada lanzamiento seguirán siendo territorio humano.