En la prueba práctica de línea de comandos Terminal-Bench 4.1, el modelo ligero gemini-4-hydrogen alcanzó un 57% frente al 18,2% de su predecesor Gemini 3.8 Flash: un salto de más del triple en tareas de consola, mientras reduce las alucinaciones en más de cinco veces. Para mí, ese dato del informe de Google fue la gran sorpresa del lanzamiento: rompe la vieja regla según la cual pagarías siempre una respuesta rápida con lógica superficial, y para analizar algo en serio tocaba esperar a un modelo pesado y lento.
El 12 de noviembre, Google jubiló la marca Flash en su cuarta generación de redes neuronales y convirtió a Hydrogen en el motor base de todos sus productos clave: desde el modo de búsqueda Google AI Mode y la app de Gemini hasta Google AI Studio y el entorno de desarrollo agéntico Google Antigravity. Veamos por qué la compañía sustituyó la familia Flash por Hydrogen en el buscador y cómo un modelo compacto resuelve tareas complejas sin perder velocidad.
La tabla periódica en lugar del «destello»: el lugar de Hydrogen en la familia Gemini 4
Dejar atrás el nombre Flash no es un simple cambio de fachada por capricho químico. En la cuarta generación, Google organizó una jerarquía inspirada en la tabla periódica, donde el peso del elemento refleja el tipo de carga de trabajo. En el piso superior operan los buques insignia pesados: el protegido Gemini 4 Carbon y el preciso Gemini 4 Argon, encargados de la planificación arquitectónica profunda, las matemáticas complejas y los ciclos autónomos largos.
Los antiguos modelos «ligeros» funcionaban como un mensajero con prisa: traían rápido un recado corto, pero perdían el hilo en cuanto la cadena pasaba de cinco o seis pasos. Según detalla el anuncio arquitectónico de Google, Hydrogen (el hidrógeno, el elemento más ligero) no se diseñó como una copia recortada para borradores, sino como un ejecutor veloz para cadenas agénticas, programación y búsqueda en vivo.
Aun así, el modelo conserva la misma «memoria operativa» que las versiones mayores: una ventana de contexto unificada de 1.000.000 de tokens, con capacidad de generar salidas largas de hasta un millón de tokens mediante el modo de continuación (continuation). Puedes cargar de golpe una carpeta entera con documentación y código sin trocearla. La tarifa en Gemini API y AI Studio se mantiene fija en todo el rango de la ventana: $1.50 por millón de tokens de entrada y $7.50 por millón de tokens de salida; además, gracias a un seguimiento más estricto de las instrucciones, los socios de Google registraron una reducción del 12–23% en el consumo de tokens en tareas de procesamiento de datos y grafos.
Cuatro marchas para el cerebro: presupuesto de razonamiento y duelo contra Argon
Con toda razón te preguntarás cómo un mismo modelo ligero responde al instante en el buscador y, a la vez, compite en lógica con redes pesadas. La clave está en el presupuesto de razonamiento configurable (thinking budget), que funciona como la caja de cambios de un coche: no necesitas la reductora de un todoterreno para ir por autopista llana, pero en una cuesta empinada es indispensable.
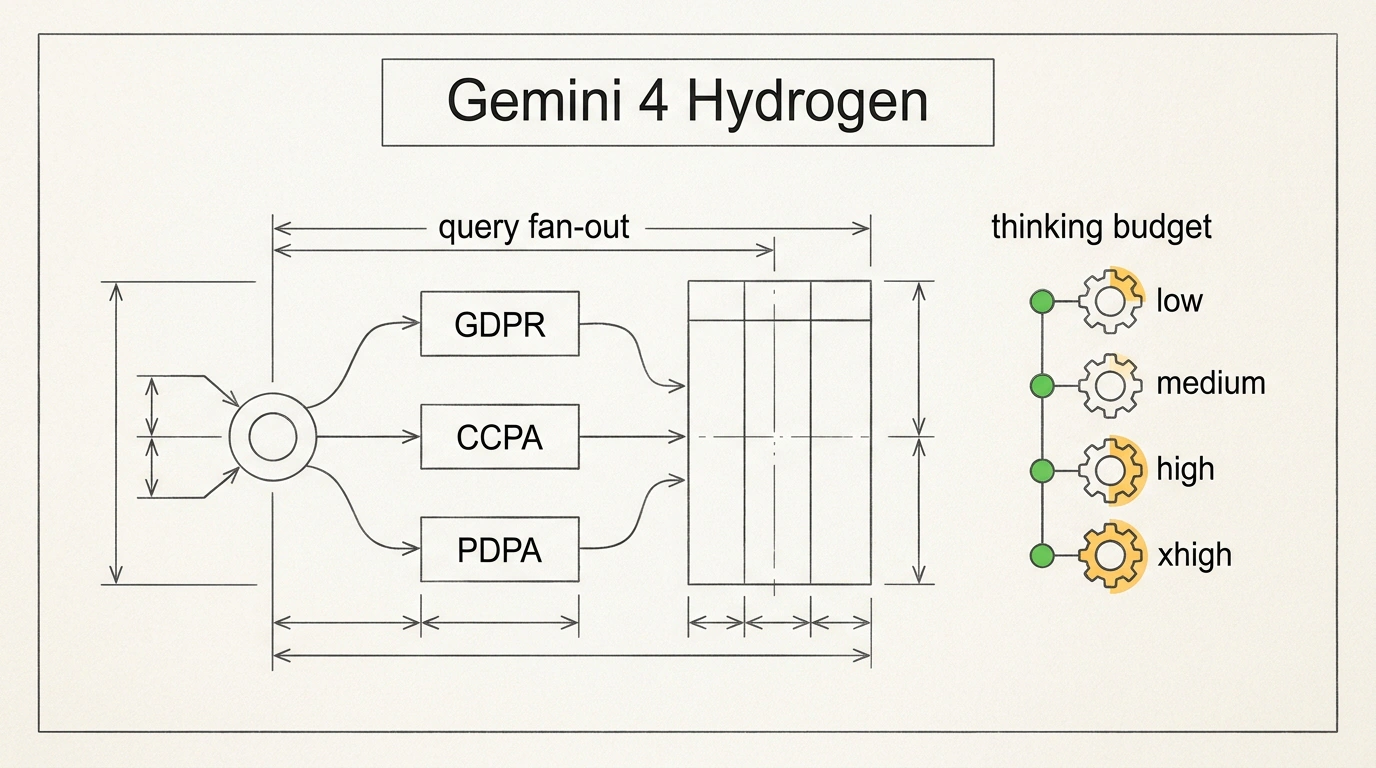
En la interfaz de AI Studio y en la API dispones de cuatro niveles discretos de razonamiento: low, medium, high (por defecto) y el modo de rigor extremo xhigh. La latencia hasta el primer token (TTFT, Time-To-First-Token) en la novedad es 2,5 veces menor que en Gemini 3.8 Flash con un contexto equivalente. Y en los niveles altos se activa una verificación profunda: en el índice independiente Artificial Analysis Intelligence Index, Hydrogen alcanza 51 puntos en nivel estándar —superando al pesado Gemini 4 Argon (50 puntos)— y sube hasta 54 puntos en xhigh.
Comparemos ambos enfoques en una tarea real de búsqueda: contrastar los requisitos regulatorios sobre datos biométricos en la UE (GDPR), California (CCPA) y Singapur (PDPA) y reunir las sanciones por incumplimiento en una sola tabla. Con Gemini 4 Argon, construir la respuesta completa lleva 14,2 segundos por el recorrido largo de su árbol de razonamiento. En cambio, Gemini 4 Hydrogen en Google AI Mode con nivel medium entrega la estructura inicial de la ficha en 1,8 segundos y en 5,6 segundos completa la tabla comparativa validando los artículos legales, con un 100% de precisión en las citas normativas.
Eso sí, la profundidad extra tiene un coste directo. En la prueba del especialista en automatización Julian Goldie, generar el informe semanal del embudo de una agencia de consultoría en nivel low tardó 8 segundos y consumió 1.456 tokens. El mismo prompt en xhigh tardó 15 segundos y quemó 3.277 tokens: la factura se duplicó con creces en un resumen rutinario que el primer modo ya había resuelto sin fallos.
Búsqueda en abanico en Google AI Mode: cómo se arman respuestas y tablas al vuelo
Precisamente esa capacidad para cruzar leyes y cifras de tres jurisdicciones en segundos llevó a Robby Stein, responsable de búsqueda en Google, a convertir a Hydrogen en el modelo por defecto de Google AI Mode para todos los usuarios. Cuando introduces una consulta compuesta —incluso con erratas o lenguaje coloquial—, se activa la ramificación en abanico (query fan-out).
Imagina un mapa de metro donde tu pregunta es la estación central. En lugar de hacer una búsqueda lineal única, Hydrogen divide el problema en ramales independientes (reglas del GDPR en la UE, normas de la CCPA en California, requisitos de la PDPA en Singapur y tablas de multas) y escanea en paralelo páginas web, tablas e imágenes en cada dirección. Así ensambla la respuesta con enlaces y tabla lista sin bloquear la interfaz. Para quienes tienen un sitio web, la regla práctica es clara: la IA del buscador prioriza las páginas que ofrecen una respuesta nítida de un par de frases justo debajo del titular y ordenan los datos en tablas limpias.
Arquitecto y velocista en el mismo equipo: el enrutador Orchestrator en Google Antigravity
En el entorno agéntico Google Antigravity, el modelo trabaja tanto en solitario como mediante el enrutador dinámico Orchestrator, que combina la planificación de los buques insignia con la velocidad del núcleo Hydrogen:
- Planificador (Argon o Carbon): abre el proyecto en modo lectura, analiza la arquitectura y traza un plan paso a paso.
- Ejecutor (Hydrogen): escribe y edita el código según el plan, instala paquetes, corre los tests en terminal y lanza el agente de navegador para verificar el resultado.
- Retorno ante atascos: si el ejecutor topa con un fallo complejo, el enrutador devuelve la tarea al modelo superior para ajustar el plan.
Según las mediciones de Google, la dupla de Orchestrator mantiene la tasa de éxito de Carbon, pero ahorra un 24% de cuota de peticiones y trabaja un 19% más rápido. En la prueba práctica de Goldie, este tándem escribió y verificó en el navegador en 9 minutos un portal interactivo de onboarding de tres archivos con 3.800 líneas de código y cero errores en consola; por su parte, Hydrogen en solitario reparó en 2 minutos y 11 segundos un repositorio roto de puntuación de solicitudes, llevando los tests de cero a 7 de 7.
En Google AI Studio y en la API no dejes el nivel high por defecto para operaciones sencillas: baja los resúmenes con plantilla y la clasificación de correos a low o medium. Y al construir proyectos en Antigravity, mantén una tarea por chat y añade al final de tu petición que el agente de navegador integrado verifique el resultado.
Dónde la velocidad cede ante la profundidad: límites reales y reglas de enrutamiento
Pese a lograr un 96,7% de honestidad en pruebas agénticas internas, reducir en un 81% las ediciones innecesarias de código y multiplicar por 2,3 la defensa frente a inyecciones ocultas (indirect prompt injection), Hydrogen sigue siendo un velocista, no un matemático teórico. Si estiras un mismo chat con encargos heterogéneos más allá del 40% de la ventana de contexto, la precisión para retener detalles empieza a caer.
Para exprimir al máximo la serie Gemini 4, reparte las tareas por niveles:
- Niveles
lowymedium: búsqueda web, armado de tablas comparativas (como en el caso de GDPR, CCPA y PDPA), clasificación de datos, formateo e iteraciones rápidas de código. - Niveles
highyxhigh: caza de bugs sutiles (como condiciones de carrera al hacer doble clic en un formulario) y revisión de documentos largos de hasta un millón de tokens. - Modelos Argon y Carbon: demostraciones matemáticas profundas, algoritmos multinivel atípicos y diseño de sistemas complejos desde cero.
El salto de Flash a Gemini 4 Hydrogen te quita de encima el dilema entre «rápido pero superficial» y «brillante pero lento»: ahora tienes una herramienta flexible donde velocidad y rigor se regulan con un solo dial según lo que valga cada tarea.