La mañana previa a una actualización planificada de base de datos empieza tranquila: tienes abierta la pestaña con las gráficas del entorno de pruebas y en el chat del trabajo un compañero propone hacer el cambio a mediodía. En el monitor todo es idílico: el test de carga artificial estuvo golpeando toda la noche sin un solo error, los tiempos de respuesta rozan el mínimo y los procesadores van a medio gas. Pero basta con dirigir a los usuarios reales hacia el clúster actualizado para que, en un minuto, las gráficas de latencia se disparen hasta el techo, el pool de conexiones se sature y los pedidos reales empiecen a caer por timeout.
Siempre miré con escepticismo los benchmarks de laboratorio antes de migraciones serias de bases relacionales. ¿Cómo probar una nueva versión del motor o un esquema de tablas modificado con un flujo real de transacciones de clientes sin poner en riesgo los datos vivos ni el bolsillo de los usuarios? En el blog de ingeniería de Airbnb encontré el desglose de cómo su equipo de infraestructura de datos dejó atrás las pruebas artificiales y montó un pipeline de captura y reproducción offline de tráfico real para clústeres MySQL y Amazon Aurora.
Por qué los benchmarks sintéticos son ciegos ante las caídas reales en producción
Sigamos la cadena lógica para ver qué ocurre dentro de la base bajo carga real. Cuando lanzas un generador sintético de consultas, pones a prueba el sistema en condiciones de invernadero: el script elige filas aleatorias de manera uniforme, como si por un puente nuevo circularan coches idénticos cada cinco segundos. Pero si en hora punta se suben a ese puente tres camiones sobrecargados y por el enlace lateral se cuelan cien taxis, la capacidad teórica se desploma.
En la vida real las consultas no se reparten de forma uniforme: aparece el sesgo de datos (data skew). Cuando miles de viajeros abren a la vez una ciudad popular en temporada alta, millones de consultas por segundo (QPS) golpean exactamente las mismas filas e índices calientes. Si varias transacciones pesadas compiten por los mismos registros, en la base estallan conflictos de bloqueo de filas y bloqueos mutuos (deadlocks) que jamás aparecen en una prueba uniforme.
Todavía más peligroso es el escenario de las actualizaciones mayores del motor, como pasar de MySQL 5.7 a MySQL 8.0. Si en la nueva versión cambió la lógica del optimizador de consultas, sobre una tabla real compleja el planificador puede elegir de golpe otro índice o cambiar el orden de un JOIN. Como un script sintético solo prueba patrones pensados de antemano, las combinaciones raras y pesadas de filtros quedan en un punto ciego hasta el día del despliegue.
Seguro que te estás preguntando: «¿Y por qué no hacer que los propios servicios de backend registren cada consulta SQL en un log?». A la escala de Airbnb, esa idea choca contra la realidad de la infraestructura. Cientos de clústeres MySQL atienden a una flota heterogénea de microservicios en Java, Python y Ruby. Obligar a los equipos a mantener librerías de logging a medida en tres lenguajes distintos ahogaría el desarrollo en rutina, y escribir logs dentro de las apps o del núcleo del SGBD añadiría milisegundos extra de latencia a cada petición del cliente.
Arquitectura de captura con ProxySQL, limpieza de datos y el truco de los IDs de inserción
Como no se podía tocar el código de los microservicios ni sobrecargar el núcleo de la base, los ingenieros de Airbnb decidieron interceptar el tráfico en la capa de red. En su arquitectura, todas las llamadas desde las aplicaciones hacia los clústeres MySQL ya pasan por una capa proxy unificada: ProxySQL. Al activar el registro de eventos en el proxy, los servicios en Java, Python y Ruby ni se enteran de la captura y los servidores de base de datos no gastan un solo ciclo de CPU en perfilado.
El pipeline de grabación y preparación del tráfico funciona en cuatro pasos:
- Captura en el proxy. Para grabar el perfil de carga de un clúster, se activa en la configuración de ProxySQL el registro de eventos mediante el parámetro
mysql-eventslog_filename, que captura el flujo de llamadas SQL sin tocar la lógica de negocio. - Troceado y envío con Log Mover. Para no llenar los discos locales del proxy, a su lado corre un proceso sidecar en segundo plano llamado
Log Mover. Lee los registros de consultas, los empaqueta en archivos aislados de cinco minutos por cada clúster y los sube de forma asíncrona al almacenamiento en la nube (S3 y HDFS). Vimos una táctica parecida en el artículo sobre por qué en Airbnb mantuvieron la entrega de configuraciones mediante un contenedor sidecar para una flota de servicios multilingüe. - Enmascaramiento de datos y armado de transacciones. Antes de guardar los archivos, un script de sanitización limpia los datos personales (PII masking) en los parámetros de las consultas para que la información privada de los clientes no llegue a los entornos de prueba. Al mismo tiempo, el pipeline agrupa llamadas sueltas en cadenas de transacciones conservando su orden original de confirmación (commit order).
- Reescritura de identificadores de inserción. Aquí aparece una trampa sutil de ingeniería. En producción, dos hilos paralelos ejecutaron un
INSERTcasi a la vez y la base asignó al primer pedido el número1001y al segundo el1002. Al reproducir el log en el entorno de pruebas, el segundo hilo puede llegar al disco un suspiro antes que el primero y quedarse con el1001. Si justo después viene unUPDATEo unSELECTbuscando registros relacionados por el ID original, la cadena de transacciones se rompe con errores de clave foránea.
Para evitar esa desincronización, en Airbnb guardan el valor real de last_insert_id que devolvió la base de producción al escribir. Cuando el ejecutor de reproducción lee una sentencia de inserción, con la bandera --rewrite-last-insert-id=true reescribe dinámicamente el INSERT fijando a la fuerza el identificador histórico en la nueva fila. Así todas las lecturas y actualizaciones posteriores encuentran sus entidades.
Ensayo de migración a MySQL 8.0, planificación de capacidad y el precio de ingeniería
Una vez listos los bloques de cinco minutos de logs limpios, arranca la validación. Los ingenieros despliegan una instantánea (snapshot) de la base de producción tomada exactamente en el instante en que empezó la grabación del tráfico (T0), dentro de un clúster de pruebas aislado con la nueva versión del SGBD y sin salida a la red externa. Luego la herramienta replay-runner se conecta al entorno (--target=staging-db:3306), recoge los logs desde --log-source=s3://db-logs/cluster-01/ y reproduce el tráfico en tiempo real (--speed=1.0), acelerado (2x) o con QPS de estrés, comparando las latencias P95 y P99, el uso de CPU y los errores frente a la línea base.
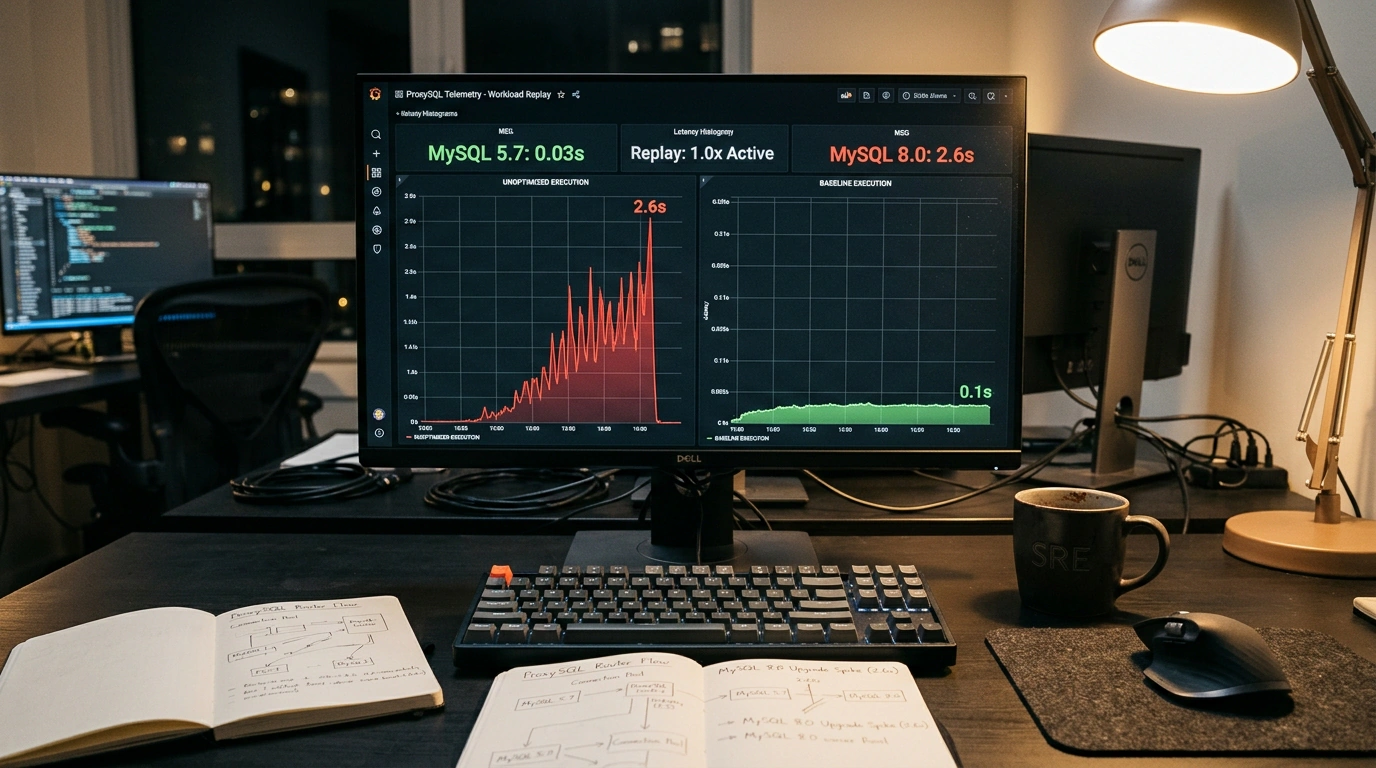
El valor de este enfoque quedó clarísimo al preparar la migración de los clústeres de Airbnb de MySQL 5.7 a MySQL 8.0. Durante la reproducción de tráfico real sobre la versión 8, el pipeline detectó una anomalía que las pruebas sintéticas habían pasado por alto: una consulta de producción que en MySQL 5.7 tardaba de forma estable 0.03 segundos pasó a tardar 2.6 segundos en la nueva versión. Al revisar el plan de ejecución se vio que, por diferencias en los algoritmos de ordenación y un orden no determinista de las filas, el optimizador de MySQL 8.0 dejaba de procesar bien esa selección. Al cazar el salto a 2.6 segundos en staging semanas antes del lanzamiento, los ingenieros corrigieron la consulta a tiempo y evitaron el incidente.
La segunda ventaja del pipeline es la planificación de capacidad (capacity planning). El equipo reprodujo el perfil real de carga aumentando la proporción de escrituras en un 80% para ver con antelación el techo de los discos y medir el margen de maniobra del clúster (headroom). Cómo una sola consulta pesada puede tumbar los nodos de almacenamiento incluso con un QPS medio normal lo explicamos en nuestro análisis sobre la evolución de la protección de los SGBD contra sobrecargas en cascada en servicios de alto tráfico.
Por supuesto, tanta precisión tiene un precio de ingeniería y conviene sopesar con cabeza fría los límites del método:
- Dependencia de la instantánea. Si el volcado de la base de pruebas está desfasado respecto al inicio de la grabación de logs aunque sea por un par de minutos, las consultas de actualización apuntarán a filas aún no creadas o ya modificadas.
- Compromiso con el autoincremento. Sustituir a la fuerza
last_insert_idimpide poner a prueba el generador nativo de claves primarias de la nueva versión del SGBD bajo carga concurrente. - Costos de almacenamiento y limpieza. Mover bloques de logs de cinco minutos a la nube exige recursos y filtros de enmascaramiento muy fiables para que ningún dato sensible se cuele en el entorno de pruebas.
Al mirar el sistema de Airbnb con cientos de clústeres y sidecars, es fácil pensar que sin un departamento enorme de infraestructura no puedes acercarte a algo así. Pero no necesitas construir una nave espacial ni hacerlo perfecto al primer intento. Aunque antes de tu próxima actualización de base de datos te limites a capturar durante cinco minutos las consultas reales de lectura a través de un proxy, limpiar los parámetros de datos personales y reproducirlas sobre una copia restaurada desde un backup, ya te estarás quitando la venda de los ojos: verás los planes de ejecución reales sobre tablas vivas y atraparás las sorpresas del optimizador antes de que las sufran tus usuarios.