Утро перед плановым обновлением базы данных начинается спокойно: открыта вкладка с графиками тестового стенда, а в рабочем чате висит сообщение от коллеги с предложением начинать переключение в обед. На мониторе полная идиллия — искусственный нагрузочный тест отстучал всю ночь без единой ошибки, время отклика у нижней границы, процессоры загружены наполовину. Но стоит пустить на обновлённый кластер настоящих пользователей, как через минуту графики задержек улетают в потолок, пул соединений забивается, а живые заказы начинают падать по таймауту.
Я всегда со скепсисом смотрел на лабораторные бенчмарки перед серьёзными миграциями реляционных хранилищ. Как проверить новую версию СУБД или изменённую схему таблиц на настоящем потоке клиентских транзакций, не ставя под удар живые данные и кошельки пользователей? В инженерном блоге Airbnb я нашёл разбор того, как их команда инфраструктуры баз данных ушла от искусственных тестов и построила конвейер захвата и офлайн-воспроизведения реального трафика для кластеров MySQL и Amazon Aurora.
Почему синтетические бенчмарки слепы к реальным авариям в продакшене
Пройдём по логической цепочке и посмотрим, что происходит внутри базы под нагрузкой. Если ты запускаешь синтетический генератор запросов, то проверяешь систему в тепличных условиях: скрипт равномерно выбирает случайные строки, словно по новому мосту пустили одинаковые легковушки с интервалом в пять секунд. Но если на этот мост в час пик выезжают три перегруженных самосвала, а с боковой развязки вклинивается сотня такси, расчётная пропускная способность рушится.
В реальной жизни запросы распределены неравномерно — возникает перекос данных (data skew). Когда тысячи путешественников одновременно открывают популярный город в разгар сезона, миллионы запросов в секунду (QPS) бьют в одни и те же горячие строки и индексы. Если несколько тяжёлых транзакций конкурируют за одни и те же записи, в базе вспыхивают конфликты блокировок строк и взаимные блокировки (deadlocks), которых в равномерном тесте не возникает.
Ещё опаснее ситуация при мажорных обновлениях движка, например при переходе с MySQL 5.7 на MySQL 8.0. Если в новой версии изменилась логика оптимизатора запросов, то на сложной живой таблице планировщик может внезапно выбрать другой индекс или поменять порядок соединения (JOIN). Поскольку синтетический скрипт проверяет лишь заранее придуманные шаблоны, редкие и тяжёлые комбинации фильтров остаются в слепой зоне до самого релиза.
Ты наверняка спросишь: «А почему бы не научить сами бэкенд-сервисы записывать каждый SQL-запрос в лог?» В масштабах Airbnb эта идея разбивается об устройство инфраструктуры. Сотни кластеров MySQL обслуживают разношёрстный флот микросервисов на Java, Python и Ruby. Если заставить команды поддерживать кастомные библиотеки логирования сразу на трёх языках, разработка утонет в рутине, а запись логов внутри приложений или ядра СУБД добавит лишние миллисекунды задержки к каждому запросу клиента.
Архитектура перехвата через ProxySQL, очистка данных и хитрость с идентификаторами записей
Раз трогать прикладной код микросервисов и нагружать ядро базы нельзя, инженеры Airbnb решили перехватывать трафик на сетевом уровне. В их архитектуре все обращения от приложений к кластерам MySQL уже проходят через единый прокси-слой — ProxySQL. Если включить запись событий на прокси, сервисы на Java, Python и Ruby даже не заметят перехвата, а серверы баз данных не потратят лишних тактов процессора на профилирование.
Конвейер записи и подготовки трафика работает в четыре шага:
- Захват на прокси. Для записи профиля нагрузки кластера в конфигурации ProxySQL включается логирование событий через параметр
mysql-eventslog_filename, фиксирующий поток SQL-вызовов без вмешательства в бизнес-логику. - Нарезка и выгрузка через Log Mover. Чтобы не переполнять локальные диски прокси, рядом работает фоновый сайдкар-процесс
Log Mover. Он вычитывает журналы запросов, упаковывает их в изолированные пятиминутные файлы по каждому кластеру и асинхронно отправляет в облачное хранилище (S3 и HDFS). Похожий приём мы разбирали в статье о том, почему в Airbnb сохранили доставку конфигураций через sidecar-контейнер для многоязыкового флота сервисов. - Маскирование данных и сборка транзакций. Перед сохранением скрипт санитизации очищает персональные данные (
PII masking) в параметрах запросов, чтобы личные сведения клиентов не попали на тестовые стенды. Одновременно конвейер собирает разрозненные вызовы в цепочки транзакций, сохраняя исходный порядок их фиксации (commit order). - Перезапись идентификаторов вставки. Здесь всплывает тонкая инженерная ловушка. В продакшене два параллельных потока почти одновременно выполнили
INSERT, и база присвоила первому заказу номер1001, а второму —1002. При повторе лога на тестовом стенде второй поток может прибежать к диску чуть раньше первого и забрать себе номер1001. Если следом идётUPDATEилиSELECT, ищущий связанные записи по исходному ID, цепочка транзакций рассыплется с ошибками внешних ключей.
Чтобы обойти рассинхронизацию, в Airbnb сохраняют фактическое значение last_insert_id, которое вернула боевая база при записи. Когда раннер воспроизведения читает команду вставки, он с помощью флага --rewrite-last-insert-id=true динамически переписывает запрос INSERT, принудительно закрепляя за новой строкой исторический идентификатор. Так все последующие чтения и обновления находят свои сущности.
Репетиция миграции на MySQL 8.0, планирование ёмкости и инженерная цена подхода
Когда пятиминутные чанки очищенных логов готовы, начинается проверка. Инженеры разворачивают снапшот боевой базы, снятый строго в момент начала записи трафика (T0), на изолированном тестовом кластере с новой версией СУБД без доступа во внешнюю сеть. Затем утилита replay-runner подключается к стенду (--target=staging-db:3306), забирает логи из --log-source=s3://db-logs/cluster-01/ и проигрывает трафик в реальном времени (--speed=1.0), с ускорением (2x) или со стрессовым QPS, сверяя задержки P95 и P99, загрузку CPU и ошибки с эталоном.
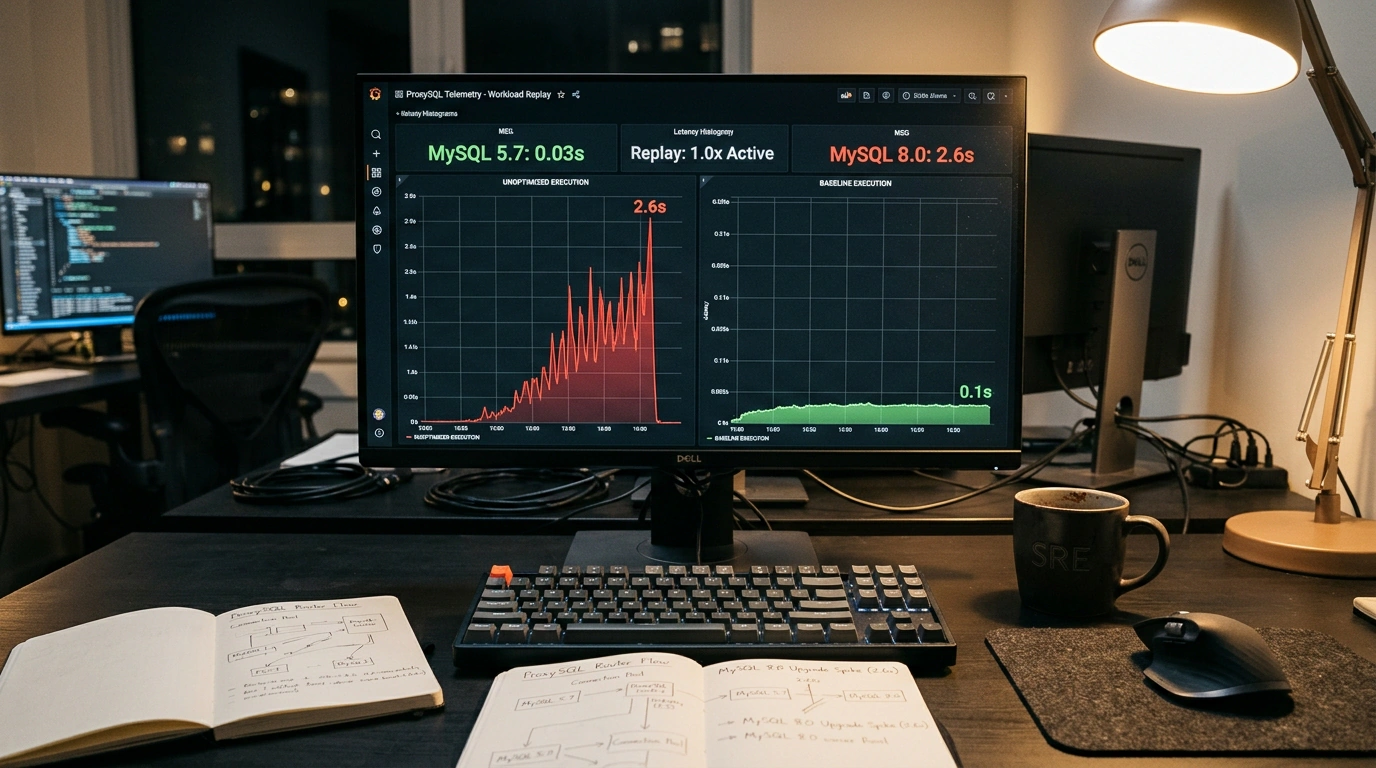
Ценность такого подхода ярко проявилась при подготовке миграции кластеров Airbnb с MySQL 5.7 на MySQL 8.0. Во время прогона реального трафика на восьмой версии конвейер выявил аномалию, которую пропустили синтетические тесты: рабочий запрос, стабильно выполнявшийся на MySQL 5.7 за 0,03 секунды, на новой версии стал занимать 2,6 секунды. Разбор плана выполнения показал, что из-за различий в алгоритмах сортировки и недетерминированного порядка строк оптимизатор MySQL 8.0 перестал эффективно обрабатывать эту выборку. Поймав скачок до 2,6 секунды на стенде за недели до релиза, инженеры заранее поправили запрос и предотвратили аварию.
Вторая выгода конвейера — планирование ёмкости (capacity planning). Команда прогнала реальный профиль нагрузки, увеличив долю пишущих запросов на 80%, чтобы заранее увидеть потолок дисков и оценить запас прочности кластера (headroom). О том, как один тяжёлый запрос способен положить узлы хранения при нормальном среднем QPS, рассказывает наш разбор эволюции защиты СУБД от каскадных перегрузок в высоконагруженных сервисах.
Конечно, за такую точность приходится платить инженерную цену, и важно трезво взвесить ограничения метода:
- Привязка к снапшоту. Если дамп тестовой базы рассинхронизирован с моментом старта записи логов хотя бы на пару минут, запросы обновления начнут обращаться к ещё не созданным или уже изменённым строкам.
- Компромисс с автоинкрементом. Принудительная подмена
last_insert_idисключает проверку нативного генератора первичных ключей новой версии СУБД под конкурентной нагрузкой. - Затраты на хранение и очистку. Перекачка пятиминутных логов в облако требует ресурсов и надёжных фильтров маскирования, чтобы в тестовый контур не попали чувствительные данные.
Глядя на систему Airbnb с сотнями кластеров и сайдкарами, легко подумать, что без огромного отдела инфраструктурной разработки к такому подходу не подступиться. Но тебе не нужно строить космический корабль и делать всё идеально с первой же попытки. Даже если перед следующим обновлением базы ты просто соберёшь за пять минут реальные читающие запросы через прокси, очистишь параметры от личных данных и прогонишь их на развёрнутой из бэкапа копии — ты уже снимешь повязку с глаз, увидишь реальные планы выполнения на живых таблицах и перехватишь сюрпризы оптимизатора до того, как их заметят пользователи.