Открой панель мониторинга во время наплыва посетителей — и увидишь картину, способную сбить с толку любого инженера. На графиках всё спокойно: штатный Horizontal Pod Autoscaler (HPA) в Kubernetes следит за кластером, средняя загрузка процессора держится около 70%, а правила выделения ресурсов соблюдены. Но в эту же секунду люди, открывающие сайт или приложение, упираются в стену ошибок 503 Service Unavailable и 504 Gateway Timeout. Две несовместимые картины существуют одновременно: по отчётам оркестратора масштабирование идёт по плану, а для живого пользователя сервис лежит.
Меня зацепил разбор этого расхождения в канале DevOps&SRE Library. Автор статьи — исследователь распределённых систем Дэвид Моррисон (drmorr) из Applied Computing Research Labs (ACRL). Во второй части цикла о пяти показателях автоскейлинга Kubernetes (после разбора своего коллеги Иэна о подсчёте сожжённых денег на простаивающих узлах) Моррисон предложил взглянуть на надёжность глазами клиента и ввёл метрику MTSS (Mean Time to Stop Sucking — среднее время до момента, когда сервис перестаёт работать отвратительно). Разберёмся, почему автоскейлеры опаздывают к началу пика, как измерить длительность деградации и какие настройки HPA и KEDA сжимают это окно.
Ловушка запаздывающих метрик и слепая зона старта подов
В основе автоскейлинга лежит баланс между ценой и надёжностью, который Моррисон сравнивает с монеткой: «орёл — дёшево, решка — не сломалось». Сделать инфраструктуру дешёвой легко — выключи серверы. Сделать её неуязвимой тоже просто: выдели под каждый под гигантский инстанс c7i.48xlarge, вот только финансовый директор не обрадуется счёту. Нам же нужно расти под нагрузкой (scale up) без просадки качества и сжиматься обратно (scale down), не обрывая сессии клиентов.
Почему при росте нагрузки автоскейлер по CPU и памяти опаздывает? Посмотрим на сквозной сценарий из разбора Applied Computing. На веб-сервис обрушивается поток запросов. Средняя утилизация CPU держится на 70%, но входящая очередь HTTP-запросов переполняется мгновенно. Даже если на серверах кластера есть свободные ресурсы и нужно лишь поднять 4 новых пода, пользователи получают 45-секундный всплеск ошибок 504 Gateway Timeout. Сначала сборщик метрик усредняет показатели контейнеров, затем контроллер HPA запускает цикл проверки (раз в 15 секунд по умолчанию) и после пробития порога в 70–80% создаёт 4 реплики. Пока контейнеры инициализируют рантайм, подключаются к базе и проходят проверку готовности readiness probe, старые поды отбивают запросы по таймауту.
Когда же места на текущих серверах нет, задержка вырастает до десятков минут. Моррисон приводит показательную цепочку: главную страницу проекта обслуживают 2 пода на одном узле t3.medium, и ссылка попадает на главную популярного портала. Поды захлёбываются, отдавая миллионы ошибок 503 Service Unavailable. HPA создаёт новые реплики, но они висят в статусе Pending, так как узел t3.medium полон. Автоскейлер запрашивает машины у облака (для дефицитных GPU-инстансов ожидание занимает 10 минут). Затем от 5 минут уходит на подготовку ноды: установку обновлений ОС и настройку окружения (prod или staging) до старта kubelet. И когда под запущен, сервис на Java тратит ещё 5 минут на прогрев JIT-компилятора и загрузку кэша в память.
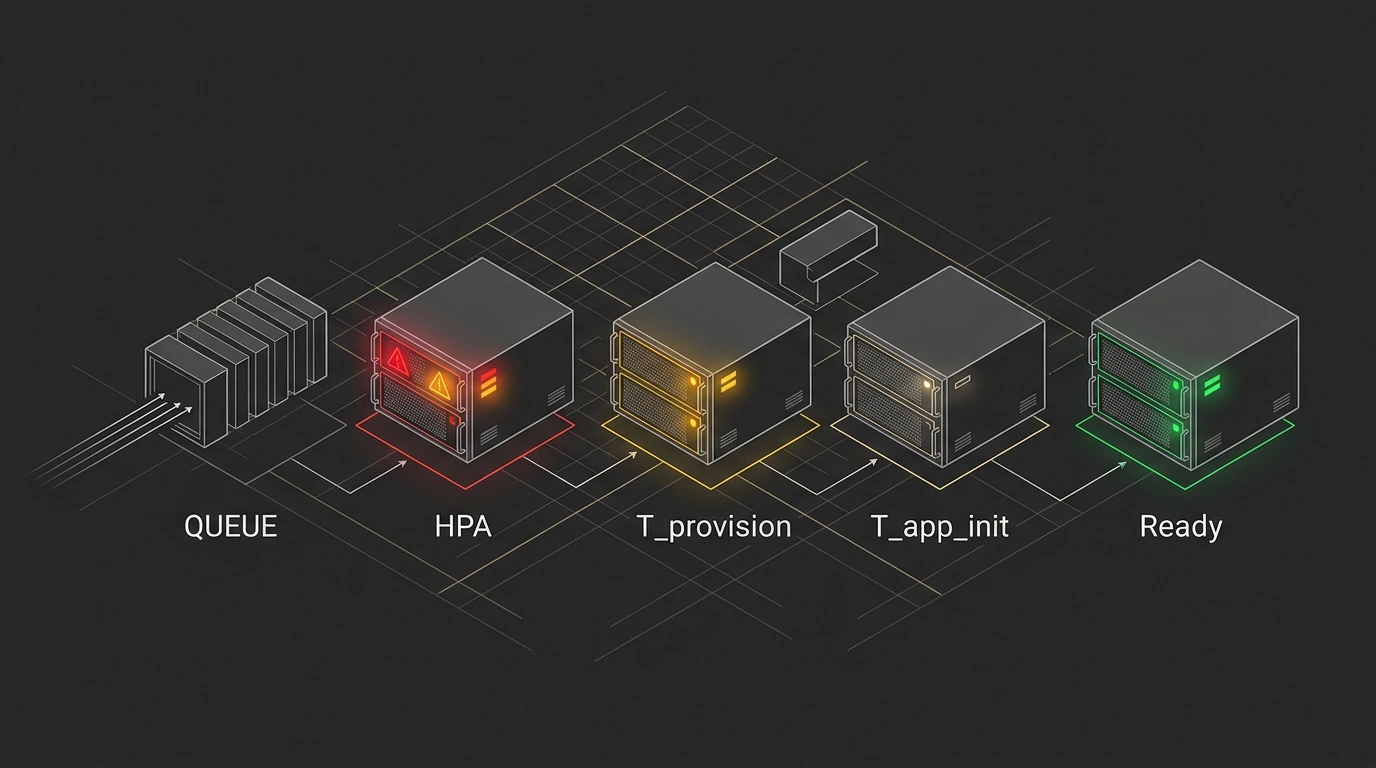
Из чего складывается окно отказа MTSS на пути запроса
В большинстве команд отслеживают лишь внутреннюю метрику планировщика — переход пода из Pending в Scheduled. В провижинере узлов Karpenter для этого есть альфа-метрика karpenter_pods_unbound_time_seconds, фиксирующая время от создания пода до привязки к ноде. Но она отражает только скорость выдачи виртуальной машины облаком — малую долю того, что волнует клиента.
Представь супермаркет в час пик, где у единственной кассы выстроилась очередь до входа. Мерить автоскейлинг по karpenter_pods_unbound_time_seconds — всё равно что засекать, за сколько секунд администратор назначил четырёх кассиров на четыре пустые кассы. В отчёте людей распределили за полминуты! Но для покупателя касса закрыта: кассиру нужно включить терминал, загрузить программу и заправить ленту. Пока над кассой не загорится зелёный свет и сканер не пробьёт первый товар, очередь не сдвинется.
Метрика MTSS включает секундомер со стороны покупателя. Она измеряет интервал от момента, когда качество сервиса падает ниже целевого уровня SLO (Service Level Objective — допустимого порога ошибок 5xx и задержек внутри соглашения SLA), до секунды, когда новые поды проходят readiness probe и возвращают показатели в норму. Фронтенд-метрики вроде First Contentful Paint или Mean Time to First Byte не помогут: не каждый сервис возвращает байты в браузер, и клиентский скрипт не видит, где застрял кластер.
Математически окно MTSS складывается из шести задержек:
MTSS = T_detect + T_provision + T_node_prep + T_pull + T_app_init + T_readiness
T_detect— обнаружение всплеска сборщиком метрик и циклом опроса HPA (15 секунд);T_provision— выделение виртуальной машины в облаке (AWS, GCP или Azure);T_node_prep— установка патчей ОС, настройка узла и стартkubelet;T_pull— скачивание образов контейнеров из реестра;T_app_init— стартinit-контейнеров, сайдкаров и прогрев рантайма;T_readiness— прохождениеreadiness probe, открывающее под для трафика.
Сумма этих шести отрезков и превращается либо в 45 секунд ошибок 504 Gateway Timeout при старте 4 подов на готовых узлах, либо в 15-минутный простой при холодном заказе нод.
Инженерные рычаги ускорения HPA и KEDA и их ограничения
Понимание звеньев цепочки MTSS даёт платформенной команде конкретные рычаги для сокращения времени отклика:
- Быстрый провижинер узлов и готовые образы (Pre-baked AMI). Замена Kubernetes Cluster Autoscaler на Karpenter (с поддержкой AWS, Azure и GCP) ускоряет выделение машин
T_provision. А чтобы убрать 5-минутную паузуT_node_prep, обновления ОС и настройки запекаются заранее в образ виртуальной машины. - Короткий цикл опроса и опережающие метрики в KEDA. Как иронизирует Моррисон, все знают, что нельзя масштабироваться по CPU, и все продолжают масштабироваться по CPU. Переход на событийный автоскейлер KEDA (ранее незаменимый для масштабирования в ноль, хотя недавно эту функцию получил и HPA) позволяет ускорить опрос метрик, настроить
behavior.scaleUp.stabilizationWindowSecondsи привязать скейлинг к упреждающим сигналам: глубине очереди HTTP-запросов, входящему RPS или лагу брокера. Ранее мы разбирали пять опережающих метрик Kubernetes от ACRL и расчёт порогов лага перед запуском KEDA. - Масштабирование цепочки сервисов и разгрузка старта пода. В цепочке
A → B → C → Dпоочерёдный скейлинг бесполезен: как только вырастетA, поток запросов положитB, затемCиD, а ошибки уйдут только после подъёмаD. Правильный ход — масштабировать всю цепочкуA → B → C → Dодновременно при росте нагрузки наA. А чтобы сжатьT_app_initбез правок кода, сократи число тяжёлыхinit-контейнеров и sidecar-прокси (если их меньше десяти — ты уже впереди большинства корпоративных кластеров).
Сопоставь время привязки пода к узлу (karpenter_pods_unbound_time_seconds) с моментом перехода в статус Ready. Разница покажет задержку скачивания образов, старта сайдкаров и прогрева приложения (T_pull + T_app_init + T_readiness).
Вместе с тем у этих инструментов есть жёсткие условия и ограничения:
- Цена сквозной трассировки. Сводная цифра MTSS покажет факт проблемы, но не назовёт виновника. Чтобы разложить задержку по этапам, нужно связать пять источников (приход запроса через service mesh, метрики узла, решение HPA, ответ провижинера нод и старт приложения) через распределённую трассировку (distributed tracing), что увеличивает расходы на телеметрию.
- Миф о предиктивном автоскейлинге. Многие пытаются обойти оптимизацию холодного старта, внедрив прогнозирующий автоскейлер. Звучит эффектно (и почти гарантирует автору повышение, даже если система не заработает), но предсказывать внезапные пики крайне сложно, а при 10-минутном старте нод и Java-подов любая погрешность прогноза ведёт к сбою. Предиктивные алгоритмы работают только на цикличной нагрузке через проверенных вендоров, но не заменяют быстрый старт подов.
Вывод прост: перестань оценивать автоскейлинг по графикам CPU в 70% и скорости привязки пода к ноде. Измеряй сквозное окно ошибок 504 и 503 до прохождения readiness probe, переводи HPA и KEDA на длину очереди запросов, запекай обновления в образы узлов и убирай лишние сайдкары. Вся эта инженерия нужна не ради красивых цифр в отчётах: хорошая инфраструктура обязана оставаться незаметной для человека по ту сторону экрана, чтобы в минуту пикового наплыва сервис мгновенно открывал страницу, а команда сохраняла спокойствие и уверенность в своей архитектуре.