В прикладном тесте работы с командной строкой Terminal-Bench 4.1 легковесная модель gemini-4-hydrogen набрала 57% против 18,2% у своей предшественницы Gemini 3.8 Flash — более чем трёхкратный рывок в консольных задачах при сокращении выдуманных фактов свыше чем в пять раз. Для меня эта цифра из отчёта Google стала главным сюрпризом релиза: она ломает старое правило, по которому за быстрый отклик ты всегда расплачивался поверхностной логикой, а ради вдумчивого анализа приходилось ждать неповоротливую старшую модель.
Двенадцатого ноября Google отправила бренд Flash на покой в четвёртом поколении нейросетей и сделала Hydrogen базовым движком сразу во всех ключевых продуктах — от поискового режима Google AI Mode и приложения Gemini до Google AI Studio и среды агентной разработки Google Antigravity. Разберёмся, почему компания заменила привычную линейку Flash на Hydrogen в поиске и как компактная модель справляется со сложными задачами без потери скорости.
Таблица элементов вместо «вспышки»: место Hydrogen в семействе Gemini 4
Отказ от слова Flash — не просто смена вывески ради химической метафоры. В четвёртом поколении Google выстроила иерархию по таблице Менделеева, где вес элемента отражает характер нагрузок. На верхнем этаже работают тяжёлые флагманы: защищённый Gemini 4 Carbon и высокоточный Gemini 4 Argon, которые берут на себя глубокое архитектурное планирование, сложную математику и долгие автономные циклы.
Прежние «лёгкие» модели работали как торопливый курьер: быстро приносили короткую справку, но теряли нить рассуждений на цепочке из пяти-шести шагов. Как указано в архитектурном анонсе Google, модель Hydrogen (водород — самый лёгкий элемент) спроектировали не как урезанную копию для черновиков, а как скоростного исполнителя для агентных цепочек, кодинга и живого поиска.
При этом модели оставили полноценную «оперативную память» старших версий — единое контекстное окно на 1 000 000 токенов с возможностью генерировать длинный вывод до миллиона токенов через режим продолжения (continuation). Ты можешь целиком загрузить в диалог объёмную папку с документацией и кодом без нарезки на части. Тариф в Gemini API и AI Studio фиксирован на всём диапазоне окна: $1.50 за миллион входных и $7.50 за миллион выходных токенов, а за счёт точного следования инструкциям партнёры Google зафиксировали снижение расхода токенов на 12–23% в задачах обработки данных и графов.
Четыре передачи для мозга: бюджет размышлений и дуэль с Argon
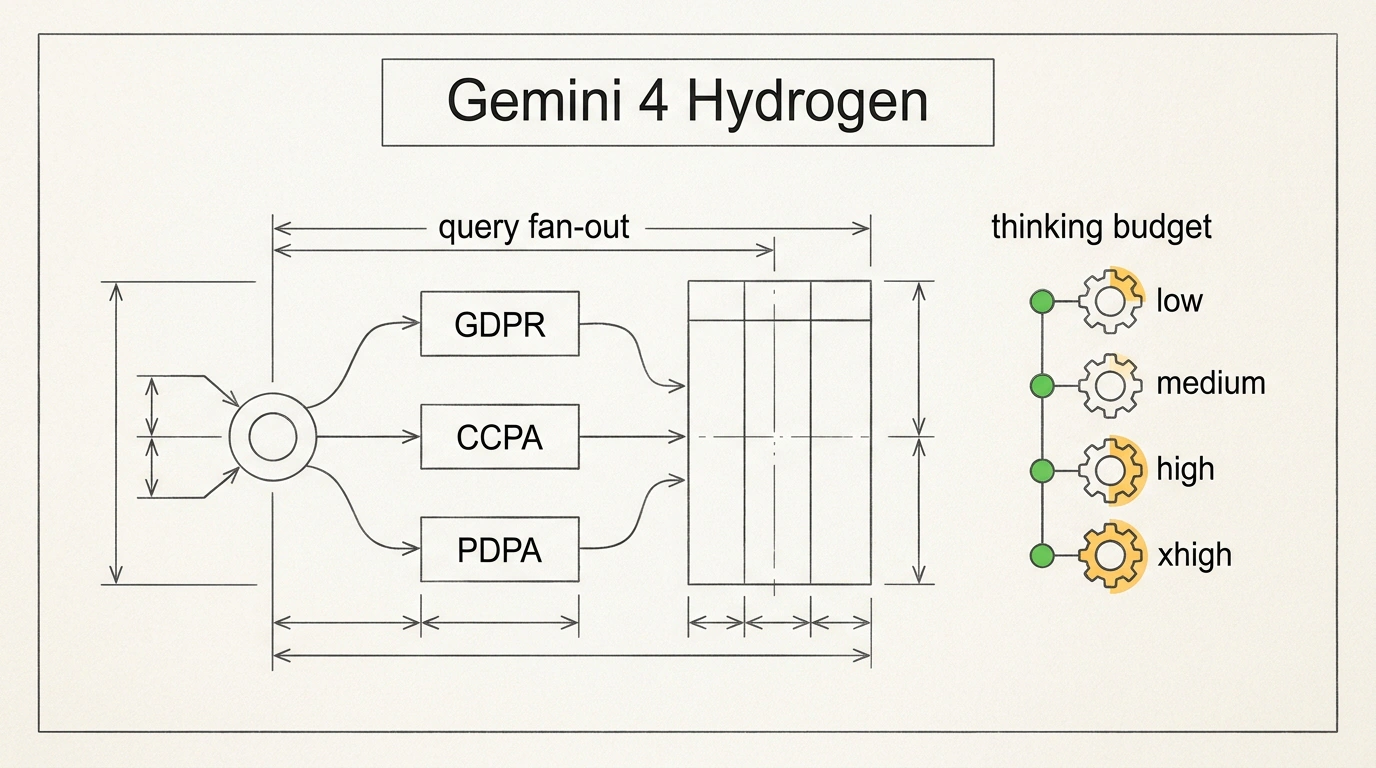
Ты резонно спросишь: как одна и та же лёгкая модель одновременно мгновенно отвечает в поиске и тягается с тяжёлыми сетями в логике? За это отвечает настраиваемый бюджет размышлений (thinking budget), который работает как коробка передач в автомобиле. Тебе не нужна пониженная передача внедорожника для поездки по ровному асфальту, но на крутом подъёме без неё не обойтись.
В интерфейсе AI Studio и API доступны четыре дискретные ступени размышлений: low, medium, high (по умолчанию) и режим повышенной строгости xhigh. Задержка до появления первого токена (TTFT, Time-To-First-Token) у новинки в 2,5 раза ниже, чем у Gemini 3.8 Flash при сопоставимом контексте. А на верхних ступенях включается глубокая проверка: в независимом индексе Artificial Analysis Intelligence Index модель Hydrogen на стандартном уровне набирает 51 балл, опережая тяжёлый Gemini 4 Argon (50 баллов), а на xhigh вырастает до 54 баллов.
Сравним оба подхода на реальной поисковой задаче: сопоставить регуляторные требования к хранению биометрических данных в ЕС (GDPR), Калифорнии (CCPA) и Сингапуре (PDPA) и собрать штрафы за нарушения в единую таблицу. На Gemini 4 Argon построение развёрнутого ответа занимает 14,2 секунды из-за долгого перебора дерева рассуждений. А Gemini 4 Hydrogen в Google AI Mode со ступенью medium выдаёт первичную структуру карточки уже через 1,8 секунды и за 5,6 секунды формирует полную сводную таблицу с валидацией статей законов, сохраняя 100% точности ссылок на регуляторные акты.
Но у лишней глубины есть прямая цена. В тесте практика автоматизации Джулиана Голди сборка недельного отчёта по воронке консалтингового агентства на ступени low заняла 8 секунд и потребовала 1 456 токенов. Тот же промпт на ступени xhigh считался 15 секунд и сжёг 3 277 токенов — счёт вырос более чем вдвое на рутинной сводке, которую первый режим и так собрал без ошибок.
Веерный поиск в Google AI Mode: как собираются ответы и таблицы на лету
Именно способность быстро сводить воедино законы и цифры трёх юрисдикций позволила главе поиска Google Робби Стейну сделать Hydrogen моделью по умолчанию в Google AI Mode для всех пользователей. Когда ты вводишь многосоставный запрос — даже с опечатками и разговорными формулировками, — запускается веерное ветвление (query fan-out).
Представь схему метро, где твой вопрос — центральная станция. Вместо одного линейного поиска Hydrogen разбивает задачу на отдельные ветки (правила GDPR в ЕС, нормы CCPA в Калифорнии, требования PDPA в Сингапуре и сетки санкций) и параллельно сканирует веб-страницы, таблицы и изображения по каждому направлению. В результате ответ со ссылками и готовой таблицей собирается без задержки интерфейса. Для владельцев сайтов это означает простое правило: поисковый ИИ забирает в сводки те страницы, где сразу под заголовком даётся чёткий ответ в пару предложений, а фактура разложена в аккуратные таблицы.
Архитектор и спринтер в одной упряжке: роутер Orchestrator в Google Antigravity
В среде агентной разработки Google Antigravity модель работает как самостоятельно, так и через динамический роутер Orchestrator, который объединяет планирование флагманов со скоростью водородного ядра:
- Планировщик (Argon или Carbon): открывает проект в режиме чтения, разбирает архитектуру и составляет пошаговый план.
- Исполнитель (Hydrogen): пишет и правит код по плану, ставит пакеты, прогоняет тесты в терминале и запускает браузерного агента-проверяющего.
- Возврат при сложностях: если исполнитель упирается в нетривиальный сбой, роутер возвращает задачу старшей модели для корректировки плана.
По замерам Google, связка Orchestrator сохраняет точность решения задач на уровне Carbon, но экономит 24% квоты запросов и работает на 19% быстрее. В практическом тесте Голди этот тандем за 9 минут написал и проверил в браузере интерактивный портал онбординга из трёх файлов на 3 800 строк кода с нулём ошибок в консоли, а одиночная Hydrogen за 2 минуты 11 секунд починила сломанный репозиторий скоринга заявок, доведя прохождение тестов с нуля до 7 из 7.
В Google AI Studio и API не оставляй дефолтный уровень high для простых операций: переключай шаблонные сводки и сортировку писем на low или medium. А при сборке проектов в Antigravity держи одну задачу в рамках одного чата и добавляй в конец запроса проверку результата встроенным браузерным агентом.
Где скорость пасует перед глубиной: честные границы и правила маршрутизации
Несмотря на 96,7% честности во внутренних агентных тестах, снижение лишних правок кода на 81% и рост защиты от скрытых инъекций (indirect prompt injection) в 2,3 раза, Hydrogen остаётся спринтером, а не математиком-теоретиком. Если растянуть диалог разнородными поручениями свыше 40% окна контекста, точность удержания деталей снижается.
Чтобы выжать максимум из линейки Gemini 4, распределяй задачи по уровням:
- Уровень
lowиmedium: веб-поиск, сборка сравнительных таблиц (как в кейсе с GDPR, CCPA и PDPA), классификация данных, форматирование и быстрые итерации кода. - Уровень
highиxhigh: отлов тонких багов (вроде состояния гонки при двойном клике по форме) и вычитка длинных документов до миллиона токенов. - Модели Argon и Carbon: глубокие математические доказательства, нестандартные многоуровневые алгоритмы и проектирование сложных систем с нуля.
Переход от Flash к Gemini 4 Hydrogen даёт тебе вместо компромисса между «быстро, но поверхностно» и «умно, но долго» один гибкий инструмент, где скорость и глубина проверки настраиваются одним регулятором под цену конкретной задачи.