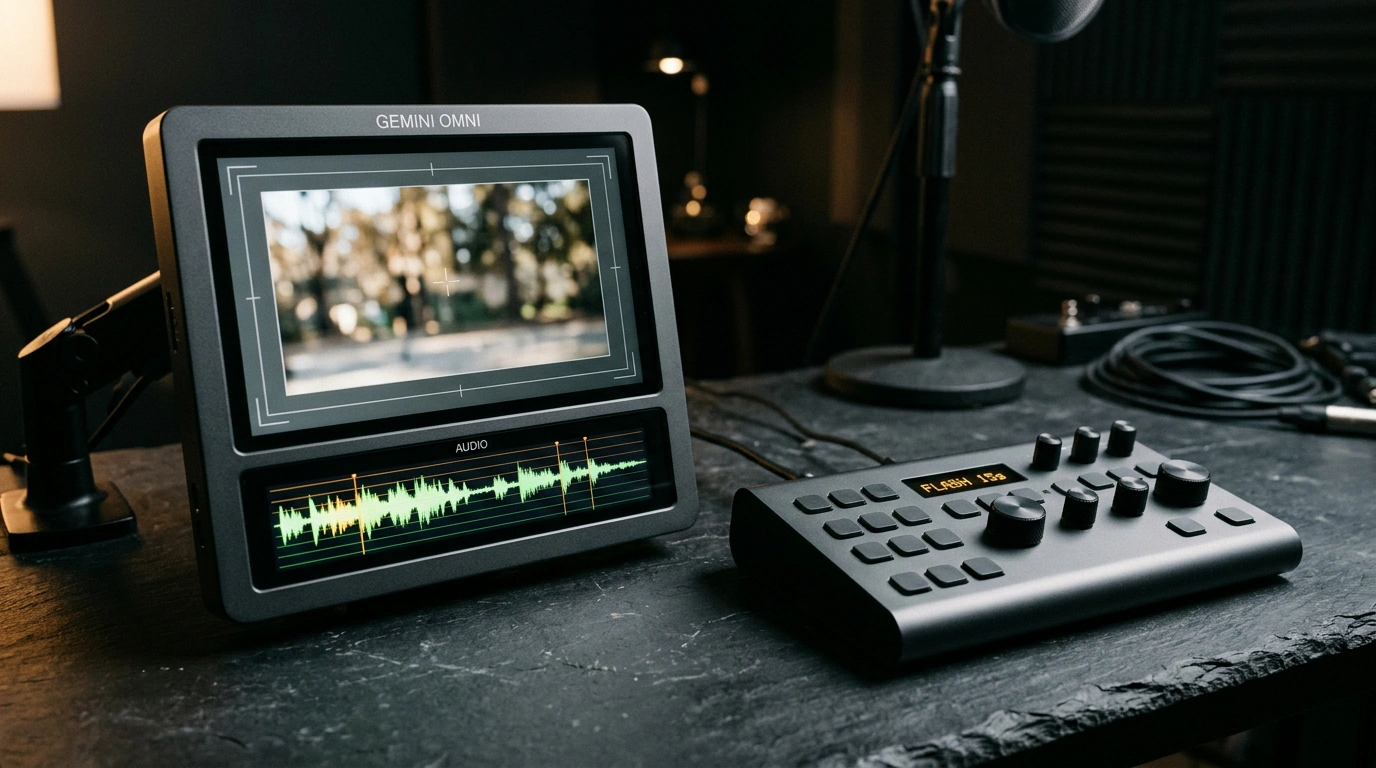
Открываешь вечером видеоредактор ради короткого проморолика для кофейни, кладёшь на дорожку сгенерированный нейросетью кадр и вручную подгоняешь под него чужие записи шума воды. Картинка живёт отдельно, звук запаздывает, а просьба чуть приглушить свет в зале приводит к тому, что в новом дубле меняются и чашка, и лицо бариста. С выходом Gemini Omni 1.2 Flash от Google DeepMind я проверил, насколько в общедоступной версии выросло качество видео и синхронизации звука, и можно ли собрать рекламную сцену без внешней озвучки и перегенераций с нуля.
Выход в открытый доступ и лидерство на арене LMSYS
Долгое время считалось, что видеосети годятся лишь для немых зацикленных фрагментов в закрытых превью, а сложный ракурс сразу выдаёт склейку. С 5 ноября Google DeepMind перевела Gemini Omni 1.2 Flash в статус общедоступного релиза (General Availability) в сервисах Google Vids и Flow.
В слепых сравнениях LMSYS Arena (Text-to-Video) модель заняла первое место с результатом 1541 балл, обойдя версию Omni 1.1 на 27 пунктов, а также возглавила зачёт Image-to-Video и вошла в тройку лучших в редактировании видео. При плавных пролётах камеры в кадре сохраняются лица, одежда, фирменные цвета и надписи на упаковках.
Пятнадцать секунд: как лишние пять секунд меняют драматургию
Прежний потолок упирался в 10 секунд, чего хватало только на один жест. Теперь длина клипа выросла на 50% — до 15 секунд, с шагом выбора в одну секунду от 3 до пятнадцати в пропорциях 16:9, 9:16 или 1:1.
Пять дополнительных секунд превращают случайный кадр в трёхактную историю с завязкой, действием и финалом. Возьмём 12-секундный рекламный план, где бариста варит эспрессо: в один непрерывный дубль без рваных склеек помещаются пролив напитка, работа с паром и подача чашки на стойку.
Звук и картинка в одном цикле: от шипения пара до диалогов
Когда видео и звук делают две разные сети, это напоминает озвучку немого кино вслепую из соседней комнаты. В Gemini Omni 1.2 Flash картинка и аудио рождаются совместно в едином мультимодальном диффузионном цикле — об устройстве этого словаря токенов мы говорили в разборе нативной мультимодальности Gemini Omni Flash 1.2.
В сцене с кофемашиной модель точно в такт движениям рук создаёт шипение струи пара, стук холдера о нокбокс и звон керамической чашки. Так же синхронно строится речь с артикуляцией губ для нескольких героев сразу: в деморолике Google четыре персонажа в оранжерее спорят с орхидеей о расцветке, удерживая мимику и голоса по референсам (о соседних речевых технологиях компании читай в статье про синтез речи в Gemini 3.8 Flash TTS).
Пошаговая правка текстом без пересборки дубля
Режим многошагового редактирования (Multi-turn Editing) работает как диалог с осветителем на площадке после удачного дубля. Пишешь запрос «сделай освещение неоновым в стиле киберпанк» — и нейросеть меняет палитру кофейни, сохраняя всю хореографию движений бариста и звук. Простыми фразами меняются погода, фон или пропорции кадра, а внешность и движение закрепляются фотореференсами и трёхсекундным видео.
Сначала отшлифуй сцену текстовыми правками в черновом качестве 360p или 720p (около $0.07 за секунду), и только готовый дубль переводи апскейлом в 1080p или 4K.
Ждать от алгоритма каскадёрских чудес всё же не стоит: он теряется на быстром спортивном экшене вроде баскетбола, резких сменах сцен и хаотичной физике аварий, а мелкий текст на быстрых объектах к финалу может смазываться. Кроме того, файлы помечаются невидимым знаком SynthID, что важно учитывать в клиентских проектах. Зато в предметной съёмке, плавных пролётах и диалогах модель бережёт часы монтажа.