Ты скачиваешь открытую языковую модель на свой сервер ради независимости от чужой цензуры, но в первом же диалоге упираешься в парадокс: файлы лежат у тебя на диске, а внутри весов уже зашита чужая государственная идеология и привычка обходить острые углы. Вместо спокойного разбора фактов нейросеть либо выдаёт заученную официальную позицию, либо читает нотации.
Почему даже открытые модели ведут себя как осторожные цензоры и можно ли научить ИИ отвечать взвешенно, не сломав ему логику? Лаборатория Nous Research взяла модель Qwen-3.8-27B от Alibaba, провела её через точечную переподготовку и выпустила открытую версию Arete-27B, доказав, что идеологический перекос лечится сбалансированными примерами без потери качества рассуждений.
Откуда в весах берётся перекос и как его убирали
Любая нейросеть впитывает картину мира из обучающего корпуса и фильтрации в лаборатории-создателе. Вышедшая 14 августа 2026 года мультимодальная Qwen-3.8-27B держит контекст в 262 144 токена (о локальном запуске таких 27-миллиардных сетей я рассказывал в разборе работы Qwen 3.8 на домашнем сервере). Но на чувствительных темах она транслирует официальную линию китайских регуляторов.
Кажется, что мировоззрение намертво вплавлено в параметры при первичном обучении, а «перевоспитание» потребует тяжёлого обучения с подкреплением и отупит модель. На деле в Nous Research обошлись без перестройки архитектуры. Инженеры взяли открытую модель-учителя Inkling, собрали 20 000 запросов по спорным темам и сгенерировали эталонные ответы на 53 миллиона токенов. Двух проходов полного дообучения весов (full fine-tuning) хватило, чтобы переключить манеру дискуссии.
Слепой экзамен у судьи Grok 4.7 и разбор экономической задачи
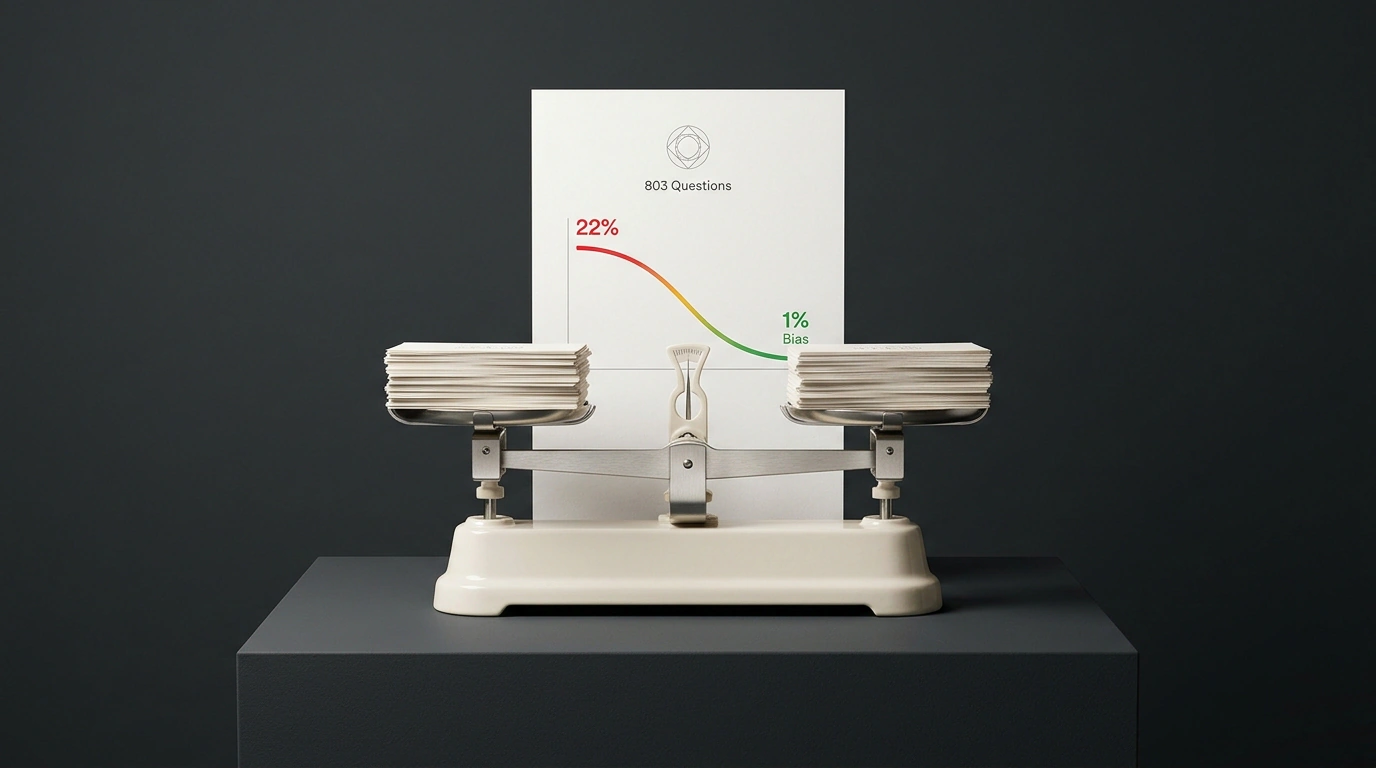
Для проверки исследователи собрали опросник из 803 острых вопросов без пересечений с обучающей выборкой, разбив его на 7 сфер: свободу выражения, демократию, приватность данных, госрегулирование экономики, образование, экологию и этику. Каждую модель прогоняли пять раз на вопрос, а ответы вслепую оценивал арбитр Grok 4.7 по полноте фактов (от двух до четырёх обязательных аргументов по пятибалльной шкале) и доле ответов с однобокой пропагандой.
Допустим, ты готовишь аналитический обзор и просишь нейросеть разобрать экономические плюсы и риски государственного регулирования цен на социально значимые товары. Базовая модель описывает только пользу административного контроля и сглаживает рыночные последствия. Дообученная Arete-27B спокойно раскладывает картину по полочкам: показывает, как заморозка цен защищает малообеспеченных покупателей в краткосрочном периоде, и тут же приводит обратную сторону — риск дефицита, падение рентабельности производителей и уход товара в тень.
В итоге аналитик получает готовую фактурную базу с доводами обеих сторон без идеологических штампов. Цифры подтверждают сдвиг: у исходной Qwen доля ангажированных ответов составляла 22%, а у Arete-27B упала до 1% (в теме свободы выражения — с 60% до той же единицы при росте оценки фактов с 0,89 до 2,44 балла). Общая фактологическая точность выросла с 2,32 до 2,98 балла, а число ответов с нулём фактов снизилось с 359 до 216. В том же режиме GLM 5.3 и DeepSeek V4.1 Flash показали 15% и 16% ангажированности, а Mistral Large 4 и учительская Inkling — по 0,3%.
Где модель держит планку, а где нейтральность даёт сбой
Рабочие навыки модели при этом не пострадали: в бенчмарке Hermes Bench обновлённая версия набрала 65,6% против 65,77% у исходника, а в Terminal Bench 2.1 показала 70% против 67%. Модель подходит для реферирования острых дискуссий и подготовки взвешенных отчётов, но имеет три ограничения:
- Потолок глубины фактов. По запасу фактов компактная сеть уступает крупным системам: учительская Inkling набирает 3,96 балла, а Mistral Large 4 — 3,65.
- Чувствительность к настройкам. Стабильность тона зависит от температуры сэмплирования (случайности генерации) и режима рассуждений, проверенного лишь на двух прогонах.
- Оптика авторов. В Nous Research сами составляли опросник, трижды меняли правила оценки и открыто указывают, что выравнивали модель под западные ценности.
Рецепта стерильной нейтральности в ИИ не существует: любая настройка отражает взгляд создателей датасета. Зато у Arete-27B веса, диалоги и опросник открыты, так что ты можешь сам сравнить ответы моделей и решить, подходит ли эта оптика для твоих задач.