Двести микросекунд — величина, которую в веб-разработке принято считать погрешностью измерения. Кажется, что если твой балансировщик нагрузки добавляет к сетевому вызову всего 200 микросекунд, трогать его архитектуру — чистое безумие. Но в отчёте ведущего инженера Zalando Конора Галлахера (Conor Gallagher) по системе Product Read API (PRAPI) именно эта микроскопическая задержка на потоке в 1 000 000 запросов в секунду (RPS) годами вызывала трудноуловимые пики времени ответа и заставляла компанию переплачивать больше тысячи долларов каждые сутки.
Меня в этой истории зацепил парадоксальный разворот: почему крупнейший европейский онлайн-ритейлер, работающий на 25 рынках и создавший собственный опенсорсный маршрутизатор Skipper, вдруг решил убрать его с главного внутреннего маршрута и перенести балансировку прямо внутрь процесса приложения? Давай проследим всю цепочку решений команды — от математики параллельных запросов и побитовой сборки хэш-колец до теории очередей — и разберёмся, когда такой шаг окупается, а когда превращается в дорогую ловушку.
Ловушка общего ingress-шлюза: как сотня параллельных вызовов раздувает хвостовую задержку
Глазами покупателя витрина интернет-магазина работает просто: открываешь каталог или корзину, и экран за считаные миллисекунды заполняется карточками кроссовок и курток. Под капотом у Zalando за это отвечает система чтения каталога PRAPI, которая обязана отдавать данные за однозначное число миллисекунд (single-digit milliseconds), ведь любая заминка сразу бьёт по конверсии.
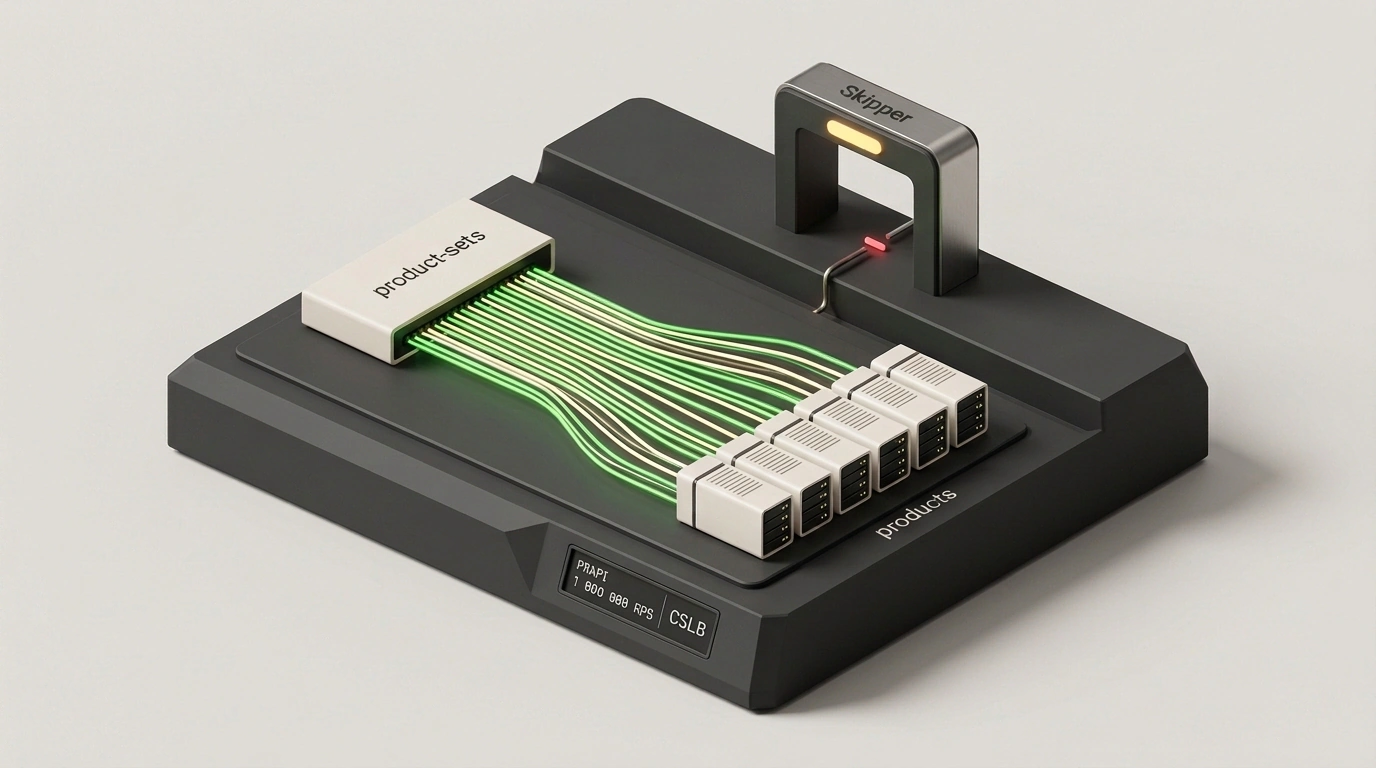
Архитектурно сервис разделён на два слоя. Фронтальный компонент product-sets принимает пачечные запросы (батчи) — например, подборку сразу из 100 товаров. Чтобы собрать ответ быстро, product-sets распаковывает пачку в 100 параллельных внутренних подзапросов (паттерн ветвления, или fan-out) к бэкенд-подам сервиса products. Каждый под products держит горячие карточки в собственной оперативной памяти (локальном кэше), а при промахе идёт за данными в облачную базу Amazon DynamoDB.
Изначально оба потока — и внешние одиночные запросы к API, и внутренний веер из сотни подзапросов между product-sets и products — шли через общий кластерный балансировщик Skipper. Для внешних одиночных GET-запросов он подходил идеально и обслуживает их до сих пор. Проблема крылась именно во внутренних батчах из 100 товаров.
Представь, что ты заказываешь сотню деталей для конструктора и отправляешь за ними стажёров в соседний корпус через одну общую проходную с турникетом. Даже если каждый проходит турникет за доли секунды, ты не начнёшь сборку, пока не вернётся самый последний, сотый стажёр. Если 99 человек проскочили мгновенно, а перед сотым на общей проходной застрял чужой погрузчик, вся твоя сборка встаёт на время этой заминки.
В распределённых системах время ответа пачечного запроса определяется самым медленным из ста параллельных сетевых прыжков (max(T_1, ..., T_100)). На масштабе сотни вызовов это било по сервису с двух сторон:
- Стократная уязвимость к шуму соседей: Skipper работает как общая инфраструктура кластера с глобальной конфигурацией. Любой всплеск у соседей давал батчу PRAPI стократный шанс поймать просадку хвостовых перцентилей (tail latency). Когда Skipper чихал, PRAPI сваливался с гриппом.
- Размытая ответственность при авариях: во время ночных инцидентов дежурные не могли понять, где искать причину спайков — в коде каталога или внутри общего маршрутизатора, которым управляла другая команда.
Вывод был очевиден: внешний трафик остаётся на Skipper, а внутренний fan-out нужно забирать внутрь вызывающего JVM-процесса product-sets. Такая схема называется клиентской балансировкой нагрузки (Client-Side Load Balancing, или CSLB): сервис сам знает адреса живых подов products и стучится к ним напрямую.
Побитовая идентичность хэш-колец: алгоритм xxHash64 и сотня виртуальных узлов против шторма в базе
Как только команда решила перенести маршрутизацию внутрь процесса, возникло жёсткое ограничение. В распределённом каталоге нельзя отправлять запрос за товаром № 42 на случайный сервер. Если все запросы за этим товаром приходят на под A, он один раз прочитает карточку из DynamoDB, положит в оперативную память и дальше будет отдавать за 1 миллисекунду.
Концептуальная 3D-модель кольца согласованного хэширования со 100 виртуальными узлами и алгоритмом xxHash64 для подов каталога Zalando.
Чтобы привязать товары к подам без центральной таблицы, используется кольцо согласованного хэширования (Consistent Hashing Ring). Представь круглый циферблат часов, размеченный на все значения 64-битного числа. Адрес каждого сервера пропускают через хэш-функцию и ставят отметку на ободе. При запросе за товаром его ID так же хэшируют и идут по часовой стрелке до ближайшей отметки сервера. Когда один сервер падает или добавляется новый, переезжает лишь малая доля ключей — около 1/N (где N — число подов), а остальной кэш остаётся на месте.
Теперь проследим логическую цепочку миграции:
- Если при плавном переключении часть трафика идёт через Skipper, а часть — напрямую через JVM-библиотеку, оба балансировщика смотрят на один и тот же пул подов
products. - Если их хэш-кольца разойдутся хотя бы на один бит, товар, который Skipper направлял на под
A, клиентская библиотека отправит на подB. - В итоге локальный кэш расколется надвое, процент попаданий в память рухнет, а нагрузка на чтение из Amazon DynamoDB удвоится.
Поэтому требовалась абсолютная побитовая копия алгоритма Skipper на Java. Модуль написали как автономную JVM-библиотеку без тяжёлых фреймворков. Единственной внешней зависимостью стала легковесная zero-allocation библиотека для хэш-функции xxHash64 (без лишних аллокаций памяти), а само кольцо и математику собрали на стандартной библиотеке JDK.
Для полного совпадения со Skipper каждый URL эндпоинта размещается ровно на 100 виртуальных позициях (virtual nodes) 64-битного кольца, чтобы нарезать круг на равномерные дольки без перекосов. При вызове библиотека хэширует ID товара и бинарным поиском находит ближайший узел по часовой стрелке.
Набор модульных тестов на каждой сборке проверяет, что для любого произвольного набора подов и ключей Java-реализация и алгоритм Skipper выбирают один и тот же эндпоинт. Во время канареечного запуска в продакшене доля попаданий в кэш (cache hit ratio) на обоих путях осталась идентичной.
Обнаружение подов без перегрузки Control Plane: реактивный Informer и двухсекундный дебаунс
Чтобы отправлять запросы напрямую, клиентская библиотека должна знать, какие поды products сейчас живы. В Kubernetes сетевые адреса подов хранятся в объектах EndpointSlice.
Первым подходом был периодический опрос Kubernetes API каждые несколько секунд (polling). Но в Zalando помнили прошлые аварии, когда приложения на старом кластерном фреймворке активно опрашивали API Kubernetes и своим совокупным потоком полностью укладывали управляющий контур кластера (Control Plane). Если сотни подов product-sets начнут независимо дёргать EndpointSlice по своим таймерам, любой сетевой всплеск превратится в DDoS-атаку на собственный кластер.
Поэтому опрос заменили на реактивный паттерн Kubernetes Informer (list + watch через официальный Java-клиент Kubernetes):
- Первичный список (
list): на старте процесс один раз запрашивает текущиеEndpointSliceи засевает хэш-кольцо. - Потоковая подписка (
watch): затем держится постоянное соединение, по которому Kubernetes сам присылает событияadd / update / deleteв реальном времени. - Двухсекундный дебаунс (
2s debounce): каждое событие сразу обновляет локальный кэш срезов, но пересчёт кольца (applyLocalState()) откладывается на 2 секунды.
Зачем нужна двухсекундная пауза? Во время планового обновления (rolling deploy) или автоскейлинга Kubernetes сыплет десятками событий каждую долю секунды. Дебаунс в 2 секунды работает как лифт, который ждёт пару секунд на первом этаже, чтобы забрать всех вошедших соседей одним рейсом: вся суета роллинг-деплоя схлопывается в единственную перестройку кольца.
Если же сам API Kubernetes временно недоступен, библиотека сохраняет последний валидный снимок (last good endpoint set) и никогда не сбрасывает кольцо в пустоту. А если какой-то под реально отключился, ошибку соединения на уровне HTTP отработает штатный механизм повторов (retry).
Рефакторинг пайплайна доставки: как время выкатки релиза сократили с пяти суток до двух часов
Когда базовый код был готов, выяснилось, что главная преграда для настройки алгоритмов балансировки лежит в конвейере доставки (CI/CD). Любой подбор кривых прогрева кэша или весов нагрузки требует десятков быстрых выкаток, а существующий пайплайн позволял делать от силы один релиз в день.
За годы осторожной эксплуатации конвейер оброс защитными костылями: после каждого прошлого инцидента туда добавляли ручное подтверждение (approval gate) или паузу (180-second sleep). В итоге защита стала медленнее и опаснее самой системы:
- сборка занимала 21 минуту;
- выкат одной фичи включал более 40 ручных шагов переключения трафика;
- медианное время деплоя составляло 289 минут (4 часа 49 минут), а худший случай в истории растянулся на 4 дня и 21 час.
Из-за медленного конвейера разработчики копили изменения и катили их крупными рискованными пачками, где найти виновника сбоя было крайне трудно. Прежде чем трогать миллион RPS, Конор Галлахер влил три пулл-реквеста:
- кэширование сборки ужало компиляцию с 21 до 12 минут;
- свыше 40 ручных шагов трафика схлопнули в один шаг CI/CD;
- ручные согласования заменили автоматическим последовательным прокатом по группам рынков (
test -> eu-0 -> eu-1 -> eu-2), где малые регионы служат буфером тревоги перед критичным рынкомeu-2.
Медианное время релиза упало с 289 до 128 минут. За неполные семь недель обновлённый пайплайн провёл в продакшен более 100 пулл-реквестов (до 9 выкаток за один день!), развязав руки всей команде для параллельных экспериментов.
Канареечный перенос миллиона RPS: три защитных переключателя и прозрачный возврат на Skipper
Опираясь на быстрый пайплайн, команда начала переводить живой трафик со Skipper на встроенную библиотеку через три защитных переключателя:
CSLB_ENABLED: булевый рубильник полного отключения клиентской балансировки.CSLB_PERCENTAGE: плавный регулятор от0до100, задающий процент запросов, идущих напрямую в обход Skipper.- Прозрачный откат (Implicit Skipper fallback): любой запрос вне квоты CSLB или любая ошибка клиентской маршрутизации автоматически и незаметно проваливаются в старый маршрут через Skipper.
Рамп шёл ступенями: 1% в тестовой группе рынков, затем 10%, 50% и 100% по всем регионам. На пике со Skipper сняли свыше 1 000 000 запросов в секунду. Суточные спайки задержки на product-offers, которые годами списывали на «особенности сети», мгновенно разгладились в ровную линию. При этом старый путь оставили в коде как аварийный стоп-кран: одно изменение ConfigMap через blue-green деплой возвращает весь трафик обратно в Skipper. О том, как доли секунды отклика витрины влияют на выручку магазина, мы подробно разбирали в статье Скорость загрузки сайта как финансовый рычаг: расчет потерь конверсии по секундам.
Неожиданным бонусом стала прямая экономия: лишившись миллиона внутренних RPS, флот подов Skipper на маршрутах PRAPI сжался с 50+ до 8 подов, уронив суточную стоимость этой группы узлов с ~$450 до ~$110 в день. А поскольку в кластере из трёх зон доступности (AZ) две трети прыжков через общий Skipper пересекали границы зон, исчезновение лишнего хопа резко сократило и счета за межазонный трафик (EC2-Other).
Умная маршрутизация под капотом и границы применимости: N-ring fade-in, закон Литтла и цена владения
Получив контроль над маршрутизацией внутри JVM, инженеры решили проблемы распределения нагрузки, недоступные на общем прокси, и нащупали строгие границы применимости такого подхода.
1. Плавный прогрев новых подов: алгоритм N-ring fade-in
Когда горизонтальный автоскейлер (HPA) добавляет 50 свежих подов products, их кэши пусты: если сразу дать им полную долю трафика, все 50 подов одновременно пойдут в DynamoDB и вызовут всплеск задержек. Вероятностный предфильтр в Skipper защищал от лавины, но разогревал новые поды случайными товарами, которые после окончания прогрева уезжали на другие серверы.
В своей библиотеке команда внедрила N-ring fade-in. Каждое событие масштабирования создаёт новое хэш-кольцо (надмножество старого), которое плавно забирает трафик за окно в 30 секунд по степенной кривой ^2.5 (медленный старт и быстрый финиш):
- 3 с (10% времени) — 0,3% трафика;
- 9 с (30%) — 4,9%;
- 15 с (50%) — 17,7%;
- 21 с (70%) — 41,0%;
- 27 с (90%) — 76,8%;
- 30 с (100%) — 100% трафика, после чего кольцо становится основным.
Если во время прогрева прилетает ещё одно масштабирование, оно получает независимое окно, а весь набор колец хранится за одной атомарной ссылкой (atomic reference) как неизменяемый снимок без блокировок чтения. Главное: так как в новом кольце поды сразу стоят на своих финальных местах, они с первой секунды греют кэш только теми товарами, которые останутся за ними постоянно.
2. Закон Литтла и оценка реальной занятости (Occupancy-based Bounded Load)
Чтобы отдельные поды не перегружались популярными товарами, работает механизм Bounded Load: когда нагрузка пода превышает среднюю по кластеру, умноженную на коэффициент баланса (balance factor), поиск шагает по кольцу дальше к свободному соседу.
В Skipper загрузка оценивалась по числу открытых в моменте вызовов (in-flight). Но этот сигнал слеп между пачками запросов и не отличает быстрый под с горячим кэшем (1000 ответов в секунду по 1 мс) от пода, увязшего в промахах к DynamoDB по 100 мс. Из-за этого balance factor держали зажатым на уровне 1,10, а автоскейлер HPA включали уже при 50% CPU. Попытка считать запросы в секунду (throughput) тоже провалилась: быстрые кэш-хиты выглядели как перегрузка и впустую гоняли трафик по кольцу.
Выручил закон Литтла ((L = \lambda W)) из теории очередей. Вместо подсчёта штук запросов библиотека суммирует время реальной работы пода в скользящем окне из 150 миллисекунд (пять корзин по 30 мс):
Метрика occupancy («секунды работы в секунду») вскрыла то, что годами прятал in-flight: реальная занятость подов в кластере гуляла от 0,40 до 1,30! Добавив к сигналу весовой штраф за задержку (приём из классических высоконагруженных RPC-систем), инженеры получили итоговую формулу:
Если у пода есть открытые вызовы, но нет завершённых ответов, он считается зависшим и сразу получает максимальный штраф 5x.
Сравним поведение двух подов A и B в окне 100 мс при средней задержке кластера 1 мс:
| Параметр в окне 100 мс | Под A (горячий кэш) | Под B (промахи в базу) |
|---|---|---|
| Выполняемые запросы | 10 попаданий в кэш по 1 мс | 2 попадания по 1 мс и 3 промаха в DynamoDB по ~100 мс |
Средняя задержка (podLatency) | 1 мс | 60 мс |
Базовая нагрузка (max(inflight, occupancy)) | 0,1 | 3,0 |
Множитель задержки (min(podLatency / 1, 5)) | min(1 / 1, 5) = 1,0 | min(60 / 1, 5) = 5,0 (потолок 5x) |
Итоговая нагрузка (effectiveLoad) | 0,1 × 1,0 = 0,1 | 3,0 × 5,0 = 15,0 |
Хотя под B выполняет меньше запросов, три похода в DynamoDB подняли его среднюю задержку до 60 мс, включили пятикратный штраф и довели эффективную нагрузку до 15,0 против 0,1 у пода A. Балансировщик мгновенно обходит под B, не давая ему затормозить пачку из 100 товаров!
Чтобы при групповом замедлении сети поиск свободного сервера не пробегал всё кольцо, разрушая кэш, обход ограничили потолком в 10 шагов (capped walk; в штатном режиме 99-й перцентиль укладывается в 4 шага). Выравнивание нагрузки сжало разброс occupancy с 0,40–1,30 до 0,60–0,90. Это позволило ослабить balance factor с 1,10 до 1,25 и поднять порог HPA с 50% до 65% CPU: парк подов сократился более чем на 25%, занятость вошла в здоровый коридор 1,0–1,5, а экономия превысила $1000 в сутки.
3. Сетевые фризы, привязка к зонам (AZ) и границы применимости
Прямой вызов подов позволил жестко настроить отказоустойчивость: оставили один быстрый retry с разбросом в пару миллисекунд (только на ошибки сети и 5xx, никогда на 4xx/404) со списком исключений (exclude set), чтобы повтор не попадал на тот же под; перед потолком исходящих вызовов (отсекающим лишний вход кодом 503 с Retry-After) поставили буфер очереди FIFO; а в каждый лог ошибки добавили IP целевого пода и имя физического узла (ноды) Kubernetes.
Именно эта строчка в логе раскрыла многолетнюю тайну! Оказалось, что отдельные ноды в облаке периодически замирают на 2–3 секунды, полностью выключая сеть в обе стороны (одна нода за 2 секунды выдала 1909 таймаутов). Раньше за общим Skipper это выглядело как необъяснимый шум и поднимало инженеров по тревоге в 3 часа ночи. Теперь же штраф 5x и retry с exclude set сами обходят замершую ноду с подами products, а если замерла нода с product-sets, буфер FIFO спокойно держит очередь пару секунд без шторма повторов.
А вот попытка замкнуть трафик внутри своей зоны доступности (AZ-aware routing) показала, где нужно вовремя остановиться. Сначала мгновенное включение локальной зоны обрушило кэш, поэтому команда добавила стартовую паузу, прогрев по кривой ^2.5 от пола в 1% и фактор здоровья (latency health factor), сбрасывающий локальный трафик к 1% проб при росте задержки в зоне более чем на 35%. Затем чтение из DynamoDB внезапно подскочило с 50 000 до 400 000 операций: алгоритм Bounded Load считал локальные поды перегруженными по общей средней планке, ведь они одновременно тянули и локальное кольцо зоны, и глобальное кольцо кластера. Формулу порога починили, сложив ожидания обоих колец (loadPerLocalPod + loadPerGlobalPod), но при наложении зонного прогрева на обычный автоскейлинг N-ring fade-in полезли тонкие пограничные баги с вечерними алертами. В итоге команда осознанно поставила AZ-маршрутизацию на паузу, чтобы сберечь силы дежурных инженеров и вернуться к тестам в высокий сезон Cyber Week.
В финале отчёта Конор Галлахер предупреждает: для 99% команд писать собственный балансировщик — опасный антипаттерн. Собрать хэш-кольцо и подписку на EndpointSlice можно за выходные, но дальше тебе и твоей команде придётся вечно отвечать за права RBAC, сотни открытых watch-соединений, профилирование горячего пути без аллокаций и ночные инциденты. Для обычных сервисов готовые прокси вроде Skipper подходят несравнимо лучше. Своя in-process балансировка оправдана только на экстремальном пересечении трёх факторов: внутренний поток под миллион RPS, широкий параллельный fan-out в десятки вызовов и обязательный прозрачный fallback на внешний маршрутизатор.
В конечном счёте вся эта сложная инженерия с 64-битными кольцами, скользящими окнами по 150 миллисекунд и двухчасовыми пайплайнами создавалась не ради красивых формул. Любая зрелая архитектура делается ради простых человеческих вещей: чтобы система сама переваривала двухсекундные капризы облачного железа, разработчики тратили время на живые эксперименты вместо пятидневного дежурства у кнопки релиза, а телефон на прикроватной тумбочке молчал до утра, сохраняя здоровье и спокойствие команды.