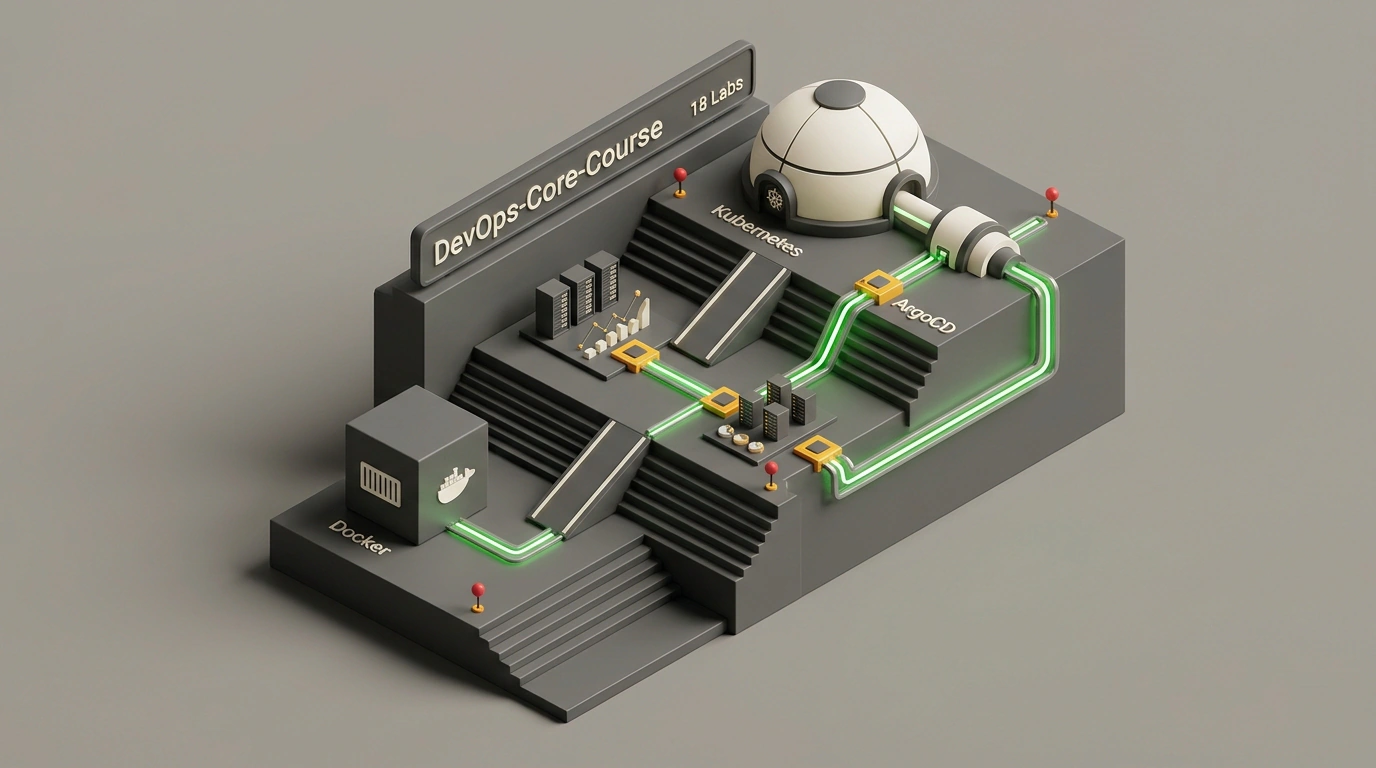
Этот разбор даст тебе чёткий ответ на вопрос, как перестать учить инфраструктурные утилиты вразнобой и своими руками собрать продакшен-контур вокруг одного сервиса. Когда осваиваешь DevOps по отдельным шпаргалкам, ты быстро учишься запускать контейнер или писать сборку, но при попытке связать инструменты в единую систему детали не стыкуются.
Я изучил открытый репозиторий DevOps-Core-Course от Университета Иннополис (ссылкой поделился канал SQL Portal) и покажу его инженерную логику: как один веб-сервис обрастает автоматизацией, мониторингом и отказоустойчивостью без выброшенного кода.
Принцип «You build it, you run it»: как один сервис вырастает в кластер
Программа из 18 лабораторных работ на 16 недель опирается на принцип Вернера Фогельса «You build it, you run it» — кто написал сервис, тот и отвечает за его работу в продакшене.
Если тренироваться на одноразовых примерах, то после каждого урока ты удаляешь папку и не видишь, как код переживает обновление инфраструктуры. Если же в Лабораторной 1 написать веб-сервис на Python 3.13 (FastAPI или Flask в app_python/) и вести этот сквозной проект (QuickTicket) до финала, то каждый инструмент закрывает реальную задачу твоего приложения. По ходу курса одиночный сервис (web) вырастает в кластер из трёх компонентов за счёт двух Go-сервисов из папки plumbing/: в Лабораторной 9 подключается echo для проверки DNS и сети, а в Лабораторной 13 — health. Оба отдают метрики Prometheus, а ты встраиваешь их в общий контур (о базовых ступенях профессии мы также писали в обзоре пошагового DevOps Roadmap 2026).
Дорожная карта из 16 базовых недель: от контейнера и IaC до наблюдаемости и GitOps
Когда сервис готов, 16 еженедельных работ нанизывают на него слои эксплуатации (стек на май 2026 года):
- Контейнеризация и CI (Лабораторные 2–3). Если код пора переносить с ноутбука, то в Docker 29 его упаковывают через многоступенчатую сборку (multi-stage build) в образ
distroless— словно верстак остался в мастерской, а в квартиру уехал только готовый стол без лишних утилит. В GitHub Actions настраивается конвейер тестов, где Trivy проверяет образ перед отправкой в GHCR. - IaC и конфигурация (Лабораторные 4–6). Если образ собран, настраивать серверы вручную рискованно. Ресурсы описываются кодом (IaC) на Terraform 1.15, OpenTofu 1.12 и Pulumi 3.243, а деплой автоматизируется ролями
ansible-core2.21 с Ansible Vault и OIDC. - Логи и метрики (Лабораторные 7–8). Если сервис работает удалённо, без телеметрии ты действуешь вслепую. Логи собирает агент Grafana Alloy 1.16 в Loki 3.7, а метрики снимает Prometheus 3.x для Grafana 13 по методикам RED и USE.
- Kubernetes, секреты и GitOps (Лабораторные 9–13). С появлением второго сервиса проект переезжает в
k3dна Kubernetes 1.36 ("Haru") и упаковывается в чарты Helm 4.1. В Лабораторной 11 секреты выносятся в OpenBao 2.5 с External Secrets Operator, в Лабораторной 12 настраиваются томаPV/PVC, а на тринадцатой неделе деплой переводится на GitOps в ArgoCD 3.4 черезApplicationSet.
Прогрессивная доставка в Argo Rollouts, граничные вычисления и сборки на Nix
Что будет, если свежий релиз пройдёт тесты, но под нагрузкой начнёт сыпать ошибками? Если переключить весь трафик сразу, упадёт прод. Поэтому в Лабораторной 14 внедряется прогрессивная доставка (Progressive Delivery) через Argo Rollouts 1.8 для канареечных и сине-зелёных выкаток: контроллер переводит на новую версию малую долю запросов и через AnalysisTemplate сверяет метрики в Prometheus, автоматически откатывая сбойный релиз. В Лабораторных 15 и 16 цикл завершают StatefulSets и мониторинг kube-prometheus, а бонусные Лабораторные 17 и 18 знакомят с Cloudflare Workers (изоляты V8) и сборками на Nix flakes.
В итоге в твоём форке собирается рабочее портфолио. Чтобы пройти маршрут без пробуксовок, держи в памяти три ориентира:
- Первая задача каждого модуля автономна. Работа даёт до 10 основных и 2 бонусных баллов, но стартовое задание независимо — пропуск бонуса не заблокирует следующую тему.
- Локальному стенду нужно от 16 ГБ оперативной памяти. Запуск Kubernetes в
k3dсо связкой ArgoCD, Prometheus, Loki и тремя сервисами требует солидного запаса RAM. - Твой код живёт только в личном форке. В исходном репозитории лежат
lectures/,labs/иplumbing/, а папки студента внесены в.gitignore, поэтому веди работу в своём форке через Pull Request.
Такой последовательный путь от простого скрипта до кластера наглядно показывает, какую задачу решает каждая строчка конфигурации.