Работа в экосистеме OpenAI по подписке до последнего времени делилась на два разных сценария. В одном окне у тебя открыт браузерный ChatGPT для разбора документации и писем, а в другом — автономный кодинг-агент Codex, который сам обходит файлы проекта и переписывает функции. Раньше у каждого инструмента был собственный счетчик запросов, и сборка в терминале не мешала общаться с чат-ботом.
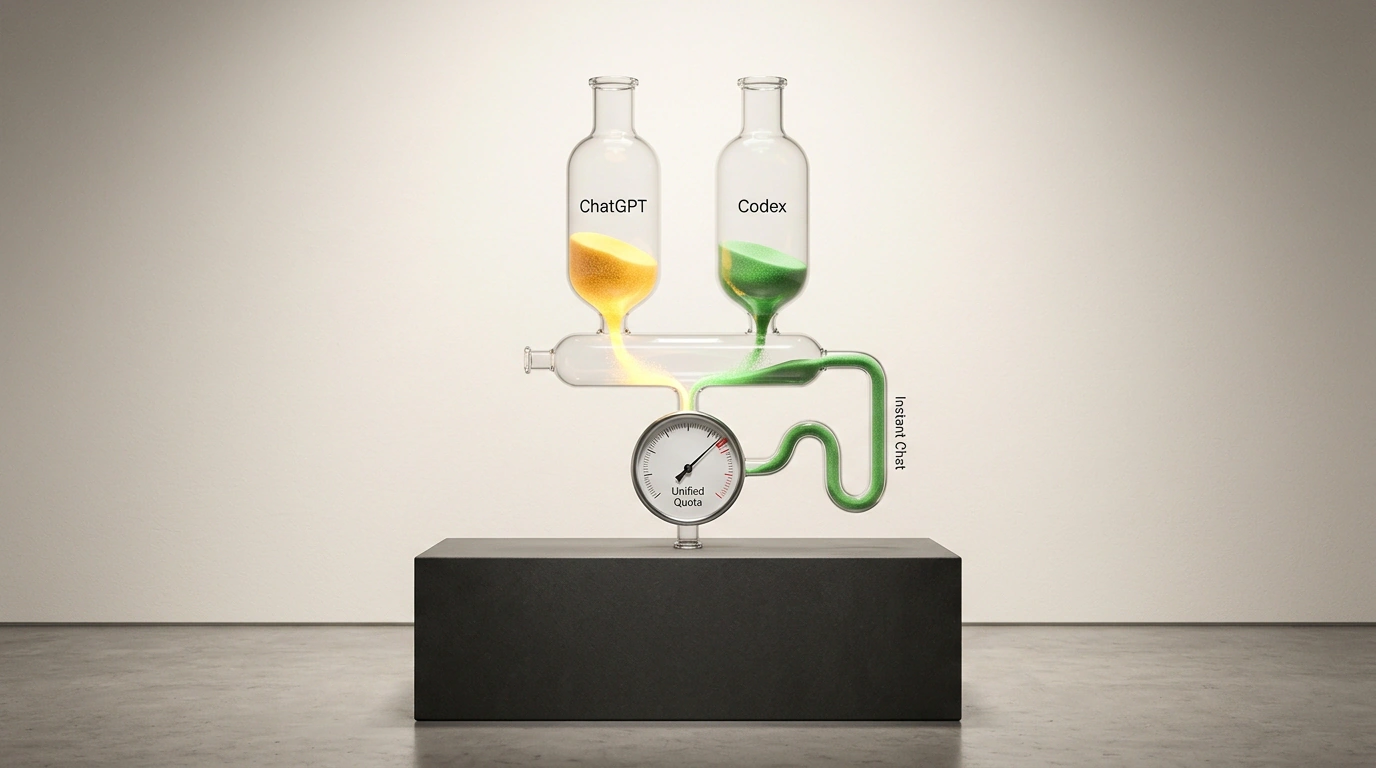
Этой зимой перегородка исчезнет, и оба сервиса начнут черпать ресурс из одной чашки. Почему после обновления правил привычная подписка может внезапно заблокировать отправку текстовых сообщений посреди дня из-за запущенного утром кодинг-агента и как перестроить рабочие привычки?
Что изменилось в правилах OpenAI: общий резервуар для чата и агентов
Причина будущих блокировок — тихий апдейт документации. 31 октября 2026 года в OpenAI Help Center обновилась статья Understanding ChatGPT and Codex Usage Limits: с декабря (точный день пока не назван) квоты на тарифах Plus ($20 в месяц), Pro ($200 в месяц) и Business объединяются в общий пул для ChatGPT и Codex. Планы Free, Enterprise и Edu под это изменение не попадают.
Зачем компании понадобилось сливать корзины? Я сопоставил этот шаг с тем, как развивается единая платформа агентов ChatGPT и среды Codex. Общий агентный пул существует уже сегодня: его делят Codex, окружение ChatGPT Work, плагины Excel и PowerPoint и Workspace Agents, а теперь туда же переводят и повседневный текстовый чат.
Арифметика расхода: почему кодинг-агент выпивает лимит быстрее обычного диалога
Когда два разных сервиса подключают к одной трубе, легко споткнуться на подсчете. OpenAI списывает квоту не по числу сообщений, а по объему входных и выходных токенов (фрагментов текста и кода) с учетом сложности задачи и «тяжести» модели. Это как батарея смартфона: короткий вопрос легкой модели тратит заряд как СМС, а многошаговая сборка на топовой сети высаживает ресурс как потоковое видео.
Проследим по цепочке, к чему это приводит. Допустим, утром разработчик на тарифе Plus запускает Codex для рефакторинга модуля аутентификации, рассчитывая после обеда поработать в ChatGPT над документацией. Раньше утренний кодинг не трогал запас текстовых реплик. После декабрьского слияния срабатывает прямая связь: если агент в цикле читает файлы модуля аутентификации, проверяет зависимости, переписывает код и правит ошибки на флагманской модели, то за два часа плотного рефакторинга он досуха выпивает весь токен-бюджет подписки.
Практический итог догоняет разработчика сразу после перерыва. Он открывает браузерный ChatGPT, чтобы описать обновленные эндпоинты авторизации, и упирается в блокировку отправки сообщений до вечера — работу приходится ставить на паузу или писать все вручную. На тарифе Plus при исчерпании пула включается жесткое окно ожидания на пять часов, тогда как подписка Pro не имеет пятичасового таймера в задачах Work и Codex за счет расширенного буфера, но все равно черпает ресурс из конечного общего котла.
Стратегия адаптации: режим Instant Chat, экран Usage и разделение задач
Чтобы утренний кодинг не оставлял тебя к обеду у заблокированного чата, перенеси быстрые текстовые запросы в режим Instant Chat. По правилам OpenAI легкие диалоги в Instant Chat — короткие справки, вычитка абзаца или простые идеи — вообще не расходуют общий лимит, сберегая квоту для Codex (хотя точные критерии Instant и цифры общего пула токенов компания пока не раскрыла). Следить за общим остатком и временем сброса удобно на новом экране Settings → Usage, а при плотной нагрузке лучше отдавать мелкие правки легким моделям или выносить рутинный кодинг на внешние API (подходы к квотам мы разбирали в сравнении Claude Code и ChatGPT Codex). Появился и приятный плюс: в недели без активного кодинга лимит Codex больше не сгорает впустую и доступен для аналитики в чате.
Впадать в крайности, скупать несколько дорогих подписок впрок или бояться лишний раз запустить Codex точно не нужно: при умеренном общении и периодических запусках агента ждать сброса лимитов чаще обычного не придется. Здесь выручает здравое чувство меры: оставляй простые вопросы бесплатному для квоты Instant Chat, проверяй Settings → Usage перед тяжелым рефакторингом и разделяй рабочие контуры только тогда, когда этого реально требует твой объем кода.