Когда исследователей внутри лаборатории Anthropic попросили оценить на глаз, насколько новейшие внутренние версии Claude ускоряют их работу, в анкетах мелькали восторженные оценки вплоть до двенадцатикратного рывка. Но стоило независимым аудиторам сверить рабочие логи и реальные задачи с секундомером, как картина оказалась куда трезвее: минимальные оценки в тех же опросах начинались со скромных 1,2 раза, а реальное операционное ускорение на инженерных задачах составило около двух раз.
Разрыв между ощущением всемогущества нейросети и её реальным поведением волнует всю индустрию. Способен ли искусственный интеллект вроде Claude 3.5 Sonnet уже сегодня самостоятельно дописывать свой код и запускать цепную реакцию рекурсивного самосовершенствования (RSI)? Независимый аудит доказал: модели полезны как ассистенты инженера, но не способны к автономному замкнутому циклу саморазвития из-за быстрого накопления логических ошибок.
Почему Anthropic впустила аудиторов METR во внутреннюю кухню и где провела красную линию
Долгое время споры о том, начал ли ИИ сам себя разгонять, строились на догадках. Чтобы перевести разговор на язык фактов, Anthropic пригласила внутрь компании аудиторов из независимой организации METR (Model Evaluation and Threat Research — профильного института по оценке предельных возможностей моделей и рисков безопасности).
Проверка длилась 11 недель — с 12 августа по 29 октября 2026 года, а её результаты вышли 5 ноября в официальном отчёте METR и подробно разобраны в видеообзоре Мэтью Бермана. Два с половиной штатных сотрудника METR читали рабочие чаты в Slack, изучали коммиты, интервьюировали создателей моделей и тестировали закрытые чекпоинты. Они искали ответы на три вопроса: ускорился ли темп разработки в лаборатории, какую долю этого разгона даёт сам ИИ и есть ли преграды, которые не дадут процессу выйти из-под контроля.
Меня здесь сразу зацепила деталь на стыке науки и бизнеса: полной прозрачности не получилось. Изначально METR должна была проверить распределение вычислительных мощностей (compute allocation) — сколько видеокарт уходит на коммерческий инференс, сколько на обучение новых моделей и сколько на безопасность. Посреди проекта Anthropic в одностороннем порядке закрыла этот доступ, сославшись на фокусировку вокруг оценки рисков перед подачей биржевой формы S-1 для выхода на IPO. А из полного стостраничного доклада перед публикацией исключили закрытые чертежи оптимизации инференса. Но даже опубликованные цифры наглядно показывают изнанку нейросетевой разработки.
Методика индекса AECI: как замеряли работу Claude на отладке кода и обучении сетей
Как измерить ускорение целой лаборатории, не перепутав помощь нейросети с покупкой серверов или наймом людей? Аудиторы взяли за основу внутренний эталон — индекс возможностей Anthropic Epoch Capabilities Index (AECI). Это полоса препятствий для ML-инженера: от поиска багов в пайплайнах данных и написания тестов до дообучения вспомогательных сетей и проектирования алгоритмов синхронизации.
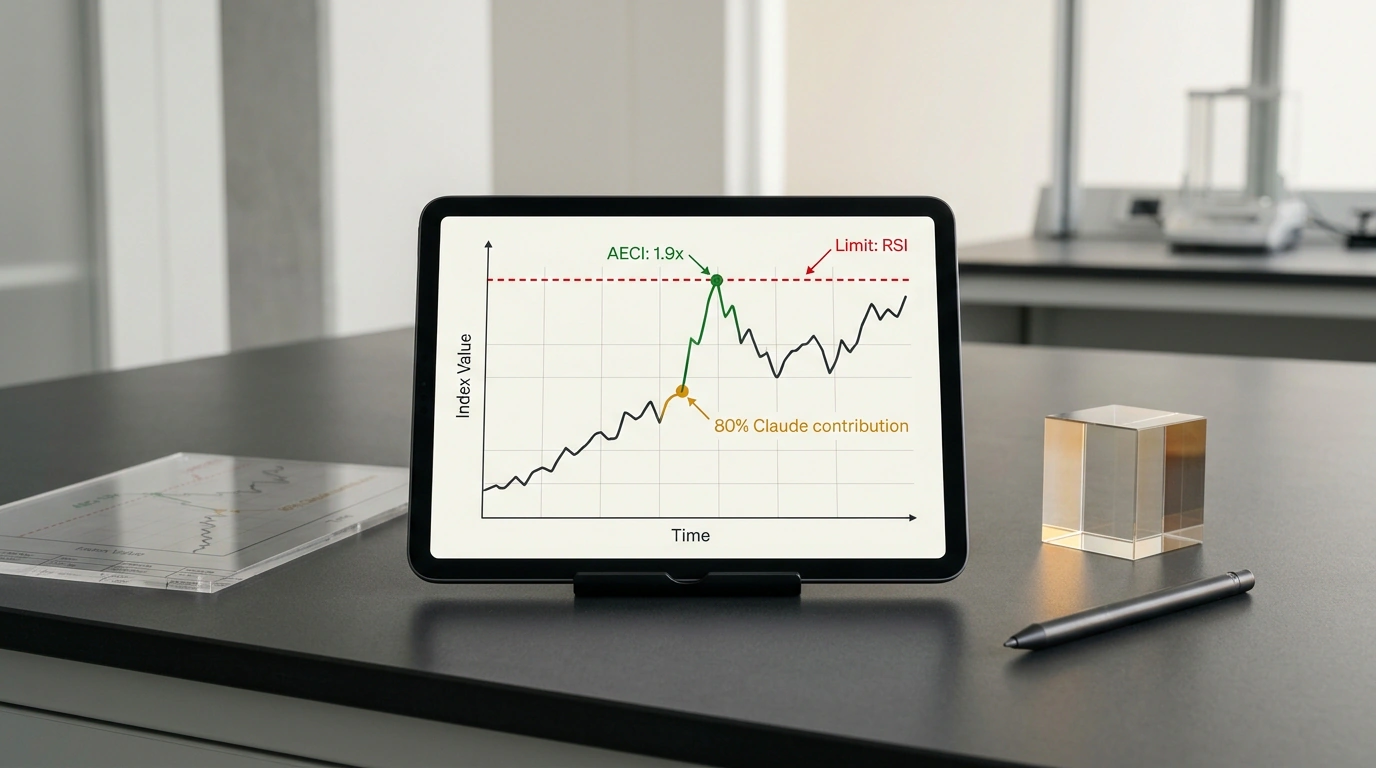
Сопоставление двух периодов дало наглядную картину. Если с марта 2024 по октябрь 2025 года способности моделей по индексу AECI росли плавно и почти линейно, то после выхода семейств Claude 3.5 Sonnet, Opus 4.5 и внутренних прототипов линейки Mythos график резко пошёл вверх. Темп роста возможностей ускорился в среднем в 1,9 раза (при 95-процентном доверительном интервале от 1,5 до 2,8 раза). Проще говоря, два года прежнего прогресса теперь сжимаются в один календарный год.
Дальше сработало исключение лишних факторов. Сверев объём вычислительных кластеров и штат сотрудников, эксперты METR выяснили: около 80% нынешнего ускорения даёт прямое использование моделей Claude самими исследователями Anthropic. Если раньше учёный тратил дни на ручное написание проверочных скриптов и разбор логов, то теперь агент собирает эту обвязку за пару часов. А если инженер больше не упирается в скорость набора кода, то за неделю он проверяет вдвое больше научных гипотез. Схожий сдвиг мы недавно разбирали в материале о том, почему ведущие лаборатории переходят к ИИ, создающему ИИ. Но между быстрым помощником учёного и самостоятельным разумом остаётся пропасть.
Испытание очередью сообщений: где агент экономит часы, а где теряет нить архитектуры
Почему же двукратное ускорение инженера не складывается в автономную сингулярность? Разберём это на реальной инженерной задаче того же класса, на котором проверяют модели. Допустим, у нас есть сервис с распределённой очередью сообщений, где при пиковой нагрузке возникает скрытый баг — пакеты дублируются или теряют порядок при синхронизации узлов. Нам нужно найти корень гонки состояний и оптимизировать алгоритм синхронизации без потери надёжности.
Сравним поведение Claude 3.5 Sonnet на этой очереди в двух сценариях:
- Точечная работа под управлением человека. Ты сам выдвигаешь гипотезу: сбой кроется в таймауте блокировки при повторной отправке пакета. Ты поручаешь модели написать генератор нагрузки на сто тысяч сообщений, собрать модульные тесты для воркеров и отрефакторить функцию сериализации. За пятнадцать минут агент выдаёт чистый код, находит мелкую утечку памяти в парсере и экономит тебе полдня рутины.
- Полный автопилот без подсказок инженера. Теперь отдадим агенту всю многочасовую задачу целиком: «Найди причину рассинхронизации в кластере и оптимизируй протокол обмена». На первых шагах модель бодро читает логи и правит конфигурацию. Но если первый патч не устраняет архитектурную причину, то на третьем-четвёртом витке агент начинает лечить симптомы: раздувает буферы ожидания, плодит лишние проверки и ломает совместимость соседнего модуля. Контекстное окно забивается отладочным выводом, одна неверная догадка наслаивается на другую, и через три часа система оказывается в более запутанном состоянии, чем до старта.
Для команды разработчиков разница очевидна. Когда архитектор держит в голове устройство системы и отдаёт нейросети изолированные задачи — тесты, граничные условия, локальный рефакторинг, — работа идёт вдвое быстрее, а очередь сообщений получает надёжный патч к обеду. Но при попытке переложить на модель сквозной архитектурный поиск алгоритм быстро тонет в собственных допущениях. Это и отвечает на вопрос из начала статьи: замкнутого цикла, где ИИ сам проектирует и обучает следующую версию себя с нуля, сегодня не существует.
По итогам 11 недель аудита эксперты METR зафиксировали: модели сняли узкое место в виде скорости написания кода (no longer bottlenecked on code), но главными ограничителями остаются оригинальные научные идеи человека и физический объём вычислительных кластеров.
Практический расклад для разработки: что смело отдавать модели, а что держать в своих руках
Выводы отчёта METR дают трезвую систему координат для работы с агентами. С одной стороны, аудиторы не нашли жёстких преград, которые помешают тандему человека и ИИ разгонять разработку в ближайшие год-два — Anthropic уже приходится усложнять внутренние бенчмарки, так как свежие непубличные модели быстро выбивают на старых тестах потолок баллов. С другой стороны, водораздел между задачами для алгоритма и для человека виден чётко:
- Зелёная зона (делегируем модели): написание тестов, сборка скриптов проверки гипотез, типовой рефакторинг внутри одного-двух файлов и фильтрация логов. Как выстроить такую работу, мы разбирали в руководстве по переходу от монолитных ботов к атомарным конвейерам на базе Claude.
- Красная зона (оставляем за человеком): постановка исследовательских гипотез, проектирование связей в распределённой архитектуре и валидация безопасности. Как показал опыт поиска криптографических уязвимостей с помощью ИИ-агентов, без человеческой верификации алгоритм легко принимает заплатку за решение проблемы.
Аудит METR снял с рекурсивного самообучения мистический ореол: нейросеть не переписывает свои веса втайне от людей, но уже забрала на себя черновую кодовую рутину, позволив инженерам двигаться вдвое быстрее. И если сегодня главным ограничением в разработке перестала быть скорость набора кода и осталась лишь смелость наших собственных идей — то на какую задачу в своём проекте ты потратишь освободившиеся полдня завтра утром?