Abre tu panel de monitoreo durante un pico de tráfico y verás una escena capaz de desconcertar a cualquier ingeniero. En las gráficas todo está en calma: el Horizontal Pod Autoscaler (HPA) estándar de Kubernetes vigila el clúster, el uso promedio de CPU ronda el 70% y las reglas de asignación de recursos se cumplen al pie de la letra. Pero en ese mismo instante, las personas que intentan abrir tu web o aplicación se estampan contra un muro de errores 503 Service Unavailable y 504 Gateway Timeout. Dos realidades incompatibles conviven al mismo tiempo: según los reportes del orquestador, el escalado va sobre ruedas; para el usuario real, el servicio está caído.
Me llamó mucho la atención el análisis de esta discrepancia en el canal DevOps&SRE Library. El autor del artículo es David Morrison (drmorr), investigador de sistemas distribuidos en Applied Computing Research Labs (ACRL). En la segunda entrega de su serie sobre los cinco indicadores de autoescalado en Kubernetes (tras el análisis de su colega Ian sobre el dinero quemado en nodos ociosos), Morrison propuso mirar la fiabilidad con los ojos del cliente e introdujo la métrica MTSS (Mean Time to Stop Sucking — el tiempo medio hasta que el servicio deja de funcionar fatal). Veamos por qué los autoescaladores llegan tarde al inicio de un pico, cómo medir la duración de la degradación y qué ajustes de HPA y KEDA acortan esa ventana.
La trampa de las métricas tardías y el punto ciego al arrancar los pods
En el corazón del autoescalado hay un equilibrio entre costo y fiabilidad que Morrison compara con lanzar una moneda: «cara: es barato; cruz: no se rompió». Hacer que una infraestructura sea barata es fácil: apaga los servidores. Hacerla invulnerable también es sencillo: asigna a cada pod una instancia gigante c7i.48xlarge, aunque al director financiero no le va a hacer ninguna gracia la factura. Lo que necesitamos es crecer bajo carga (scale up) sin perder calidad y contraernos después (scale down) sin cortar sesiones de clientes.
¿Por qué el autoescalador basado en CPU y memoria llega tarde cuando sube la carga? Sigamos el escenario completo del análisis de Applied Computing. Una avalancha de peticiones golpea el servicio web. El uso medio de CPU sigue en el 70%, pero la cola entrante de peticiones HTTP se desborda al instante. Incluso si hay recursos libres en los nodos del clúster y solo hace falta levantar 4 pods nuevos, los usuarios sufren un brote de 45 segundos de errores 504 Gateway Timeout. Primero, el recolector de métricas promedia los datos de los contenedores; luego, el controlador HPA ejecuta su ciclo de comprobación (cada 15 segundos por defecto) y, tras superar el umbral del 70–80%, crea 4 réplicas. Mientras los contenedores inicializan el runtime, se conectan a la base de datos y pasan el readiness probe, los pods antiguos rechazan peticiones por timeout.
Cuando no hay espacio en los servidores actuales, el retraso escala a decenas de minutos. Morrison da un ejemplo muy ilustrativo: 2 pods en un único nodo t3.medium sirven la portada de un proyecto, y de pronto el enlace aparece en la página principal de un portal muy popular. Los pods se ahogan devolviendo millones de errores 503 Service Unavailable. El HPA crea nuevas réplicas, pero se quedan en estado Pending porque el nodo t3.medium está lleno. El autoescalador pide máquinas a la nube (para instancias GPU escasas, la espera llega a los 10 minutos). Después se van otros 5 minutos o más en preparar el nodo: instalar parches del sistema operativo y configurar el entorno (prod o staging) antes de que arranque kubelet. Y una vez que el pod está en marcha, el servicio en Java tarda otros 5 minutos en calentar el compilador JIT y cargar la caché en memoria.
De qué se compone la ventana de fallo MTSS en el camino de una petición
La mayoría de los equipos solo rastrea una métrica interna del planificador: el paso del pod de Pending a Scheduled. En el aprovisionador de nodos Karpenter existe para eso la métrica alfa karpenter_pods_unbound_time_seconds, que mide el tiempo desde la creación del pod hasta su asignación a un nodo. Pero eso refleja únicamente la velocidad con la que la nube entrega una máquina virtual: una fracción mínima de lo que le importa al cliente.
Imagina un supermercado en hora punta con una fila que llega hasta la puerta en la única caja abierta. Medir el autoescalado con karpenter_pods_unbound_time_seconds equivale a cronometrar cuántos segundos tarda el encargado en asignar cuatro cajeros a cuatro cajas vacías. En el reporte, ¡el personal quedó asignado en medio minuto! Pero para el comprador la caja sigue cerrada: el cajero tiene que encender el terminal, cargar el software y poner el rollo de papel. Hasta que no se encienda la luz verde sobre la caja y el escáner no pase el primer producto, la fila no se mueve.
La métrica MTSS enciende el cronómetro del lado del comprador. Mide el intervalo desde el instante en que la calidad del servicio cae por debajo del SLO (Service Level Objective: el umbral aceptable de errores 5xx y latencias dentro del acuerdo SLA) hasta el segundo en que los nuevos pods superan el readiness probe y devuelven los indicadores a la normalidad. Métricas de frontend como First Contentful Paint o Mean Time to First Byte no sirven aquí: no todo servicio devuelve bytes a un navegador, y un script en el cliente no ve dónde se atascó el clúster.
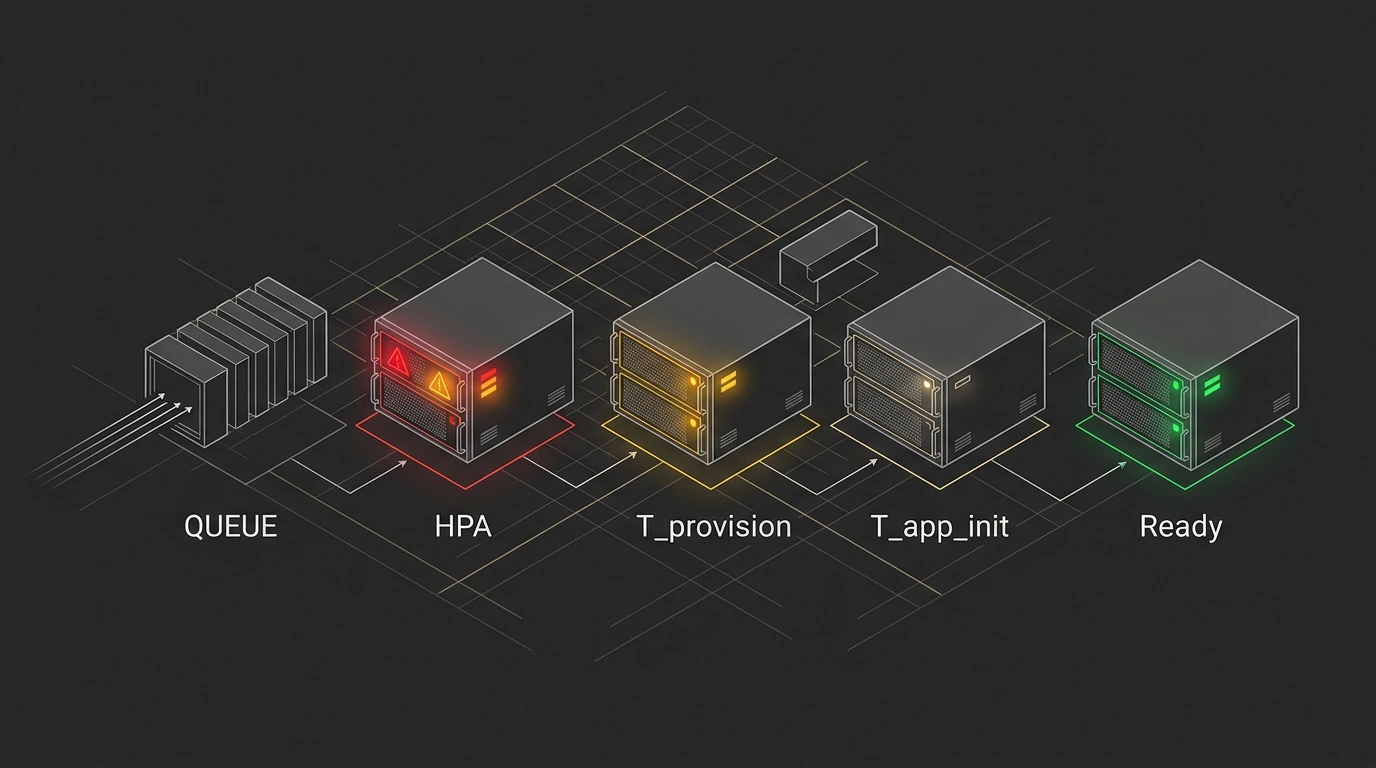
Matemáticamente, la ventana MTSS es la suma de seis retrasos:
MTSS = T_detect + T_provision + T_node_prep + T_pull + T_app_init + T_readiness
T_detect: detección del pico por el recolector de métricas y el ciclo de sondeo del HPA (15 segundos);T_provision: aprovisionamiento de la máquina virtual en la nube (AWS, GCP o Azure);T_node_prep: instalación de parches del SO, configuración del nodo y arranque dekubelet;T_pull: descarga de las imágenes de contenedor desde el registro;T_app_init: arranque de contenedoresinit, sidecars y calentamiento del runtime;T_readiness: superación delreadiness probe, que habilita el pod para recibir tráfico.
La suma de estos seis tramos es lo que se traduce en 45 segundos de errores 504 Gateway Timeout al levantar 4 pods en nodos ya listos, o en 15 minutos de caída cuando toca pedir nodos en frío.
Palancas de ingeniería para acelerar HPA y KEDA y sus límites
Entender cada eslabón de la cadena MTSS le da al equipo de plataforma palancas concretas para recortar el tiempo de respuesta:
- Aprovisionador rápido de nodos e imágenes preconstruidas (Pre-baked AMI). Sustituir el Cluster Autoscaler de Kubernetes por Karpenter (con soporte para AWS, Azure y GCP) acelera la entrega de máquinas (
T_provision). Y para eliminar la pausa de 5 minutos deT_node_prep, los parches del SO y la configuración se dejan ya horneados de antemano en la imagen de la máquina virtual. - Ciclo de sondeo corto y métricas adelantadas en KEDA. Como ironiza Morrison, todo el mundo sabe que no se debe escalar por CPU y todo el mundo sigue escalando por CPU. Pasar al autoescalador orientado a eventos KEDA (antes indispensable para escalar a cero, aunque recientemente el HPA también incorporó esa función) permite acelerar el sondeo de métricas, ajustar
behavior.scaleUp.stabilizationWindowSecondsy atar el escalado a señales anticipadas: profundidad de la cola HTTP, RPS entrante o lag del bróker. Ya analizamos antes las cinco métricas adelantadas de Kubernetes según ACRL y el cálculo de umbrales de lag antes de lanzar KEDA. - Escalado de la cadena de servicios y alivio del arranque del pod. En una cadena
A → B → C → D, escalar servicio por servicio no sirve de nada: en cuanto crezcaA, la oleada de peticiones tumbará aB, luego aCy aD, y los errores no desaparecerán hasta que se levanteD. La jugada correcta es escalar toda la cadenaA → B → C → Da la vez cuando sube la carga enA. Y para comprimirT_app_initsin tocar código, reduce la cantidad de contenedoresinitpesados y proxies sidecar (si tienes menos de diez, ya vas por delante de la mayoría de los clústeres corporativos).
Compara el instante en que un pod se asigna al nodo (karpenter_pods_unbound_time_seconds) con el momento en que pasa a estado Ready. La diferencia te mostrará el retraso exacto de descarga de imágenes, arranque de sidecars y calentamiento de la aplicación (T_pull + T_app_init + T_readiness).
Eso sí, estas herramientas vienen con condiciones y límites estrictos:
- El costo del rastreo de extremo a extremo. El número agregado de MTSS te dice que hay un problema, pero no señala al culpable. Para desglosar el retraso por etapas hay que cruzar cinco fuentes (llegada de la petición vía service mesh, métricas del nodo, decisión del HPA, respuesta del aprovisionador de nodos y arranque de la app) mediante trazabilidad distribuida (distributed tracing), lo que eleva la factura de telemetría.
- El mito del autoescalado predictivo. Muchos intentan esquivar la optimización del arranque en frío metiendo un autoescalador predictivo. Suena espectacular (y casi le garantiza un ascenso al autor, aunque el sistema no funcione), pero predecir picos repentinos es dificilísimo y, con nodos y pods Java que tardan 10 minutos en arrancar, cualquier error de predicción acaba en caída. Los algoritmos predictivos solo funcionan en cargas cíclicas con proveedores probados, y nunca sustituyen a un arranque rápido de pods.
La conclusión es directa: deja de evaluar el autoescalado mirando gráficas de CPU al 70% y la velocidad con la que un pod se asigna a un nodo. Mide la ventana completa de errores 504 y 503 hasta que pasa el readiness probe, cambia HPA y KEDA a la longitud de la cola de peticiones, hornea las actualizaciones en las imágenes de los nodos y recorta los sidecars sobrantes. Toda esta ingeniería no existe para lucir números bonitos en un reporte: una buena infraestructura debe ser invisible para la persona al otro lado de la pantalla, de modo que en pleno pico de tráfico la página abra al instante y el equipo conserve la calma y la confianza en su arquitectura.