Pregúntale a cualquier administrador de sistemas o ingeniero DevOps cómo tiene configurado el autoescalado horizontal de pods (Horizontal Pod Autoscaler, HPA) en Kubernetes y, nueve de cada diez veces, escucharás la misma respuesta automática: «Pues por CPU y memoria RAM, el umbral clásico del 70–80 %».
Sobre el papel suena lógico: llega una oleada de usuarios, los procesadores echan humo, Kubernetes detecta el pico de uso y añade cinco réplicas más del servicio. Pero en producción real con alta carga, ese esquema simplista provoca caídas en cascada con demasiada frecuencia. Cuando la CPU de un contenedor ya va al 90 %, suele ser tarde para salvar el servicio: la cola de peticiones entrantes está desbordada, los timeouts caen como un alud y los nuevos pods aún tardan dos o tres minutos en inicializarse, descargar la imagen y pasar las sondas de readiness. Al final, la carga se redistribuye sobre los pods vivos que quedan y el clúster se derrumba como fichas de dominó.
Los ingenieros del laboratorio de investigación Applied Computing Research Labs (ACRL) publicaron un análisis detallado de los cuellos de botella del escalado, desgranando cinco métricas poco evidentes que permiten configurar un autoescalado predictivo mucho antes de que las CPUs toquen techo.
Por qué la CPU y la memoria engañan al autoescalador
Veamos la física del proceso. Las métricas de uso de CPU y RAM son indicadores retardados (lagging indicators): reflejan una catástrofe que ya ha ocurrido, no su aproximación.
Es más, en microservicios asíncronos modernos escritos en Node.js, Go o Java, la CPU puede estar ocupada apenas al 30 % y, aun así, el servicio estar completamente muerto de cara al cliente. Por ejemplo, si se agota el pool de conexiones a PostgreSQL o una pasarela de pagos remota empieza a responder con 5 segundos de retraso, los hilos de entrada de la aplicación quedan bloqueados esperando entrada/salida (I/O wait). ¡La CPU mientras tanto está ociosa! Kubernetes ve un 25 % de carga de CPU y da por hecho que todo va de maravilla, mientras los usuarios reciben errores HTTP 504 Gateway Timeout.
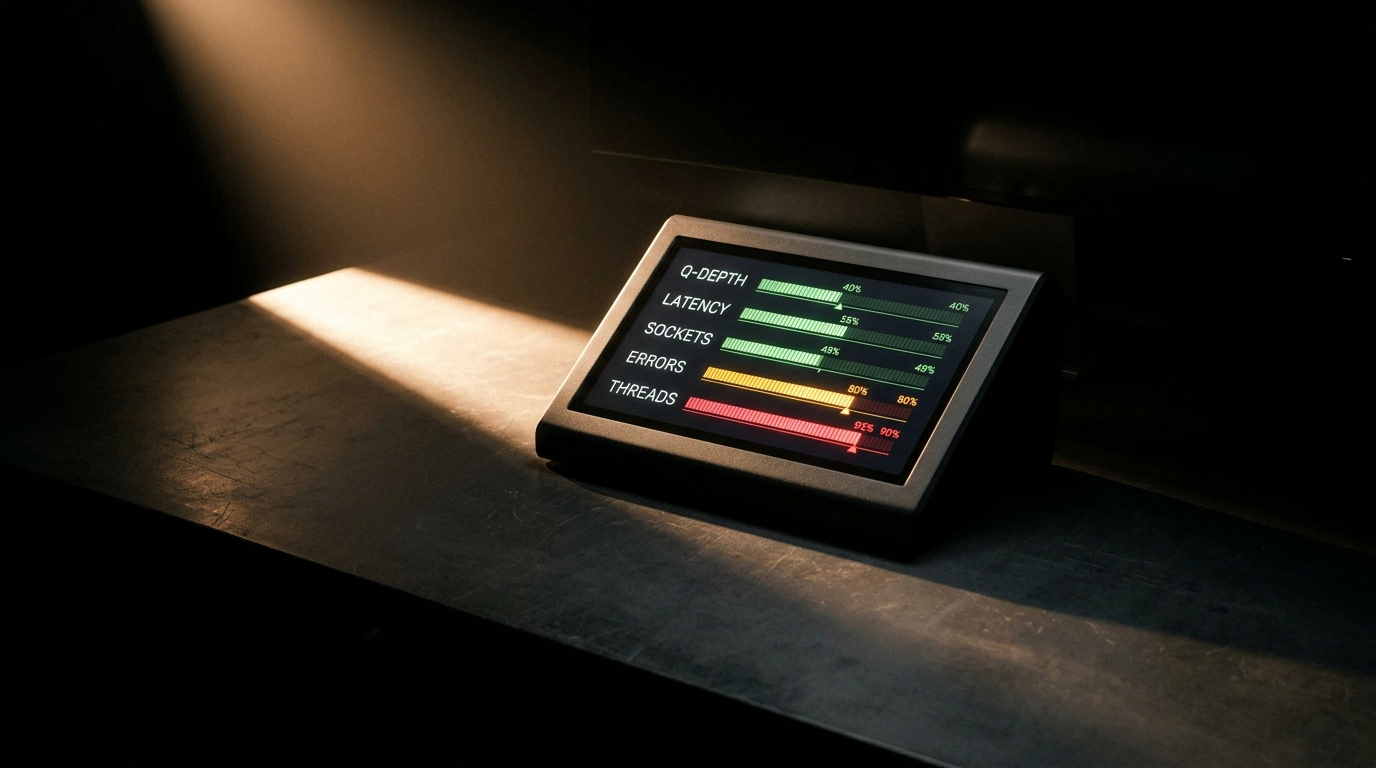
Los investigadores de ACRL definieron cinco métricas fundamentales centradas en el rendimiento real (throughput) y la profundidad de las colas.
Cinco métricas clave de ACRL: señales adelantadas de carga
- Velocidad de crecimiento de la cola de mensajes (Queue Ingestion Rate vs Processing Rate): En workers asíncronos (RabbitMQ, Kafka, SQS), guiarse por la CPU no tiene sentido. Lo que importa no es la longitud absoluta de la cola, sino la derivada: la tasa de llegada de mensajes nuevos menos la tasa de procesamiento. Si el delta se vuelve positivo, hay que escalar de inmediato.
- Tiempo de espera en búfer (Queue Dwell Time): Mide cuántos milisegundos pasa un mensaje o una petición HTTP en la cola antes de que un hilo libre empiece a ejecutarlo de verdad. Superar un umbral de 200–300 ms es motivo directo para añadir pods.
- Latencia del handshake TCP y RTT (Connection Handshake Latency): Se mide en la capa del balanceador Ingress. Un repunte en el tiempo de establecimiento de conexiones TCP delata que el backlog de sockets del sistema operativo dentro del pod (
somaxconn) se está desbordando. - Ratio de saturación del pool de conexiones (Pool Saturation Ratio): Relación entre los hilos de ejecución activos y el tamaño total del pool de workers. Cuando el pool alcanza el 85 % de ocupación, el servicio se queda sin margen de maniobra ante picos repentinos de tráfico.
- Percentil de latencia p99 en el borde del Ingress: El tiempo de respuesta de las peticiones más lentas avisa de una degradación mucho antes de que empiece a subir la latencia media p50.
Si estás diseñando pruebas de estrés para comprobar estas métricas, échale un ojo a nuestra guía: pruebas de carga realistas en Kubernetes: diseño de una suite en k6 para arquitectura de microservicios, donde se muestra cómo detectar estos umbrales de forma instrumental.
Configuración práctica de KEDA y del manifiesto HPA
Para escalar por métricas adelantadas, los recursos estándar de Kubernetes se quedan cortos: hace falta el operador KEDA (Kubernetes Event-driven Autoscaling) o un adaptador personalizado de métricas de Prometheus (Prometheus Adapter).
Aquí tienes un ejemplo listo para usar de manifiesto ScaledObject para KEDA que vigila la velocidad de crecimiento de una cola en Kafka y el tiempo en búfer:
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: order-processor-autoscaler
  namespace: production
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: order-processor
  minReplicaCount: 3
  maxReplicaCount: 30
  cooldownPeriod: 300
  pollingInterval: 15
  advanced:
    horizontalPodAutoscalerConfig:
      behavior:
        scaleUp:
          stabilizationWindowSeconds: 0
          policies:
            - type: Percent
              value: 100
              periodSeconds: 15
        scaleDown:
          stabilizationWindowSeconds: 300
          policies:
            - type: Percent
              value: 10
              periodSeconds: 60
  triggers:
    - type: kafka
      metadata:
        bootstrapServers: kafka-cluster:9092
        topic: orders.v1
        consumerGroup: order-workers
        lagThreshold: "50"
        activationLagThreshold: "10"
Y así se ve la configuración de un HPA estándar al conectar métricas externas de latencia del Ingress desde Prometheus, con protección frente al flapping (oscilación continua de réplicas):
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: api-gateway-hpa
  namespace: production
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: api-gateway
  minReplicas: 4
  maxReplicas: 40
  metrics:
    - type: External
      external:
        metric:
          name: ingress_request_duration_p99_seconds
          selector:
            matchLabels:
              service: api-gateway
        target:
          type: Value
          averageValue: 250m
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 0
      policies:
        - type: Pods
          value: 4
          periodSeconds: 15
    scaleDown:
      stabilizationWindowSeconds: 300
Fíjate en la sección behavior: al escalar hacia arriba, la ventana de estabilización se pone a cero para reaccionar al instante ante un pico, mientras que al escalar hacia abajo se fija una ventana de cinco minutos (stabilizationWindowSeconds: 300). Eso protege al clúster de crear y destruir pods en bucle cuando el tráfico llega en diente de sierra.
Pasar a métricas predictivas exige dedicar un tiempo a calibrar Prometheus, pero se amortiza en la primera gran campaña de ventas o en el primer repunte brusco de actividad de tus usuarios.