Todo desarrollador JavaScript ha escrito cientos de veces la misma llamada de manual: const res = await fetch(url); const data = await res.json();. Mientras la carga útil de la respuesta se mida en unas decenas de kilobytes, ese enfoque funciona de maravilla. El navegador descarga todo el búfer en memoria en un suspiro, el parser convierte al instante el JSON en un árbol de objetos y la aplicación sigue tan tranquila.
Pero imagina otro escenario: tu cliente pide exportar un informe analítico de 150 megabytes, un CSV pesado o está escuchando la respuesta en tiempo real de un modelo de lenguaje (LLM text streaming). Si intentas esperar a que se descargue todo el cuerpo con res.text() o res.blob(), la aplicación sufrirá un pico inmediato de memoria RAM, la pestaña del navegador se congelará varios segundos durante la recolección de basura y el usuario se quedará mirando con cara larga una pantalla en blanco.
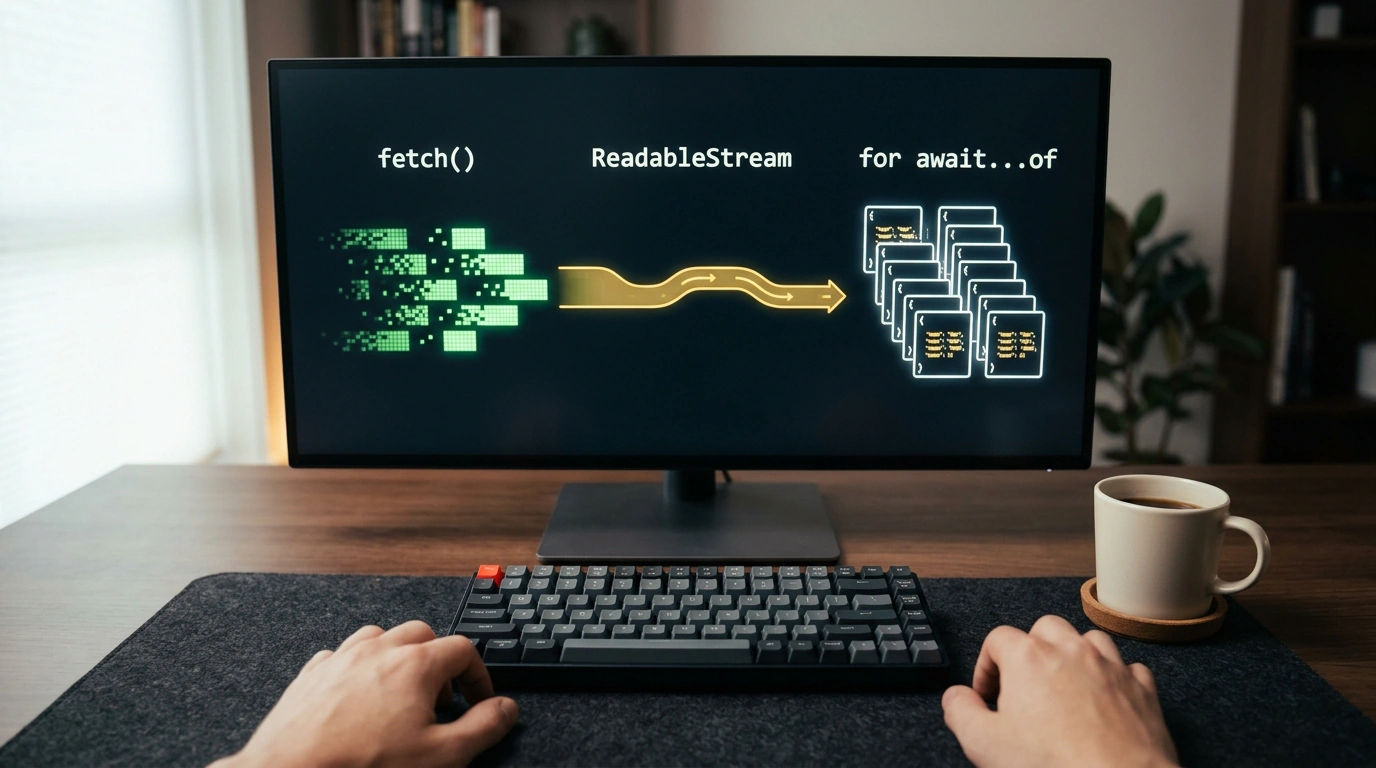
El estándar Fetch API y la especificación de flujos web Streams API ofrecen una solución nativa: response.body expone una interfaz completa de ReadableStream. Y gracias a que implementa el protocolo de iteración asíncrona Symbol.asyncIterator, puedes procesar el tráfico entrante en streaming con un simple y limpio bucle for await...of.
Anatomía del stream: por qué no basta con cortar bytes por los bordes
Veamos qué pasa a nivel de red cuando el servidor empieza a enviar una respuesta grande. La pila TCP del sistema operativo trocea el flujo de datos en segmentos y los entrega al adaptador de red. En JavaScript, esas porciones llegan como arrays binarios Uint8Array (chunks).
Cuando usas for await (const chunk of response.body), el bucle se despierta con cada chunk binario recibido. Eso te permite empezar a pintar datos al usuario de inmediato o lanzar un parseo línea a línea.
Sin embargo, aquí se esconde una trampa peligrosísima en la que caen muchos programadores: los caracteres multibyte UTF-8 partidos justo en la frontera entre chunks. En UTF-8, las letras latinas básicas ocupan 1 byte, pero las tildes, la eñe, los caracteres cirílicos o los emojis se codifican en secuencias de entre 2 y 4 bytes. Si el límite de un paquete de red cae justo en mitad de un emoji de cuatro bytes, la primera mitad llegará en el chunk actual y la segunda en el siguiente.
Si llamas de forma ingenua a new TextDecoder().decode(chunk) en cada paso del bucle, el decodificador tropezará con esos bytes sueltos, los dará por corruptos y los sustituirá por el símbolo de reemplazo ilegible `` (Unicode Replacement Character U+FFFD). Tus datos quedarán dañados sin remedio.
Para evitar ese desastre, se crea una única instancia de TextDecoder fuera del bucle y se le pasa el flag obligatorio { stream: true } al decodificar:
// Creamos la instancia del decodificador una sola vez antes de entrar al flujo
const utf8Decoder = new TextDecoder('utf-8');

async function processNetworkStream(url) {
  const response = await fetch(url);
  if (!response.ok) throw new Error(`HTTP error: ${response.status}`);
  if (!response.body) throw new Error('ReadableStream no está soportado');

  let totalBytesReceived = 0;

  // Iteración sobre el flujo de chunks mediante el iterador asíncrono nativo
  for await (const chunk of response.body) {
    totalBytesReceived += chunk.byteLength;

    // El flag stream: true indica al decodificador que guarde en búfer los bytes incompletos
    const textChunk = utf8Decoder.decode(chunk, { stream: true });
    renderIncrementalUI(textChunk, totalBytesReceived);
  }

  // Vaciado final del búfer residual del decodificador al cerrar el flujo
  const trailingText = utf8Decoder.decode();
  if (trailingText) renderIncrementalUI(trailingText, totalBytesReceived);
}
El flag { stream: true } obliga al decodificador a retener los bytes incompletos en su estado interno y unirlos con el siguiente chunk que llegue.
Parseo en streaming línea a línea de grandes datos (NDJSON y CSV)
El segundo caso habitual es procesar en streaming logs, métricas o tablas en formatos NDJSON (Newline Delimited JSON) y CSV, donde cada registro termina con un salto de línea . Un chunk de red casi nunca coincide con el final de una línea: una línea puede empezar en un chunk y terminar dos chunks después.
Aquí tienes un generador transformador probado que convierte un flujo de chunks arbitrarios de ReadableStream en un flujo de líneas de texto listas para usar, sin malgastar memoria:
async function* streamLines(readableStream) {
  const decoder = new TextDecoder('utf-8');
  let leftoverBuffer = '';

  for await (const chunk of readableStream) {
    leftoverBuffer += decoder.decode(chunk, { stream: true });
    const lines = leftoverBuffer.split('
');

    // El último elemento del array puede ser una línea incompleta: lo guardamos en el búfer
    leftoverBuffer = lines.pop() || '';

    for (const line of lines) {
      const trimmed = line.trim();
      if (trimmed.length > 0) yield trimmed;
    }
  }

  // Procesamos el resto de la última línea tras finalizar el flujo de red
  leftoverBuffer += decoder.decode();
  if (leftoverBuffer.trim().length > 0) {
    yield leftoverBuffer.trim();
  }
}

// Ejemplo de uso: parseo de un flujo pesado de líneas JSON
async function consumeEventStream(endpointUrl) {
  const response = await fetch(endpointUrl);
  for await (const line of streamLines(response.body)) {
    const payload = JSON.parse(line);
    dispatchApplicationEvent(payload);
  }
}
Ya vimos técnicas de uso austero de memoria en el artículo imprimir un libro a partir de un chat sin servidor: canvas, jsPDF y optimización de memoria, y la lectura en streaming de fetch lleva ese mismo enfoque a la capa de red.
Límites de aplicación y cancelación de peticiones
La especificación ReadableStream está soportada en todos los navegadores modernos y runtimes de servidor (Node.js 18+, Deno, Bun). Aun así, al montar pipelines en streaming conviene vigilar siempre el ciclo de vida:
- Interrupción del flujo: Pasa siempre a
fetchuna señal de cancelaciónAbortSignal. Si el usuario cambia de página o se desmonta el componente, llamar aabortController.abort()cerrará de inmediato la conexión de red y evitará fugas de sockets. - Backpressure (contrapresión): El bucle
for await...ofaplica contrapresión de forma nativa: solo pide el siguiente bloque de datos del búfer de red cuando termina el cuerpo de la iteración actual.
La lectura en streaming convierte el navegador de un almacén pasivo de datos en un pipeline reactivo de alto rendimiento, manteniendo estables los FPS de la interfaz incluso al procesar cientos de megabytes.