Si en los últimos meses intentaste levantar un clúster de cómputo nuevo en las nubes públicas de Amazon Web Services, Google Cloud o Microsoft Azure, seguro que te topaste con un fenómeno que hace un par de años nadie habría imaginado. En lugar de la asignación instantánea de máquinas virtuales de toda la vida, los proveedores devuelven cada vez más el seco error InsufficientInstanceCapacity, te hacen esperar semanas para aprobar solicitudes de aumento de cuota (quota requests) o directamente avisan de escasez de familias enteras de instancias en las regiones más populares.
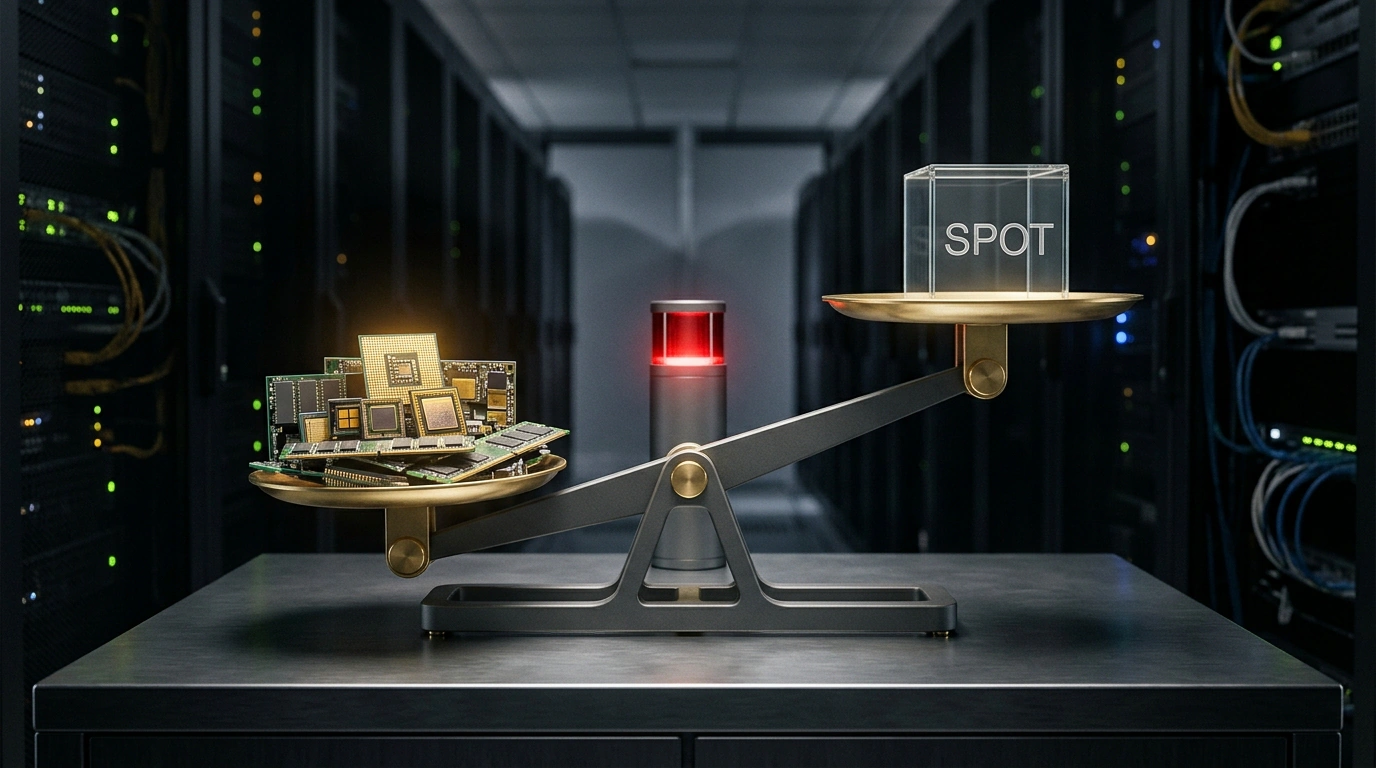
El golpe más duro ha caído sobre quienes dependían de las llamadas instancias spot (Spot / Preemptible Instances). Durante años, los arquitectos acostumbraron a los equipos a montar workers stateless, runners de CI y procesadores por lotes sobre capacidad spot a precio de saldo, ahorrando hasta un 70–80 % respecto a la tarifa base On-Demand. Ahora ese chollo se esfuma a toda velocidad: la nube reclama las máquinas spot con apenas dos minutos de aviso y las instancias de reemplazo ni siquiera llegan a arrancar por falta física de chips libres en los centros de datos.
En la publicación The Pragmatic Engineer salió un informe analítico detallado titulado «The Pulse: a new trend of CPU shortages», que deja al descubierto los engranajes ocultos de este giro global de infraestructura.
El auge de la inteligencia artificial contra los servidores x86 clásicos
Vayamos a la raíz del problema. Desde fuera parece que todo el mundo ha perdido la cabeza por las GPU de Nvidia H100 y B200, así que cabe preguntarse qué pintan aquí los procesadores de servidor convencionales de propósito general.
En la práctica, la relación es directa y implacable. Para hacer funcionar un megaclúster de entrenamiento e inferencia de grandes modelos de lenguaje, no basta con comprar miles de chips gráficos. Cada servidor de IA (como los Nvidia DGX o los superclústeres de los hiperescaladores) necesita potentes nodos anfitriones x86/ARM para coordinar el tráfico de red por InfiniBand, preparar tensores de datos, gestionar sistemas de archivos distribuidos y enrutar el contexto.
Como consecuencia, las fundiciones de silicio de TSMC, Intel y Samsung han chocado con un conflicto feroz por la capacidad limitada de fotolitografía y empaquetado avanzado de chips (CoWoS). Los fabricantes priorizan los conjuntos de silicio de alto margen destinados a la IA y recortan la producción de gamas estándar de servidor como AMD EPYC (Genoa, Bergamo) e Intel Xeon Scalable (Emerald Rapids, Granite Rapids).
Al mismo tiempo, los propios hiperescaladores (AWS, Azure, GCP) han desviado la mayor parte de sus servidores libres a sostener sus propios servicios insaciables de IA: asistentes generativos, bases de datos vectoriales y plataformas multimodales. El colchón de hardware de reserva que antes se liquidaba barato en la subasta spot simplemente se ha evaporado.
Por qué el multicloud y ARM tampoco salvan de la falta de capacidad
Muchos equipos confiaban en capear el temporal migrando a procesadores ARM de servidor eficientes diseñados por los propios proveedores, como AWS Graviton4 o Google Cloud Axion. Es verdad que su relación rendimiento por vatio es impresionante. Pero ahí también apareció un cuello de botella: la demanda de instancias Graviton creció más rápido de lo que los proveedores logran poner en servicio nuevos racks.
Además, la escasez ha dejado al descubierto un fallo de base en el multicloud ingenuo. Tener una infraestructura repartida entre varios proveedores no te blinda frente a fallos de suministro: las fábricas de chips son las mismas para todos los vendedores, y cuando las placas de servidor se retrasan entre 6 y 9 meses, hacen cola por igual Microsoft, Amazon y los proveedores regionales pequeños.
Ya analizamos la arquitectura de entornos aislados en Cloudroom: arquitectura de sandboxes cloud aislados para ejecutar cientos de agentes de IA a la vez, donde subrayábamos que planificar la densidad de cómputo por núcleo se ha vuelto una habilidad crítica para cualquier desarrollador moderno.
Cómo rediseñar la arquitectura en tiempos de escasez de hardware
Para los engineering leads y equipos de DevOps llegan tiempos de revisar a fondo las costumbres de infraestructura:
- Dejar de fiarlo todo a las instancias spot en servicios críticos: Las máquinas spot ya no pueden tratarse como un pool de cómputo garantizado. Si un servicio debe sostener un SLA del 99,9 %, su base tiene que apoyarse en capacidad reservada (Reserved Instances o Savings Plans) con garantía explícita de disponibilidad (Capacity Reservations).
- Optimización agresiva de compilación y runtimes: Se acabó la época de escalar contenedores a lo ancho sin mirar (scale-out). Migrar servicios de lenguajes interpretados poco optimizados a Go, Rust o Java compilado (GraalVM), afinar el recolector de basura y reducir asignaciones de memoria permite exprimir entre 3 y 5 veces más RPS de exactamente los mismos núcleos de CPU.
- Diversificación geográfica con reserva en frío: En lugar de pelear por cuotas escasas en regiones centrales (US-East o EU-Central), toca repartir la infraestructura por regiones secundarias y preparar failover automático.
La era del silicio en la nube barato e ilimitado ha terminado. En los próximos años llevarán ventaja los equipos de ingeniería que sepan calcular el coste real de cada ciclo de CPU y escribir código eficiente y austero.