En el desarrollo actual de sistemas multiagente se da una paradoja curiosa. Por un lado, los laboratorios lanzan modelos gigantescos con un nivel fenomenal de inteligencia y razonamiento. Por otro, cuando un desarrollador intenta montar un empleado de IA integral, acaba obligando a ese superordenador carísimo a hacer tareas rudimentarias: extraer correos con expresiones regulares, formatear fechas y parsear etiquetas HTML sencillas.
Eso no solo resulta absurdamente caro, sino también lento. Un modelo pesado con cientos de miles de millones de parámetros tarda inevitablemente segundos en generar cada token allí donde una red compacta especializada resolvería el encargo en milisegundos.
El grupo de investigación Nous Research propuso una salida elegante a este callejón lanzando la arquitectura Hermes Advanced Delegation dentro de su ecosistema abierto Hermes Agent. Ya vimos cómo funciona el sistema operativo para agentes Hermes Agent OS y repasamos casos prácticos de agentes autónomos. En esta nueva actualización, el protagonismo pasa a la delegación inteligente de responsabilidades entre perfiles de modelos de distinto calibre.
El problema del modelo orquestador y el precio de la universalidad
Seamos sinceros: la idea de «un único modelo para todo» ha tocado techo en los pipelines industriales complejos.
Cuando el sistema afronta un objetivo amplio —por ejemplo, auditar la seguridad informática de un servicio web externo, trazar un mapa de vulnerabilidades y preparar un informe ejecutivo—, el proceso se fragmenta en decenas de operaciones muy distintas:
- Planificación arquitectónica y elección de estrategia de reconocimiento (exige razonamiento analítico profundo de primer nivel).
- Escaneo masivo de puertos, normalización de cientos de cabeceras HTTP y filtrado de ruido (pura rutina mecánica).
- Reconocimiento de CAPTCHA poco habituales y elementos gráficos de la página (visión multimodal).
- Maquetación final del documento respetando el Tone of Voice corporativo (generación de texto estilísticamente cuidado).
Si le encargas todas esas fases a un único modelo de gama alta, acabarás con una factura astronómica de tokens, atascos continuos en red y un riesgo muy serio de que a mitad de camino el modelo sature su contexto con volcados en bruto de paquetes de red y olvide la tarea original.
Cómo funciona el protocolo de delegación entre modelos especializados
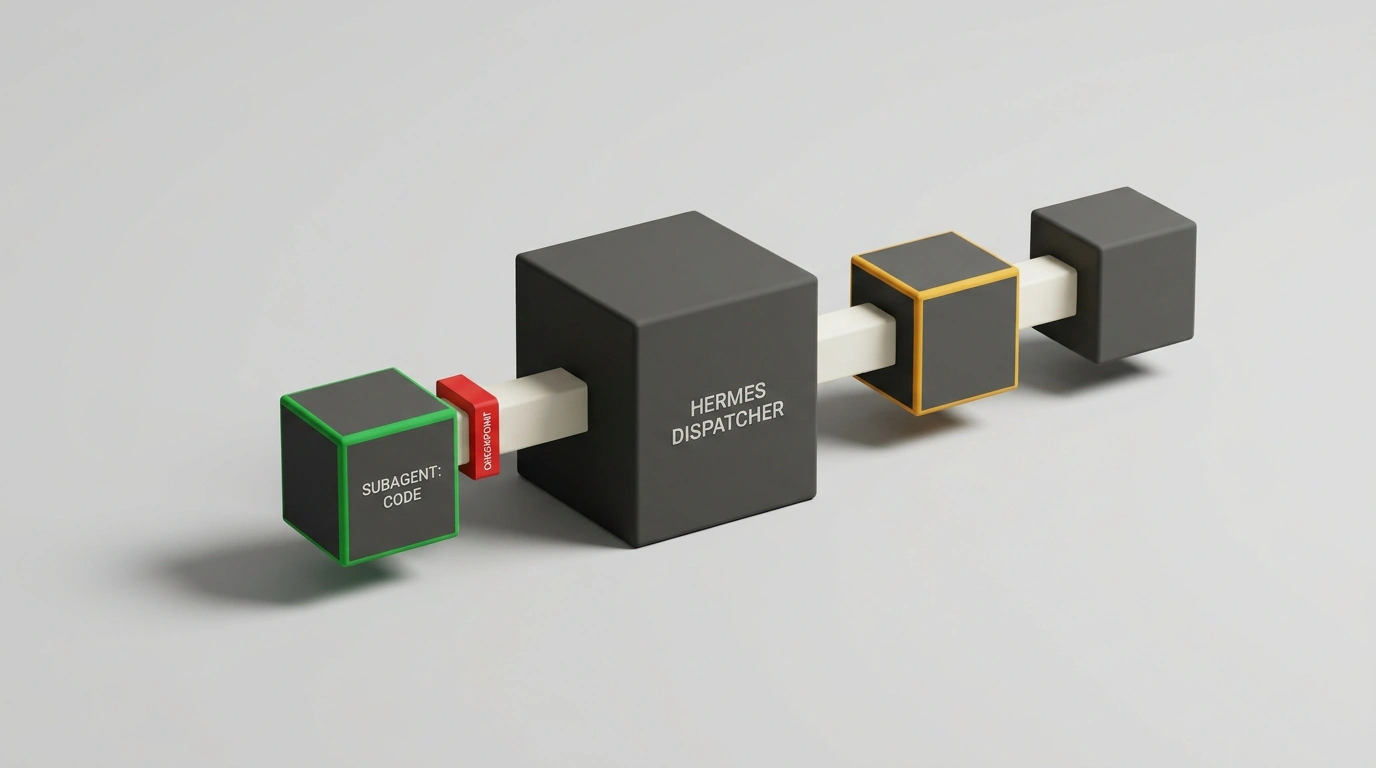
El framework Hermes Advanced Delegation implanta un reparto claro por roles, con un Coordinador Principal (Orchestrator) al mando y un grupo de subagentes especializados (Subagents) bajo sus órdenes.
Toda la comunicación sigue un protocolo estricto de delegación con contratos tipados:
- Descomposición de la tarea. El coordinador (normalmente apoyado en pesos del nivel de Hermes 3 o Claude Opus) divide la petición entrante en bloques autónomos y redacta para cada subagente un paquete de contexto aislado (Delegation Brief).
- Enrutamiento por perfiles. Cada subtarea recibe la etiqueta del recurso necesario:
- Las operaciones ligeras de extracción de entidades y manejo de archivos pasan a modelos locales ultrarrápidos de 4B–8B (como Nemotron Bolt o Llama 3.2 8B).
- El análisis visual de capturas de pantalla se dirige a modelos Vision compactos.
- La síntesis compleja y las bifurcaciones lógicas quedan en manos del coordinador.
- Ejecución aislada. El subagente arranca en su propio entorno aislado, recibe únicamente los datos pertinentes sin cargar megabyte y medio de historial previo y ejecuta la orden.
- Retorno por contrato (Structured Return). El resultado vuelve al coordinador como un objeto JSON validado según una estructura fija. Si un subagente falla o agota su tiempo límite, el coordinador detecta el error y puede reasignar la tarea a otro ejecutor.
Sincronización de estado y defensa contra fallos en cascada
La vulnerabilidad más peligrosa de los sistemas agénticos distribuidos es el fallo en cascada (cascading failure). Imagina que un subagente de primer nivel alucina un parámetro inexistente, se lo pasa al segundo agente, este construye encima una hipótesis falsa y el tercer agente pierde media hora comprobando algo sin sentido.
En Hermes Advanced Delegation la defensa se apoya en puntos de control de verificación (State Checkpoints):
- El coordinador no da por bueno «a ciegas» el trabajo de los modelos subordinados.
- Cada artefacto devuelto atraviesa una compuerta automática por software (validación de esquema, comprobación de que existen las rutas o enlaces generados).
- El estado global del proyecto reside en un grafo centralizado de tareas (Task Graph), de solo lectura para los agentes ejecutores y de escritura exclusiva para el orquestador central.
Si un modelo menor empieza a producir disparates o entra en bucle repitiendo la misma llamada a la API, el coordinador corta su contexto con limpieza, registra el incidente y reduce la temperatura de generación o escala la subtarea a un perfil de modelo más capaz.
Equilibrio práctico: ahorro de tokens y velocidad de respuesta
Probé la arquitectura Advanced Delegation en una tarea compleja de recopilación analítica: monitorizar cincuenta startups tecnológicas, extraer datos de rondas de financiación desde notas de prensa y generar una tabla comparativa.
Los números hablan por sí solos:
- El consumo de tokens caros del modelo insignia cayó un 74%. El coordinador gastó apenas unos 12,000 tokens en planificación, coordinación y síntesis final.
- El tiempo total de ejecución se redujo casi a un tercio. Mientras un modelo grande en solitario habría ido leyendo documentos uno tras otro, los subagentes ligeros de 4B procesaron las cincuenta páginas en paralelo a través de decenas de hilos.
- El coste global del pipeline bajó más de cinco veces, gracias a que la inmensa mayoría de los tokens recayeron en inferencia local gratuita o APIs ligeras de coste mínimo.
Esto confirma una verdad simple: el futuro de la inteligencia artificial práctica no pasa por inflar sin límite el tamaño de un único modelo, sino por orquestar con buen criterio de ingeniería herramientas especializadas.