Si alguna vez has intentado automatizar desarrollo o analítica compleja con modelos de lenguaje, seguro que conoces esa sensación de agotamiento por vigilancia constante. Te sientas frente al terminal, escribes la petición, esperas la respuesta, ves un error en el código, lo copias de vuelta al chat, le explicas el contexto al modelo... y así veinte veces en una misma tarde. En teoría la IA escribe el código, pero el verdadero «enlace de transmisión» y coordinador sigues siendo tú.
Con la llegada de Claude Opus 5.5 de Anthropic, ese ping-pong manual por fin pasa a la historia. El modelo ha adquirido la capacidad nativa de sostener la lógica de ciclos autónomos continuos (agentic loops), trabajando sin intervención del operador a lo largo de decenas de iteraciones seguidas.
Ya investigamos a fondo cómo funcionan las gradaciones de razonamiento en Claude Opus 5.5 según el nivel de esfuerzo y seguimos el avance de los compañeros personales de IA Claude Duet y Open Duet. Ahora vamos a desgranar cómo organizar un ciclo autónomo fiable que no se quede atrapado en bucles infinitos ni queme el presupuesto de la empresa sin sentido.
El ciclo de cuatro tiempos: por qué ya no hace falta un diálogo lineal
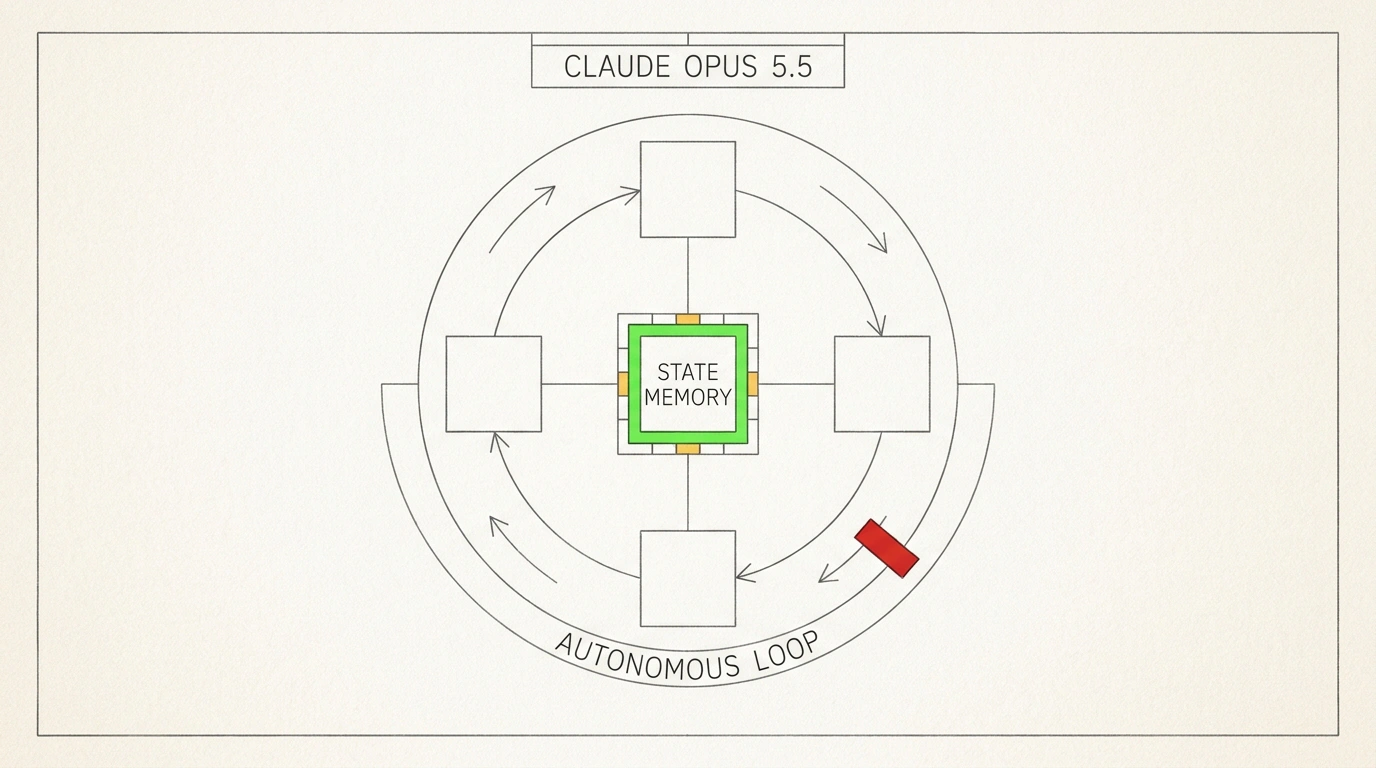
En el paradigma clásico de uso de los LLM, la interacción es lineal: la pregunta del usuario genera la respuesta del asistente. En un ciclo autónomo, ese esquema se sustituye por un motor de cuatro tiempos:
- Planificación (Plan). Al recibir un objetivo de alto nivel (por ejemplo, «localizar y corregir la fuga de memoria en el microservicio de autenticación»), el modelo lo descompone en una lista de subtareas verificables y fija criterios de éxito.
- Acción (Act). El modelo elige la herramienta adecuada del manifiesto del sistema (ejecutar grep sobre el código, leer un archivo, lanzar un perfilador de memoria o compilar el binario) y emite una orden estructurada.
- Evaluación (Evaluate). Al recibir de vuelta en el contexto la salida de la herramienta, el modelo la compara con el resultado esperado. Si las pruebas fallan, no abandona el trabajo, sino que pasa a analizar el stacktrace.
- Corrección (Refine). A partir de la retroalimentación real, el algoritmo ajusta el plan o modifica líneas del código fuente, y el ciclo vuelve a empezar.
Este enfoque cambia la esencia misma de trabajar con el modelo. Tú marcas el rumbo general y te vas a preparar un café mientras el agente prueba hipótesis metódicamente, aísla el bug y ejecuta las pruebas unitarias hasta obtener un informe limpio en verde.
Memoria estructurada y protocolo de uso de herramientas
El mayor enemigo de cualquier ciclo largo es la contaminación de la ventana de contexto (context drift). Si vas volcando en un único flujo toda la salida en bruto del terminal, los logs de compilación y los razonamientos intermedios, al cabo de 15 pasos el modelo pierde el objetivo inicial y empieza a dar vueltas en círculo.
Al trabajar con Claude Opus 5.5, la pieza clave es una memoria externa estructurada, implementada a menudo como un bloc de notas de trabajo (scratchpad):
- Al inicio de cada paso, el agente actualiza un bloque de sistema
<current_state>donde resume brevemente qué se ha comprobado ya, qué hipótesis ha quedado descartada y qué paso se está ejecutando en ese momento. - Los logs pesados de las utilidades se comprimen dejando solo las líneas clave de error, y los archivos fuente se leen únicamente por fragmentos mediante paginación línea a línea.
- El protocolo de llamada a herramientas se estandariza con esquemas JSON estrictos (tool definitions), evitando alucinaciones en la sintaxis de parámetros de línea de comandos.
Gracias a su potente motor de razonamiento, Opus 5.5 mantiene firmes las relaciones causa-efecto incluso cuando una tarea exige entre 30 y 40 llamadas consecutivas a utilidades externas.
Lucha contra alucinaciones y bucles: criterios de parada
Todo desarrollador de sistemas autónomos ha sufrido la pesadilla del «bucle eterno»: el modelo encuentra un fallo, intenta corregirlo, rompe el módulo vecino, revierte el cambio, vuelve a chocar con el primer error... y repite esa ronda hasta agotar el saldo de la API.
Para evitar este tipo de escenas, la arquitectura debe apoyarse en fusibles programáticos estrictos (stopping criteria):
- Contador de iteraciones sin avance. Si durante los últimos tres ciclos el hash de los archivos modificados coincide con estados anteriores o el número de pruebas fallidas no baja, el ciclo se detiene a la fuerza y pide intervención humana.
- Presupuesto de tokens por tarea. Para cada ejecución autónoma se fija un tope máximo de gasto total (por ejemplo, no más de 500,000 tokens por sesión).
- Verificador externo. La decisión final de dar la tarea por cerrada no la toma el propio agente («ya lo he arreglado todo»), sino un proceso determinista del sistema: la ejecución completa de la batería de pruebas de integración dentro de un contenedor aislado.
Economía de tokens: caché de prompts y optimización del gasto
Si lanzas un ciclo autónomo a lo bruto, la factura de la API puede asustar hasta a una startup con buena financiación. Imagina que en cada uno de los cuarenta pasos envías al modelo toda la instrucción del sistema, la descripción de las herramientas y el historial acumulado de pasos. Son cientos de miles de tokens multiplicados por la tarifa de un modelo insignia.
La salvación aquí es la tecnología de caché de prompts (Prompt Caching), soportada de forma nativa en la API de Anthropic. La parte estática del contexto —arquitectura del sistema, documentación del proyecto, reglas base y definiciones de herramientas— se marca con una bandera especial de cacheo:
- Al volver a consultarla en un margen de 5 minutos, el coste de lectura del contexto en caché cae un 90% respecto a la tarifa base.
- El tiempo hasta el primer token (TTFT) baja de 8–10 segundos a una fracción de segundo.
Como resultado, el coste de una sesión compleja de depuración autónoma de treinta minutos pasa de decenas de dólares a apenas un par de cientos de céntimos. Eso convierte los ciclos autónomos no en un juguete llamativo para demos, sino en una solución comercialmente viable para producción real.