Cuando a mediados de 2024 Anthropic presentó la función Projects dentro de la interfaz web de Claude, una ola de euforia recorrió el mundo corporativo. Parecía que por fin habíamos dado con el santo grial de la automatización. La receta sonaba ridículamente sencilla: reúne en una carpeta todos los informes PDF de la empresa, manuales de ventas, descripciones de puesto, guías de marca con el Tone of Voice y ejemplos de correos exitosos, arrástralos a la ventana del proyecto... ¡y listo! Frente a ti tendrías al empleado digital perfecto, conocedor de cada rincón de tu negocio y preparado para entregar resultados impecables al instante.
Sin embargo, pocos meses después la euforia dio paso a una frustración sorda. Directivos y equipos de marketing descubrieron que aquellos «proyectos inteligentes» rendían fatal. Ante consultas complejas, el modelo soltaba respuestas aguadas y estériles, mezclaba tarifas antiguas con nuevas, contradecía sus propias reglas e ignoraba con obstinación puntos críticos de los manuales.
¿Dónde está el origen de esta crisis? ¿Por qué confiar en contextos estáticos gigantes resultó ser una ilusión peligrosa y cómo hay que diseñar realmente soluciones industriales sobre Claude 3.5 Sonnet y Claude Opus 5.5?
Las respuestas llegaron de la mano de dos referentes mundiales en implantación corporativa de IA generativa: Kieran Flanagan (ex-CMO de HubSpot y copresentador del pódcast analítico Marketing Against the Grain) y Ruben Hassid (fundador de una plataforma educativa sobre ingeniería de prompts). Ya estudiamos la experiencia de montar empresas unipersonales sobre el stack de Claude y agentes de IA y repasamos las reglas de ingeniería de prompts del ingeniero principal de Anthropic Felix Rieseberg. Ahora nos metemos de lleno en la anatomía del prompting dinámico y en seis arquetipos arquitectónicos universales que convierten a Claude en un núcleo operativo infalible.
La ilusión del contexto estático: por qué volcar documentos en Claude Projects no funciona
Digamos la verdad sin rodeos: la costumbre de apilar documentos en carpetas estáticas de proyectos (Projects) es lo peor que puedes hacerle a un modelo de lenguaje.
A primera vista parece que una ventana de contexto de 200,000 tokens o incluso de un millón elimina cualquier límite. Pero la arquitectura de los transformers reparte la atención de todo menos de forma uniforme. Cuando subes veinte archivos que suman cien mil tokens a un proyecto, se desencadenan varios procesos destructivos a la vez:
- Dilución del contexto (Context Dilution). El mecanismo de autoatención tiene que cruzar continuamente cada palabra de tu consulta con una montaña de material de referencia. Cuanto más ruido sobrante haya en el contexto, menor es la probabilidad de que el modelo se concentre en la frase decisiva.
- Erosión de la vigencia (Knowledge Decay). En cualquier empresa viva los procesos cambian cada semana: salen promociones nuevas, se ajustan políticas de devolución, se actualizan guiones de objeciones. Un PDF olvidado en la carpeta desde hace seis meses se convierte en una fábrica constante de alucinaciones tóxicas que el modelo sirve con total confianza a los clientes.
- Contradicciones internas. Si un manual de marca de 2023 dice «tratamos siempre de usted y mantenemos un tono académico» y una guía reciente de redes pide «escribe con desparpajo y tutea», el modelo promedia ambas órdenes. El resultado es un Frankenstein torpe que no cumple ningún estándar.
El simple hecho de subir un archivo a un proyecto no crea en el modelo un reflejo de comportamiento. Hace falta un enrutador algorítmico estricto que entregue justo el conocimiento necesario en el instante preciso de tomar la decisión.
Anatomía de la degradación de atención: el efecto de pérdida en mitad de la ventana
En el ámbito académico, el deterioro de los modelos sobre contextos largos se conoce desde hace tiempo como Lost in the Middle («Perdidos en el medio»).
Los estudios demuestran que los transformers recuerdan mucho mejor la información situada al principio del contexto (efecto de primacía) y al final (efecto de recencia). Si una regla clave o una excepción crítica de tarifa quedó enterrada en la página cuarenta de un documento colocado en mitad del paquete, la probabilidad de que el modelo la recuerde al responder se desploma.
Piensa en la memoria humana: si antes de un examen le das a un estudiante una enciclopedia de quinientas páginas y luego le preguntas por una nota al pie de la página 248, se quedará en blanco. La red neuronal reacciona igual. En lugar de intentar mantener en cabeza una enciclopedia estática enorme, un ingeniero actual construye un sistema que extrae de la base de datos exactamente el párrafo necesario y se lo entrega al modelo justo antes de generar la respuesta.
Esa es la base de la metodología de inyección dinámica de contexto (Dynamic Context Injection).
Para evitar que ese enrutamiento dinámico acabe en un caos de scripts improvisados, Flanagan y Hassid formalizaron seis arquetipos fundamentales de prompt que cubren el 95% de las necesidades corporativas:
- Arquetipo «Extractor» (The Extractor). Convierte flujos desestructurados (transcripciones de llamadas en Zoom, entrevistas, contratos legales, reseñas en bruto) en tablas estrictamente tipadas o esquemas JSON. Su ley de hierro es prohibir por completo inventar datos: si en el texto no figura el importe exacto del acuerdo o el cargo del contacto, el campo debe quedar obligatoriamente como
null. - Arquetipo «Oponente crítico» (The Adversary / Critic). Actúa como un rival implacable para someter a pruebas de estrés hipótesis de marketing, planes de negocio y esquemas de arquitectura antes de invertir dinero real. Tiene terminantemente prohibido repartir halagos: debe localizar cinco vulnerabilidades críticas y simular el peor escenario posible.
- Arquetipo «Sintetizador de sentido» (The Synthesizer). Cruza capas de información dispares —métricas del embudo publicitario, encuestas de bajas de clientes y registros de tickets de soporte— para descubrir relaciones causa-efecto que pasan desapercibidas a primera vista.
- Arquetipo «Orquestador de procesos» (The Orchestrator). Descompone un objetivo abstracto de dirección en un árbol detallado de pasos con estimación de recursos, dependencias y criterios claros de terminado (Definition of Done).
- Arquetipo «Calibrador de voz» (The Voice Mimic). Reproduce el estilo único de escritura de un fundador o experto de la compañía a partir de un análisis estilométrico previo de textos de referencia dentro del bloque
<scratchpad>. - Arquetipo «Compuerta de cumplimiento» (The Policy Gate / Governor). Funciona como un auditor imparcial de calidad que coteja cualquier contenido saliente con los requisitos legales y la normativa interna.
Arquitectura de enrutamiento dinámico: entrega de manuales justo a tiempo
El prompting dinámico parte de una premisa clara: el contexto no es un almacén fijo, sino una función variable de la acción actual (Context-as-a-Function).
En lugar de cargar de golpe todos los manuales de la empresa en la ventana activa del modelo, la arquitectura se divide en dos circuitos independientes:
- Almacén externo estructurado. Todas las reglas, plantillas, bases de conocimiento y fichas de producto viven fuera, en una base de datos (vectorial como Pinecone, relacional como PostgreSQL o un directorio local de archivos Markdown).
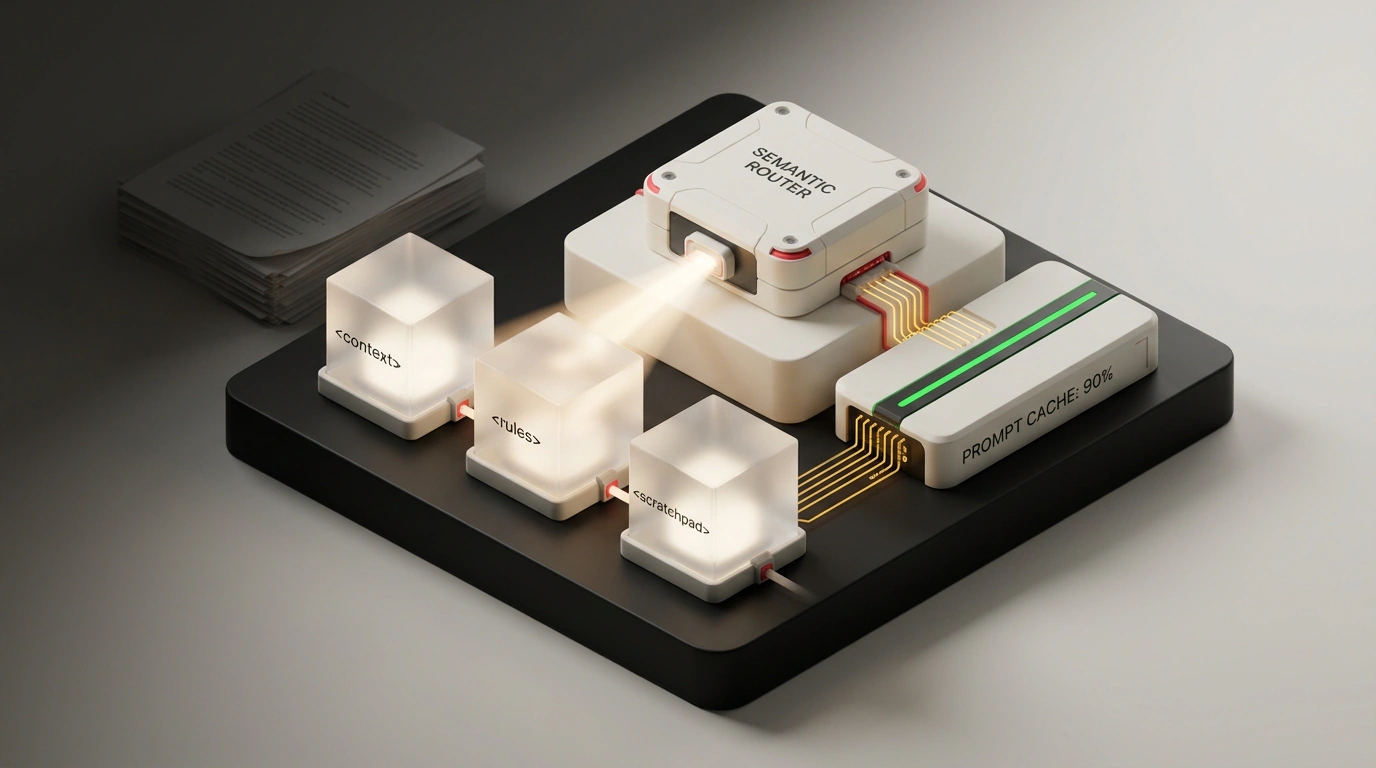
- Enrutador semántico (Semantic Router). Cuando entra una petición de un usuario, un clasificador ligero analiza su intención. Si el cliente pregunta por un reembolso, el sistema extrae dinámicamente de la base únicamente el protocolo de devoluciones (dos páginas de texto) y lo empaqueta en el prompt. Si pregunta por el programa de afiliados, inyecta el contrato de afiliación.
Como resultado, el volumen de contexto cae de doscientos mil tokens a tres mil. El modelo ve únicamente una instrucción limpia, coherente y vigente sobre el tema exacto. La densidad de atención se multiplica y el riesgo de alucinaciones baja prácticamente a cero.
Prompts XML modulares: separación de roles, reglas y memoria de trabajo
Para que Claude opere con la máxima precisión matemática, los ingenieros de Anthropic recomiendan marcar las secciones con etiquetas XML estrictas. Los modelos de la familia Claude recibieron entrenamiento específico sobre documentos XML estructurados, por lo que interpretan esas etiquetas como fronteras absolutas del sistema que separan instrucciones de datos de usuario.
Esquema infográfico de un prompt modular XML de Claude con cuatro bloques funcionales sobre pizarra de grafito
La arquitectura base de un prompt modular industrial se reparte en cuatro bloques clave:
<system_identity>
Eres auditor sénior de seguridad informática. Tu único objetivo es encontrar vulnerabilidades en la base de código.
</system_identity>

<context>
{aquí se inserta dinámicamente el fragmento relevante de documentación}
</context>

<rules>
- Nunca inventes parámetros que no aparezcan en los datos de entrada.
- Si falta información, devuelve el estado UNVERIFIED.
- Responde estrictamente en formato JSON según el esquema indicado.
</rules>

<scratchpad>
Antes de generar la respuesta, realiza un análisis paso a paso dentro de este bloque:
1. Identifica las entidades clave.
2. Comprueba coincidencias con la lista de excepciones.
3. Formula la conclusión final.
</scratchpad>
El bloque <scratchpad> (borrador de razonamiento) tiene un valor enorme. Cuando el modelo verbaliza sus pasos y contrasta hipótesis dentro de las etiquetas del borrador, genera físicamente tokens intermedios de razonamiento. Eso dispara la coherencia lógica y evita errores precipitados en la salida final.
Economía del cacheo: cómo reducir la latencia y recortar el 90% del gasto en API
Llevar Claude a un entorno corporativo serio resulta inviable sin dominar la economía de la caché de prompts (Prompt Caching). Antes de esta tecnología, cada llamada a la API cobraba al precio completo todo el contexto enviado. Si tu prompt de sistema con ejemplos ocupaba 30,000 tokens, con mil consultas diarias quemabas sumas astronómicas reenviando exactamente el mismo texto una y otra vez.
En la API de Anthropic, el mecanismo de caché funciona con una limpieza admirable:
- Marcas la parte estática de tu prompt (reglas del sistema, esquema JSON, ejemplos fijos de buenas respuestas) con el parámetro especial
cache_control: {"type": "ephemeral"}. - En la primera petición, el servidor compila la representación interna de ese contexto y la guarda en una caché de alta velocidad durante 5 minutos.
- En cada consulta posterior que reutilice ese bloque en caché, pagas solo el 10% de la tarifa base por los tokens de entrada.
- La vida útil de la caché se renueva automáticamente otros 5 minutos con cada nuevo acierto.
Pero el ahorro económico es solo la mitad del premio. La otra mitad es el tiempo de respuesta (TTFT). Procesar un bloque cacheado de 50,000 tokens no le lleva a los servidores 6–8 segundos, sino apenas 300–500 milisegundos. Tu servicio empieza a contestar al usuario con una agilidad interactiva sorprendente.
Compuertas de validación: esquemas JSON estrictos y control de alucinaciones
Incluso el prompt mejor diseñado puede fallar si un día el modelo decide ponerse creativo donde no toca. En automatización empresarial, el texto libre sin estructura es el mayor dolor de cabeza para el equipo de backend: es imposible parsear de forma fiable con expresiones regulares un relato improvisado de la IA sobre qué descuento ha decidido conceder a un cliente.
La solución pasa por implantar compuertas estrictas de validación:
- Salida forzada en JSON (Structured Outputs). Se entrega al modelo un esquema Pydantic o JSON Schema que fija tipos de campo, atributos obligatorios y rangos válidos (Enums).
- Verificador programático (Validator Gate). La respuesta del modelo no sale directa hacia el cliente. Pasa por un backend local que valida la estructura con una librería de parseo. Si falta un campo obligatorio o la fecha no es válida, el sistema reintenta automáticamente indicando el error exacto de validación.
- Compuerta de cumplimiento (Policy Gate). Antes de despachar documentos sensibles, un agente auditor pasa el texto por una lista de verificación binaria para confirmar respeto a la normativa de datos personales, tono adecuado y ausencia de promesas falsas.
Análisis de un despliegue real: soporte al cliente automatizado con SLA medible
Juntemos toda la teoría en un caso práctico real: la automatización de la primera línea de soporte en una empresa de servicios B2B en la nube.
Antes, la compañía había probado un chatbot convencional cargándole de golpe los 150 artículos de su base de conocimiento. El bot se liaba sin parar, recomendaba funciones de planes descatalogados y obligaba a intervenir a operadores humanos constantemente. La tasa de resolución en el primer contacto (First Contact Resolution, FCR) se arrastraba por un triste 28%.
Los ingenieros reconstruyeron el sistema siguiendo la nueva metodología:
- Paso 1: Clasificación semántica. La consulta entrante pasa por un enrutador ligero que en 50 milisegundos identifica la categoría del problema (facturación, fallo en API, integración con CRM, duda general).
- Paso 2: Ensamblado dinámico de contexto. De la base de conocimiento se extrae exactamente el artículo pertinente con los parámetros vigentes de la API y el estado actual de incidencias en servidores.
- Paso 3: Prompt modular con caché. A Claude Opus 5.5 se envía el bloque de sistema en caché con las reglas de cortesía y el esquema JSON, insertando dinámicamente el artículo actualizado y el mensaje del cliente. Dentro de
<scratchpad>, el modelo comprueba primero el estado de los servidores, revisa los permisos del usuario y solo entonces redacta la respuesta. - Paso 4: Compuerta de software. La respuesta se revisa para descartar promesas prohibidas (del tipo «devolveremos el dinero en una hora») y se envía al sistema de tickets.
Los resultados superaron cualquier expectativa:
- El FCR saltó del 28% al 79%.
- El tiempo medio de respuesta al cliente bajó de 14 minutos a 18 segundos.
- El gasto en llamadas a la API cayó 7 veces gracias al cacheo de los bloques estáticos de instrucciones.
- Las quejas por desinformación del bot cayeron prácticamente a cero estadístico.
Esta clase magistral deja una lección muy clara: el éxito de la IA en la empresa no depende de creer ciegamente en la magia de las redes neuronales, sino de aplicar disciplina de ingeniería madura. Deja atrás los vertederos de archivos estáticos, construye el contexto de forma dinámica para cada tarea, adopta estructuras XML modulares y recorta costes con caché: tus sistemas darán un salto inmediato de fiabilidad.