Durante mucho tiempo, el mundo de la IA generativa estuvo dominado por la gigantomanía. Las corporaciones competían por ver quién construía el modelo con más ceros en su cifra de parámetros: 70 mil millones, 400 mil millones, tres billones. Pero cuando un desarrollador baja de las nubes de las presentaciones comerciales al suelo del desarrollo real de producto, choca con la cruda realidad: mantener un parque propio de servidores con tarjetas H100 es carísimo, y las API públicas en la nube sufren latencia de red, colas y caídas periódicas.
¿Y si para la mayoría de tareas agénticas cotidianas —enrutamiento de órdenes, llamada a funciones (function calling), parseo de JSON y clasificación de datos entrantes— simplemente no hicieran falta modelos gigantes?
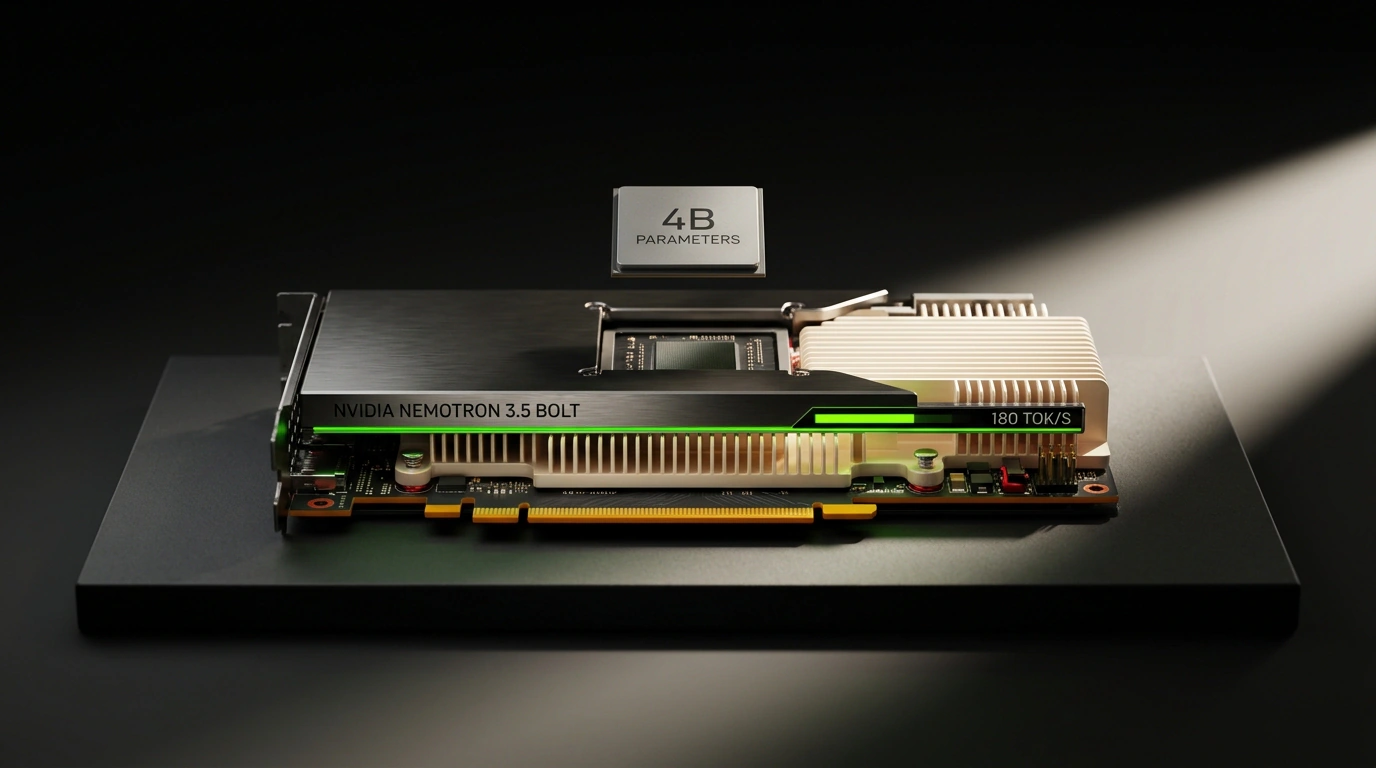
NVIDIA ha respondido a esa pregunta lanzando Nemotron 3.5 Bolt, un modelo compacto de 4 mil millones de parámetros (4B) diseñado específicamente para inferencia local ultrarrápida en tarjetas gráficas de consumo GeForce RTX. Ya analizamos las capacidades multimodales de la serie Nemotron 3.5 Super VL y probamos arquitecturas híbridas locales. Veamos qué es capaz de hacer este pequeño de 4B en combate real.
Un modelo pequeño con maneras de gigante: arquitectura de 4B parámetros
Crear un buen modelo pequeño es bastante más difícil que entrenar a un coloso. Mientras en un modelo de 70B la redundancia de pesos perdona imperfecciones del dataset, en un tamaño de 4B cada parámetro individual debe cargar con el máximo peso semántico posible.
En Nemotron 3.5 Bolt, los ingenieros de NVIDIA aplicaron un proceso multietapa de destilación de conocimiento (knowledge distillation) desde sus modelos propietarios insignia Nemotron Ultra, reforzado con aprendizaje por refuerzo especializado sobre trazas sintéticas de uso de herramientas (Tool Calling RL):
- El modelo no se entrenó con literatura de ficción ni diálogos inconexos, sino con millones de ejemplos estrictos de interacción con APIs, generación de código válido y cumplimiento de instrucciones de sistema.
- La arquitectura incorpora un vocabulario ampliado del tokenizador optimizado para la sintaxis de lenguajes populares (Python, TypeScript, Go, Rust, Bash).
- La ventana de contexto nativa alcanza los 64,000 tokens, más que suficiente para sostener archivos medianos de documentación o esquemas de bases de datos.
Ejecución en tarjetas RTX de consumo: cuantización y velocidad de 180 tokens
La mejor noticia para entusiastas y desarrolladores independientes son sus requisitos de hardware sorprendentemente modestos. Para arrancar Nemotron 3.5 Bolt no hacen falta racks de servidores con refrigeración líquida:
- En formato de 8 bits (FP8), el modelo ocupa alrededor de 4.5 GB de memoria de vídeo.
- Con cuantización agresiva a 4 bits (INT4 / AWQ), el peso baja hasta unos increíbles 2.6 GB, lo que permite ejecutarlo incluso en gráficas económicas de portátil como una RTX 4050 o RTX 4060 con 6–8 GB de VRAM.
- Al correr sobre el motor especializado TensorRT-LLM, la velocidad de generación en una RTX 4070 o RTX 5070 de sobremesa supera los 180 tokens por segundo.
Cuando el texto fluye por la pantalla a ese ritmo, la interacción deja de sentirse como hablar con un servidor remoto. La respuesta aparece al instante, sin rastro de espera inicial (el TTFT se sitúa literalmente entre 15 y 25 milisegundos).
Enrutamiento de peticiones y llamada a funciones en hardware local
¿Dónde saca el compacto Bolt el 100% de su potencial? Su especialidad estrella es actuar como pasarela local de enrutamiento (Router & Function Caller).
Imagina un sistema corporativo complejo de automatización:
- Entran miles de solicitudes heterogéneas de usuarios por minuto.
- Enviar cada petición a un modelo caro en la nube tipo Claude Opus o GPT-6 sería un suicidio financiero.
- En su lugar, levantas en local una instancia de Nemotron 3.5 Bolt.
El pequeño analiza el texto al instante, clasifica la intención del usuario, extrae entidades con nombre (fechas, importes, números de pedido) y arma un paquete JSON estricto para invocar la lógica de negocio interna. En el benchmark Berkeley Function-Calling Leaderboard (BFCL), Nemotron 3.5 Bolt superó el 88% de precisión generando argumentos, adelantando a muchos modelos de la categoría 14B–32B.
Si la petición resulta trivial (una consulta informativa o una acción estándar), Bolt la resuelve por su cuenta. Si exige síntesis profunda o planificación compleja de sistemas, Bolt redirige limpiamente la consulta al modelo insignia en la nube.
Límites de capacidad: cuándo a 4B le falta profundidad física
Sería irresponsable callar las limitaciones de las redes compactas. En la física de los semiconductores no hay milagros: cuatro mil millones de parámetros tienen un techo físico estricto de capacidad de memoria (information capacity).
Nemotron 3.5 Bolt no sirve en absoluto para:
- Redactar textos literarios extensos donde haga falta finura estilística, subtexto y metáforas elaboradas.
- Razonamiento matemático multipaso con demostración de teoremas complejos: ahí el modelo empieza pronto a enredar cadenas lógicas y soltar cálculos plausibles pero erróneos.
- Refactorización profunda de arquitecturas formadas por decenas de microservicios interconectados.
Pero nadie le pide eso. Nemotron 3.5 Bolt es un «caballo de batalla» afilado al milímetro para la terminal local, el hogar conectado y los microservicios rápidos sin servidor, demostrando que la IA local inteligente puede ser veloz, diminuta y totalmente gratuita al operar.