¿Cuántas consultas SQL independientes sueles pegar entre sí cuando para un dashboard o para contabilidad te piden exportar la tabla de ventas ya desglosada por regiones, con subtotales por cada producto y una fila de «Total general» abajo del todo? Da la impresión de que una base relacional no sabe entregar distintos niveles de agregación en una misma salida plana.
En realidad, el estándar SQL resuelve esto dentro del propio motor. Revisé el ejemplo con la tabla de ventas del canal SQL Portal y contrasté la mecánica con la documentación de MySQL 8.0: el modificador WITH ROLLUP calcula las filas detalladas, los subtotales por categoría y el total general en un único plan de escaneo, ahorrándote los empalmes con UNION ALL.
Por qué el GROUP BY normal es ciego a la jerarquía y por qué es peligroso pegar consultas con UNION ALL
Veamos paso a paso cómo trabaja la agrupación sobre la tabla Sales con las columnas de producto product, región region e importe sales_amount. Si escribes un GROUP BY product, region convencional, en la etapa de colapsado de grupos (ese pipeline lo desmenuzamos en el artículo sobre el orden de ejecución en SQL y el costo de agrupar) la base reduce las filas estrictamente al nivel de detalle más bajo: cada par «producto + región» produce una única suma SUM(sales_amount).
Si además necesitas en la misma salida los subtotales por producto junto con los ingresos totales, la solución a fuerza bruta obliga a unir tres consultas mediante UNION ALL: la primera calcula GROUP BY product, region, la segunda saca los subtotales con GROUP BY product poniendo NULL en lugar de la región, y la tercera suma toda la tabla sin GROUP BY. El resultado es que el planificador del SGBD escanea la tabla Sales tres veces, y olvidar actualizar un filtro WHERE en una sola de las ramas descuadra el reporte en silencio.
Cómo funciona WITH ROLLUP sobre la tabla Sales y para qué sirve la función GROUPING()
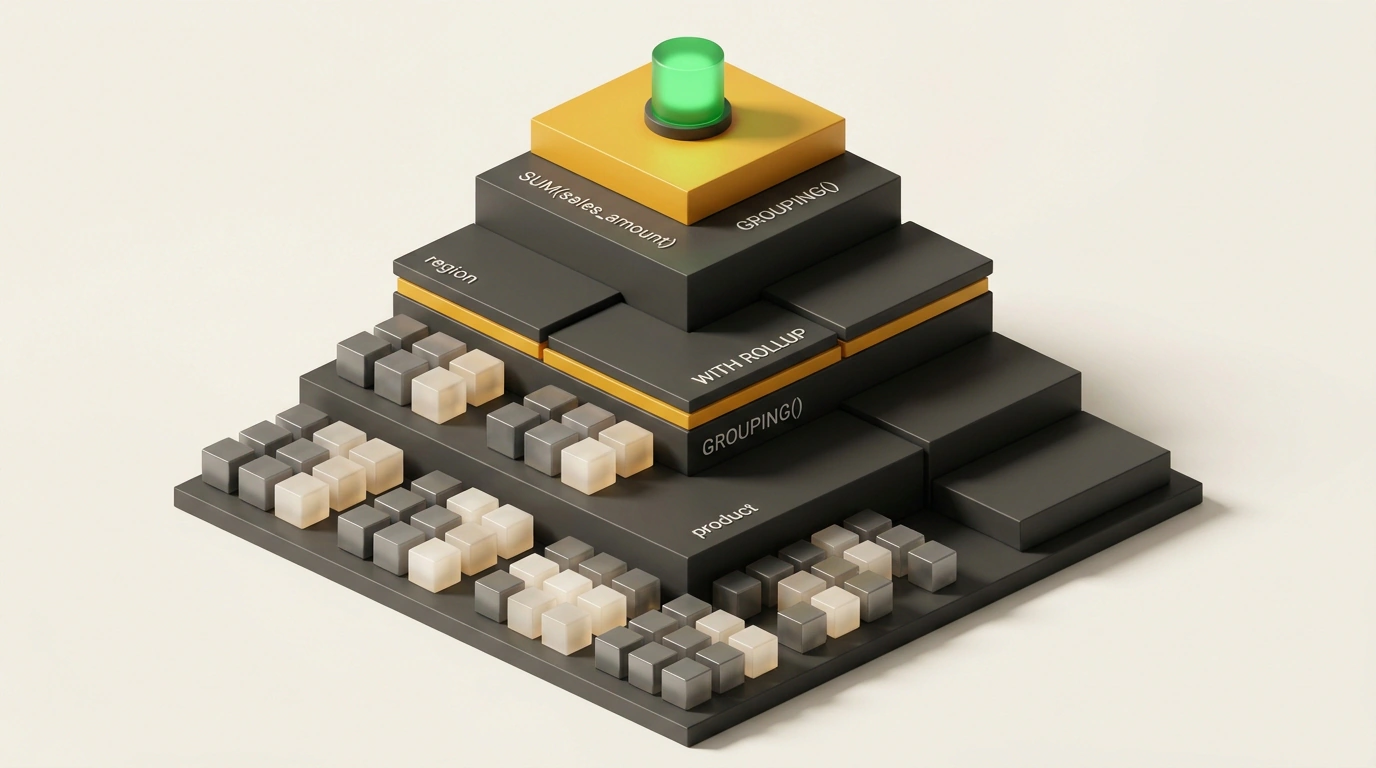
El modificador WITH ROLLUP (una extensión del estándar ANSI SQL:1999) traslada el cálculo jerárquico al interior del motor. Es como hacer inventario en un almacén con una libreta: el encargado recorre los pasillos una sola vez, anota las existencias por estante, al final de cada estantería cierra de inmediato el subtotal del producto y al salir suma los totales de todas las estanterías en el resultado general.
Al ejecutar GROUP BY product, region WITH ROLLUP, la base va replegando la agrupación de derecha a izquierda en una sola pasada, generando N + 1 niveles de agregación (a diferencia de CUBE con su malla de 2^N cruces o de un GROUPING SETS manual). En el resultado aparecen en orden las filas de detalle (product, region), los subtotales por producto (product, NULL) y el total general (NULL, NULL).
Aquí es donde muchos caen en una trampa: como los niveles agrupados se marcan con NULL, dan ganas de envolver la columna en COALESCE(region, 'Todas las regiones'). Pero si en la tabla Sales hay pedidos sin región informada que guardan un NULL real, COALESCE no distinguirá una celda vacía de un subtotal y etiquetará esas ventas como «Todas las regiones». La función GROUPING() sale al rescate: devuelve 1 solo para los NULL sintéticos creados por el operador ROLLUP, y 0 para las filas normales. Armemos la consulta limpia contra Sales:
SELECT
  IF(GROUPING(product) = 1, 'Все товары', product) AS product_name,
  IF(GROUPING(region) = 1, 'Все регионы', region) AS region_name,
  SUM(sales_amount) AS total_sales
FROM Sales
GROUP BY product, region WITH ROLLUP;
En tiempo de ejecución, para las filas detalladas GROUPING() devuelve 0 y conserva los nombres reales de productos y regiones (incluidos los huecos reales). En la fila de subtotal por producto se cumple GROUPING(region) = 1, asignando la etiqueta 'Все товары' / 'Все регионы' (Todas las regiones), y en la última fila del total general ambas funciones devuelven 1, mostrando 'Все товары' (Todos los productos) y 'Все регионы' (Todas las regiones).
Ten en cuenta también los dialectos: en MySQL se escribe el sufijo WITH ROLLUP (en versiones 8.0+ evita cláusulas ORDER BY explícitas que entren en conflicto), mientras que en PostgreSQL se usa la forma GROUP BY ROLLUP(product, region). Una comprobación con EXPLAIN (siguiendo las reglas de la guía para leer planes de ejecución en SQL) confirmará una única lectura de la tabla: así, cambiar UNION ALL por WITH ROLLUP alivia tanto el disco como el procesador de la base.
Y si mañana echas un vistazo a los módulos de analítica de tu proyecto, ¿cuántos empalmes de varios pisos con UNION ALL o bucles de suma en el backend podrías reemplazar con una sola línea de ROLLUP?