Suele darse por sentado que el posicionamiento web es una carrera interminable por el primer puesto en Google, comprando enlaces y encajando palabras clave en cada párrafo. Parece obvio que, si una web acumula decenas de millones de visitas, sus artículos están afinados al milímetro para los algoritmos y un proyecto pequeño sin presupuesto no tiene nada que hacer allí. Pero cuando examiné un análisis reciente de los resultados de búsqueda donde separaron el peso de una marca conocida de las búsquedas genéricas, esa imagen habitual se vino abajo.
El especialista en posicionamiento Julian Goldie pasó tres plataformas gigantes —la herramienta de diseño Canva, el portal inmobiliario Zillow y el espacio de trabajo Notion— por el tándem del agente de terminal Claude Code y el sistema abierto de analítica OpenSEO. Hubo una cifra en ese informe que me atrapó enseguida: casi 9 de cada 10 visitas desde Google por sus consultas principales llegan a estos gigantes simplemente porque la gente teclea «Canva», «Zillow» o «Notion». En Canva, las búsquedas de marca suponen el 88% del tráfico de sus cien palabras clave principales sobre unos 22.7 millones de visitas mensuales en Estados Unidos, y en Zillow rondan el 87% de 63 millones de visitas. No puedes copiar el reconocimiento de marca ajeno. En cambio, en ese 10–12% restante de búsquedas sin marca, donde la gente busca resolver un problema y lee los resúmenes de Google AI Overviews, ChatGPT Search y Perplexity, las reglas son otras —y justo ahí los gigantes mostraron sorprendentes puntos ciegos—.
Cuatro capas de visibilidad: SEO clásico, respuestas directas (AEO), citas en IA (GEO) y legibilidad para máquinas
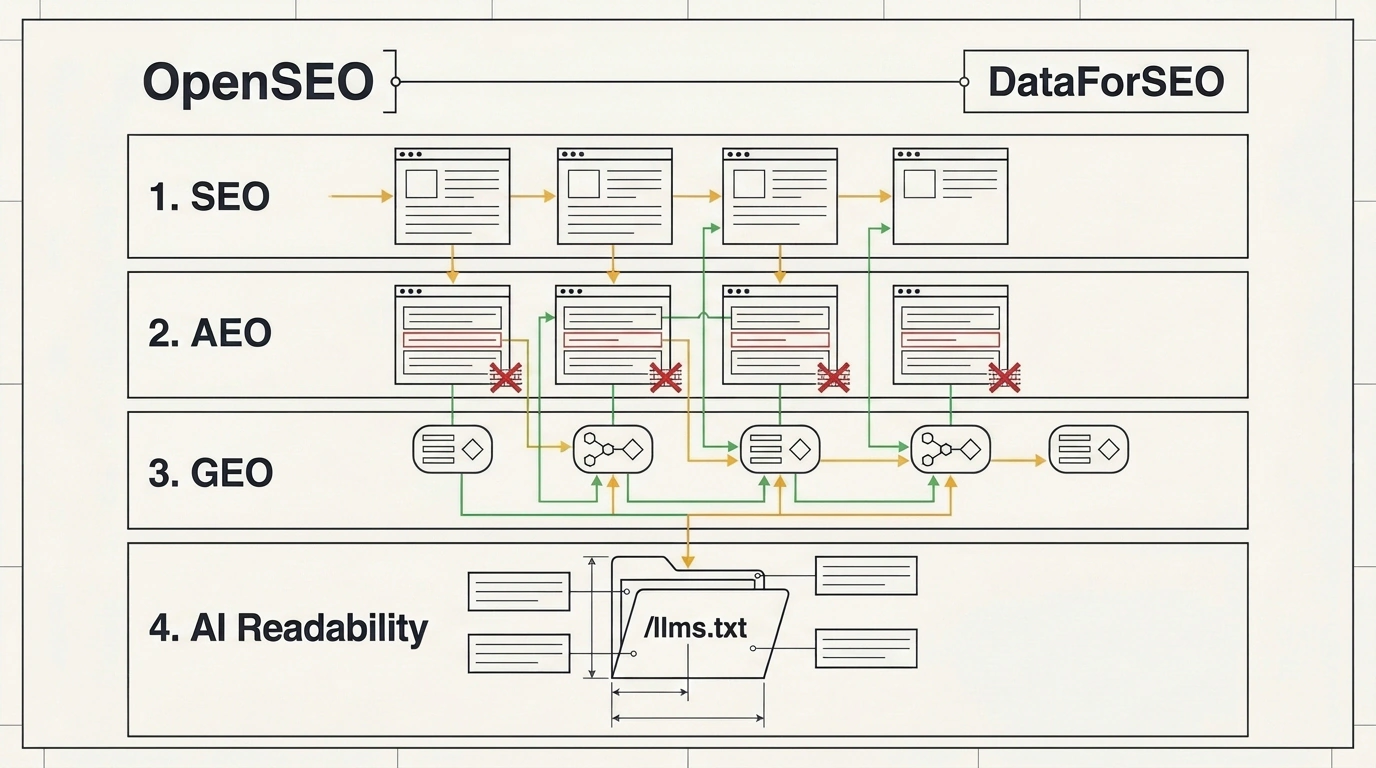
La mayoría de los dueños de sitios web sigue mirando solo la primera capa: el SEO clásico (Search Engine Optimization), donde la página pelea por un hueco entre los enlaces azules. Pero hoy el camino hacia la respuesta se divide en cuatro plantas, y fallar en cualquiera de ellas vuelve invisible tu web para las redes neuronales:
- Búsqueda clásica (SEO): posiciones base por palabras clave y autoridad de enlaces del dominio.
- Bloques de respuesta directa (AEO, Answer Engine Optimization): cajas destacadas en lo alto de los resultados (Google Featured Snippets), donde el buscador extrae un párrafo, una lista o una tabla de la página.
- Citas en respuestas generativas (GEO, Generative Engine Optimization): mención del sitio como fuente dentro de los resúmenes de Google AI Overviews, ChatGPT, Claude y Perplexity.
- Legibilidad para máquinas (AI Readability): acceso libre para los rastreadores de los modelos de lenguaje sin bloqueos en
robots.txt, cortes de cortafuegos ni scripts pesados.
Las herramientas SEO tradicionales no muestran qué líneas concretas de texto se llevó la red neuronal a su respuesta. Ahí entra OpenSEO, una plataforma gratuita bajo licencia MIT que despliegas en Docker. Toma métricas reales desde DataForSEO API (demanda, dificultad de palabras clave de 0 a 100, backlinks y visibilidad en IA), incluye el panel 3D Rank Orbit y un servidor de protocolo MCP.
Por ese conector se enchufa directamente Claude Code a OpenSEO. En lugar de cruzar hojas de cálculo de cinco servicios a mano, el fundador de un SaaS de planificación de tareas escribe una sola frase en la terminal pidiendo escanear a un competidor frente a su producto. En tres minutos el agente descarga estadísticas de tráfico, citas literales de respuestas de IA y permisos de rastreo para bots, enfrentando los mitos con la realidad.
Análisis de los gigantes: por qué Google AI cita palabra por palabra tablas de Canva y fichas de Zillow
Una ilusión muy extendida dice que, como Canva posiciona 716 000 consultas, acumula cientos de respuestas rápidas gracias a sus vistosas páginas de aterrizaje. En realidad, el dominio tiene solo 27 bloques de respuesta rápida (AEO), mientras que en los resúmenes de Google AI aparece citado en 177 922 consultas. La IA ignora los titulares publicitarios: las 27 tarjetas de Canva salen de páginas secas de ayuda. Si alguien pregunta el tamaño de portada en Facebook, el modelo toma la línea que arranca con la cifra (820 × 312 píxeles) y una frase detrás; si busca el código de un color azul verdoso, coge el código HEX; si necesita las medidas de un folleto, extrae la tabla de tres filas. En las respuestas generativas, el algoritmo copia igual los bloques de FAQ y pasos breves como crear un código QR («1. Abre el diseño. 2. Ve a elementos...»). Y cuando la consulta pregunta por el mejor planificador digital para iPad, el gigante cede su sitio a blogs pequeños.
El segundo ejemplo es el portal Zillow, con 574 992 citas en IA. Seguro que piensas que medio millón de menciones viene de su descomunal base de anuncios. Pero mira qué palabras saca el modelo de las páginas de Zillow: de la calculadora hipotecaria coge la línea con la fórmula de la cuota mensual; de los informes de mercado, el resumen con fecha («A fecha de...»); de los perfiles de empresa, la ficha con nombre, licencia, dirección y teléfono; de las páginas de alquiler, la lista de filtros. La estructura vence a los párrafos largos, y las páginas locales con cifras por ciudad superan a los portales genéricos.
Pero la mayor sorpresa saltó en la cuarta capa, al comprobar la legibilidad para máquinas:
- El filtro de Canva: su archivo
robots.txtbloquea a los bots de ChatGPT y Claude en la mayoría de las páginas, dejándolos pasar solo a herramientas, ayuda y formación (al bot de Perplexity le abre todo). El gigante filtra así su contenido, pero para una web pequeña cerrar la puerta a los bots supone perder alcance. - El cortafuegos de Zillow: en el
robots.txtde Zillow pone que los bots de IA son bienvenidos en todas partes, pero cuando el agente intentó descargar una página, el cortafuegos bloqueó la petición. En la puerta cuelga el cartel de «Abierto», pero el guardia no deja pasar a nadie. - Las plantillas vacías de Notion: Notion tiene la mejor base técnica —acceso abierto para ChatGPT, Claude y Perplexity, copias en texto plano y mapa
llms.txt—. Aun así, en Google AI suma menos de 9000 menciones (casi todas de marca). La razón es simple: el 94% del tráfico sin marca de Notion viene de su catálogo de plantillas, pero dentro de las fichas más populares el apartado «Sobre esta plantilla» estaba vacío: ni definición, ni pasos, ni FAQ.
El estándar llms.txt en la práctica: cómo entregar a los modelos contexto limpio sin HTML ni scripts
¿Para qué hace falta un mapa específico para bots? Un navegador digiere sin problemas scripts y maquetación, pero el rastreador de un modelo de lenguaje necesita extraer rápido la esencia de la página y meterla en su ventana de contexto (la memoria de trabajo de la red neuronal). Si el bot se ahoga entre menús y scripts, se marcha a otra fuente más clara. Sobre cómo cambia la selección de fuentes en los sistemas generativos puedes leer en el análisis GEO y AEO en lugar del SEO clásico: cómo lograr que una marca entre en las respuestas de las IA.
Para ofrecer a los robots contenido limpio sin ruido HTML, en septiembre de 2024 Jeremy Howard (Answer.AI) propuso el estándar llms.txt. Se trata de un archivo /llms.txt en la raíz del dominio, redactado como un mapa curado del sitio en formato Markdown, y su pareja /llms-full.txt, que reúne toda la documentación en un único archivo de texto descargable en una sola petición HTTP.
En nuestro ejemplo continuo, el fundador del SaaS de planificación descubre mediante la auditoría en Claude Code y OpenSEO que, al buscar software para freelancers, Notion no entra en las recomendaciones de la IA (solo asoma en un hilo de Reddit), y en consultas de referencia el buscador cita tablas de atajos de teclado de terceros. El equipo revisa el acceso de los bots y añade en la raíz del sitio el archivo /llms.txt:
# PlanFlow
> Servicio de planificación de tareas y onboarding de clientes.

## Documentación principal
- [Inicio rápido](https://example.com/docs/start): Instalación y configuración.
- [Tarifas](https://example.com/pricing): Planes de servicio y límites.
- [Plantillas](https://example.com/docs/templates): Atajos de teclado y esquemas.

## Optional
- [Archivo del blog](https://example.com/blog): Noticias de la empresa.
Fíjate en cómo lee esta estructura el rastreador. El encabezado # fija el nombre del proyecto, y la cita > justo debajo resume el producto en una frase. Las secciones ## agrupan enlaces a las páginas de referencia principales con una explicación tras los dos puntos. Los apartados secundarios van en el bloque ## Optional: si el límite de ventana de contexto aprieta, el agente se salta esa cola y reserva tokens para leer la documentación esencial. Lo fundamental es mantener al día los enlaces de /llms.txt para que los modelos no reciban contexto caducado.
Tres formatos de página que las redes neuronales priorizan al citar: definiciones, comparativas y guías paso a paso
Con el paso abierto para los bots, queda empaquetar el texto de la página. El cotejo de las citas de los tres gigantes demostró que las redes neuronales copian con prioridad tres formatos:
- Definiciones de entidades (Entity Definitions). Un primer párrafo compacto (hasta 250 caracteres) que responda directo a «¿Qué es?», con una cifra o fórmula en la primera línea y una lista de características debajo.
- Tablas comparativas (Comparison Matrices). Matrices de alternativas («X frente a Y») con parámetros claros, fecha de vigencia («A fecha de...») y al menos un dato propio sacado de la experiencia de la empresa.
- Guías paso a paso (How-To Workflows) y FAQ. Instrucciones numeradas de 4–5 pasos donde cada punto arranca con un verbo de acción sin relleno previo, más un bloque de preguntas con marcado estructurado
FAQ(Schema.org).
En nuestro ejemplo, el fundador de la startup SaaS localiza con OpenSEO la consulta «client onboarding software» (480 búsquedas al mes en EE. UU. con dificultad 14 sobre 100) y la palabra clave «best client onboarding software» con dificultad 4. En lugar de pelear por términos saturados, el equipo crea páginas para plantillas y cubre el hueco de Notion: pone la definición en la primera línea, añade 4–5 pasos de configuración, una tabla de atajos y una matriz comparativa con sus propios datos, y abajo coloca el bloque FAQ. Al repetir la consulta en Perplexity, el servicio aparece en el primer bloque de fuentes con enlace directo.
Por supuesto, /llms.txt y un par de tablas no van a resolver todo el tráfico de la noche a la mañana. La búsqueda generativa tiene su cara B: el riesgo del «clic cero» (zero-click search), cuando el usuario lee tus cifras directo en la ventana de la IA sin entrar en la web, mientras los proveedores mantienen en secreto sus fórmulas de posicionamiento. No existe una receta mágica, pero ahora conoces las reglas de las cuatro capas de búsqueda y ves dónde hasta los gigantes dejan la puerta entreabierta.