En una base de datos relacional clásica, escribir desde distintos continentes sigue chocando con un servidor central único; si no, los datos divergen. Pero en Amazon Aurora DSQL, recién llegada a disponibilidad general (Generally Available, GA), no hay nodo maestro dedicado: se puede escribir y leer con consistencia garantizada desde varias regiones a la vez en modo active-active, y las consultas SELECT ni siquiera esperan acuerdos entre regiones.
¿Cómo montar una base relacional global con protocolo PostgreSQL sin sharding manual ni retrasos de replicación? Los ingenieros de AWS, como recordó el canal SQL Portal, reconstruyeron el motor en Rust sobre un modelo serverless y separaron el cómputo, la resolución de conflictos y el almacenamiento.
Por qué las réplicas y los shards rompen el SQL habitual
Fíjate en dónde se atasca el crecimiento de una base tradicional con el ejemplo de un servicio global de reserva de billetes. Cuando sube el tráfico, la primera idea es levantar réplicas de lectura cerca de los usuarios en Europa y EE. UU. Sobre el papel todo acelera sin tocar el código, pero la replicación asíncrona introduce latencia: un pasajero en Fráncfort compra el último asiento, recarga la página y en la réplica lo sigue viendo libre.
La segunda esperanza es escalar las escrituras con sharding manual por regiones. Pero la ilusión de dividir fácilmente se desmorona en el código: la aplicación tiene que enrutar cada consulta al shard correcto, las transacciones distribuidas exigen un pesado commit en dos fases (2PC) y los JOIN entre shards dejan de funcionar. Al final, el equipo se pasa el tiempo parcheando la fontanería alrededor de la base.
Cuatro capas en lugar de un monolito: cómo viaja una transacción
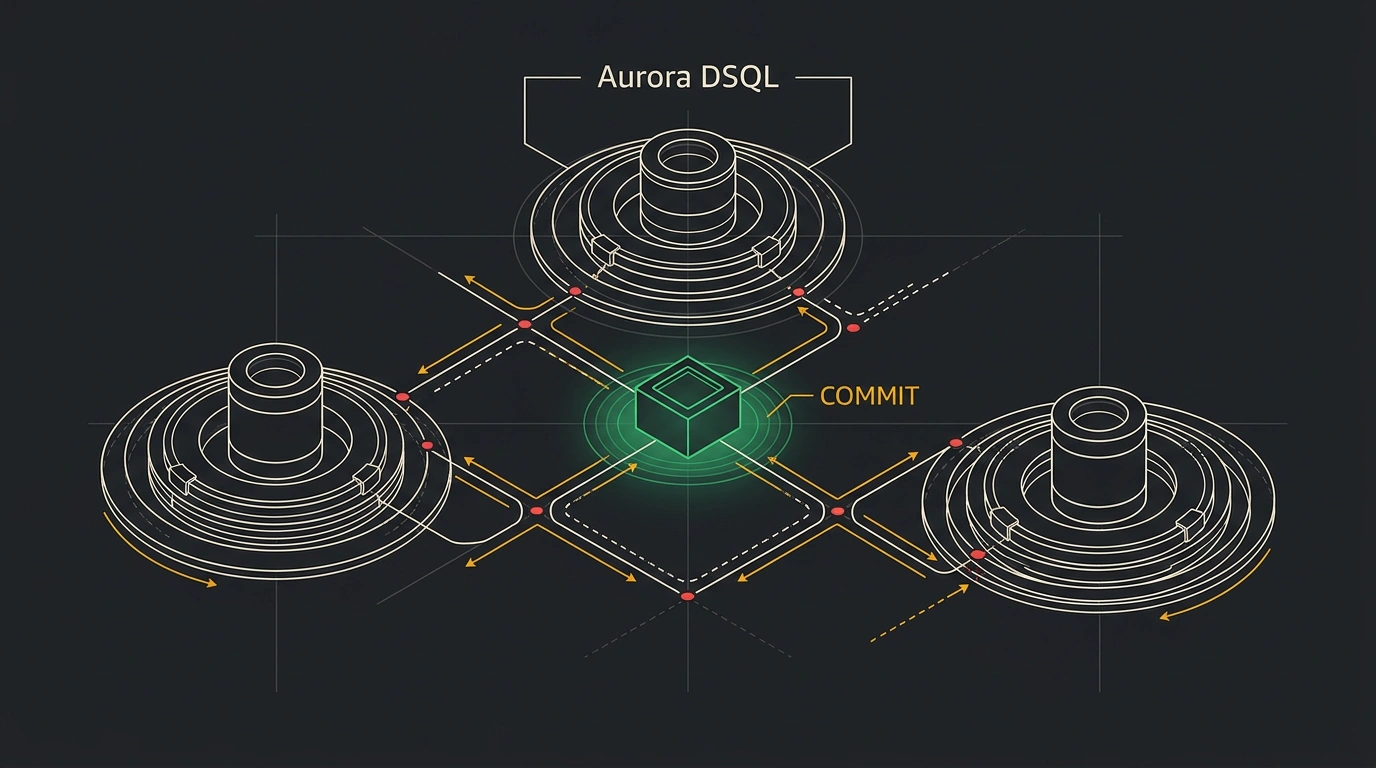
En Aurora DSQL sustituyeron el monolito por cuatro capas escalables en horizontal. Sigamos cómo pasa por ellas esa misma compra de billete:
- Procesador de consultas (
Query Processor): un componente stateless sobre microVMs ligeras tras un endpoint regional en cada zona de disponibilidad, que habla el protocolo estándar de PostgreSQL. En unSELECT, lee de una instantánea local sin mirar a otros continentes. Al escribir (UPDATE), los cambios no bloquean filas por red, sino que se acumulan en la memoria de la transacción hasta el commit bajo control de concurrencia optimista (Optimistic Concurrency Control, OCC). - Árbitro de transacciones (
Adjudicator): entra en juego en elCOMMIT. Este servicio descentralizado, particionado por rangos de claves, contrasta marcas temporales y comprueba si otra región modificó la misma fila, garantizando aislamiento de instantáneas (Snapshot Isolation) y seriabilidad estricta. - Registro distribuido (
Storage Journal): consolida la transacción aprobada por el árbitro mediante quórums de nodos de almacenamiento en varias zonas de disponibilidad para asegurar atomicidad y durabilidad. - Capa de almacenamiento (
Storage Layer): aplica de forma asíncrona los cambios desde el registro y atiende las lecturas. En cuanto se confirma la compra en Fráncfort, el servicio en EE. UU. ve al instante el estado de asiento ocupado sin sharding manual.
A mí aquí me interesa más el caso límite: ¿qué pasa si un comprador en Fráncfort y otro en Nueva York pulsan pagar por el mismo asiento en el mismo milisegundo? Uno de los commits pasa y el otro recibe el error estándar de seriabilidad de PostgreSQL 40001, que exige reintentar la transacción en el código.
De ese detalle sale una regla clara: la consistencia estricta en una base distribuida no sale gratis, solo cambia el punto donde se paga. En lugar de bloqueos globales, Aurora DSQL traslada el coste únicamente a los conflictos reales. Con carga repartida escala sin fricción, pero si varias regiones compiten a menudo por una misma fila «caliente», subirán la latencia del árbitro y el número de reintentos.
Para contrastar, puedes ver nuestros análisis de la arquitectura del plano de control de Cloudflare D1 en el edge y del funcionamiento de Apache Cassandra, donde el modo active-active se paga renunciando al SQL clásico.
Merece la pena mirar Aurora DSQL en estado GA cuando un servicio transaccional se queda pequeño en una sola región y mantener un sharding casero sobre PostgreSQL consume demasiada energía, siempre que tu código esté preparado para reintentar transacciones en conflicto. Ahora bien, ¿tu base actual necesita de verdad escrituras desde varios continentes o por ahora te basta con unos buenos índices y un servidor sólido?