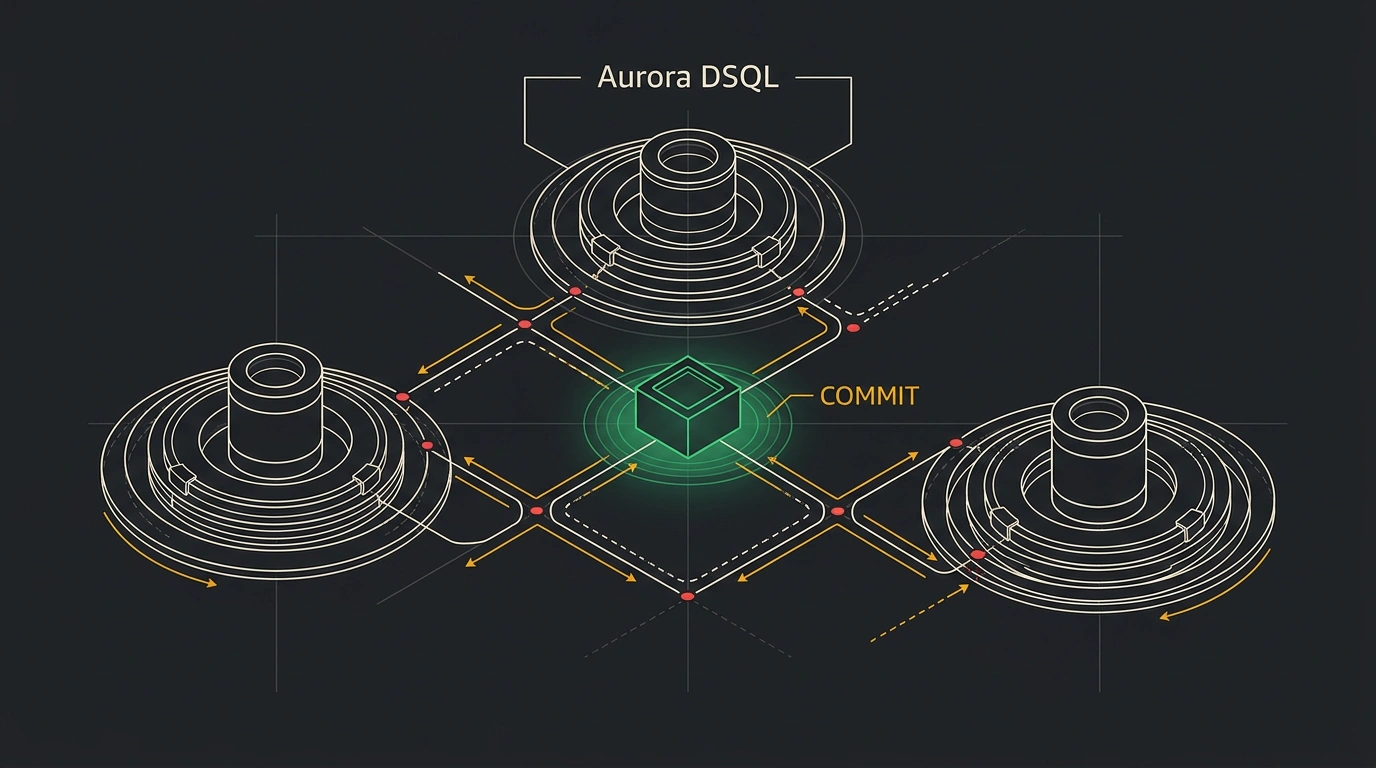
В классической реляционной базе запись с разных континентов всё равно упирается в один центральный сервер — иначе данные разойдутся. Но в Amazon Aurora DSQL, недавно вышедшей в статус общедоступной (Generally Available, GA), выделенного мастера нет: писать и читать с гарантированной согласованностью можно сразу из нескольких регионов в режиме active-active, а запросы SELECT вообще не ждут межрегиональных согласований.
Как построить глобальную реляционную базу с протоколом PostgreSQL без ручного шардирования и задержек репликации? Разработчики AWS, о чём напомнил канал SQL Portal, пересобрали движок на языке Rust вокруг бессерверной модели и разделили вычисления, проверку конфликтов и хранение.
Почему реплики и шарды ломают привычный SQL
Посмотри, во что упирается рост обычной базы на примере глобального сервиса бронирования билетов. Когда трафик растёт, первая идея — поднять реплики чтения поближе к пользователям в Европе и США. На бумаге всё ускоряется без правки кода, но асинхронная репликация приносит задержку: пассажир во Франкфурте выкупает последнее место, обновляет страницу — и на реплике видит его ещё свободным.
Вторая надежда — масштабировать запись ручным шардированием по регионам. Но иллюзия простого деления рушится в коде: приложению приходится маршрутизировать каждый запрос к нужному шарду, распределённые транзакции требуют тяжёлого двухфазного коммита (2PC), а JOIN между шардами перестают работать. В итоге команда бесконечно чинит обвязку вокруг базы.
Четыре слоя вместо монолита: как проходит транзакция
В Aurora DSQL монолит заменили на четыре горизонтально масштабируемых слоя. Проследим, как через них проходит та же покупка билета:
- Процессор запросов (
Query Processor) — stateless-компонент на лёгких микровиртуалках за региональным эндпоинтом в каждой зоне доступности, принимающий стандартный протокол PostgreSQL. ПриSELECTон читает из локального снимка без оглядки на другие континенты. При записи (UPDATE) изменения не блокируют строки по сети, а копятся в памяти транзакции до коммита по модели оптимистичного контроля параллелизма (Optimistic Concurrency Control, OCC). - Арбитр транзакций (
Adjudicator) включается приCOMMIT. Этот децентрализованный сервис, шардированный по диапазонам ключей, сверяет временные метки и проверяет, не изменили ли ту же строку в другом регионе, обеспечивая изоляцию моментальных снимков (Snapshot Isolation) и строгую сериализуемость. - Распределённый журнал (
Storage Journal) фиксирует одобренную арбитром транзакцию через кворумы узлов хранения в нескольких зонах доступности для атомарности и долговечности. - Слой хранения (
Storage Layer) асинхронно применяет изменения из журнала и обслуживает чтения. Как только покупка во Франкфурте зафиксирована, сервис в США сразу видит статус «место занято» без ручного шардирования.
Но мне здесь интереснее пограничный случай: что если покупатели во Франкфурте и Нью-Йорке нажмут оплату одного места в одну миллисекунду? Один коммит пройдёт, а второй вернёт стандартную ошибку сериализации PostgreSQL 40001, требующую повтора транзакции в коде.
Из этой детали следует важное правило: строгая согласованность в распределённой базе не бесплатна — она просто меняет точку оплаты. Вместо глобальных блокировок Aurora DSQL переносит цену только на реальные конфликты. При равномерной нагрузке всё масштабируется бесшовно, но если регионы часто бьются за одну «горячую» строку, задержка арбитража и число повторов вырастут.
Для контраста загляни в разборы архитектуры плоскости управления Cloudflare D1 на периферии и устройства Apache Cassandra, где за active-active платят отказом от классического SQL.
Присмотреться к Aurora DSQL в статусе GA стоит, когда транзакционный сервис вырос из одного региона, а поддержка самописного шардинга поверх PostgreSQL отнимает слишком много сил — если твой код готов повторять конфликтующие транзакции. А текущей базе в твоём проекте правда нужна запись с разных континентов, или пока хватит толковых индексов и одного крепкого сервера?