Принято считать, что поисковая оптимизация — это бесконечная гонка за первой строчкой в Google, закупка ссылок и вписывание ключевых слов в абзацы. Кажется очевидным: если сайт собирает десятки миллионов визитов, значит, его статьи идеально подогнаны под алгоритмы, и малому проекту без огромного бюджета там ловить нечего. Но когда я изучил свежий разбор выдачи, где отделили силу известного имени от переходов по общим запросам, привычная картина рассыпалась.
Специалист по продвижению Джулиан Голди прогнал три крупнейшие платформы — сервис дизайна Canva, портал недвижимости Zillow и рабочее пространство Notion — через связку терминального агента Claude Code и открытой поисковой системы OpenSEO. Меня в этом отчете сразу зацепила одна цифра: почти 9 из 10 переходов из Google по главным запросам эти гиганты получают просто потому, что люди вбивают в поиск само слово «Canva», «Zillow» или «Notion». У Canva на брендовые запросы приходится 88% трафика из первой сотни ключей при посещаемости около 22,7 млн визитов в месяц в США, а у Zillow — около 87% из 63 млн визитов. Скопировать чужую узнаваемость ты не сможешь. Зато в оставшихся 10–12% небрендового поиска, где люди ищут решение задачи и читают сводки в Google AI Overviews, ChatGPT Search и Perplexity, правила игры другие — и там у гигантов обнаружились удивительные слепые зоны.
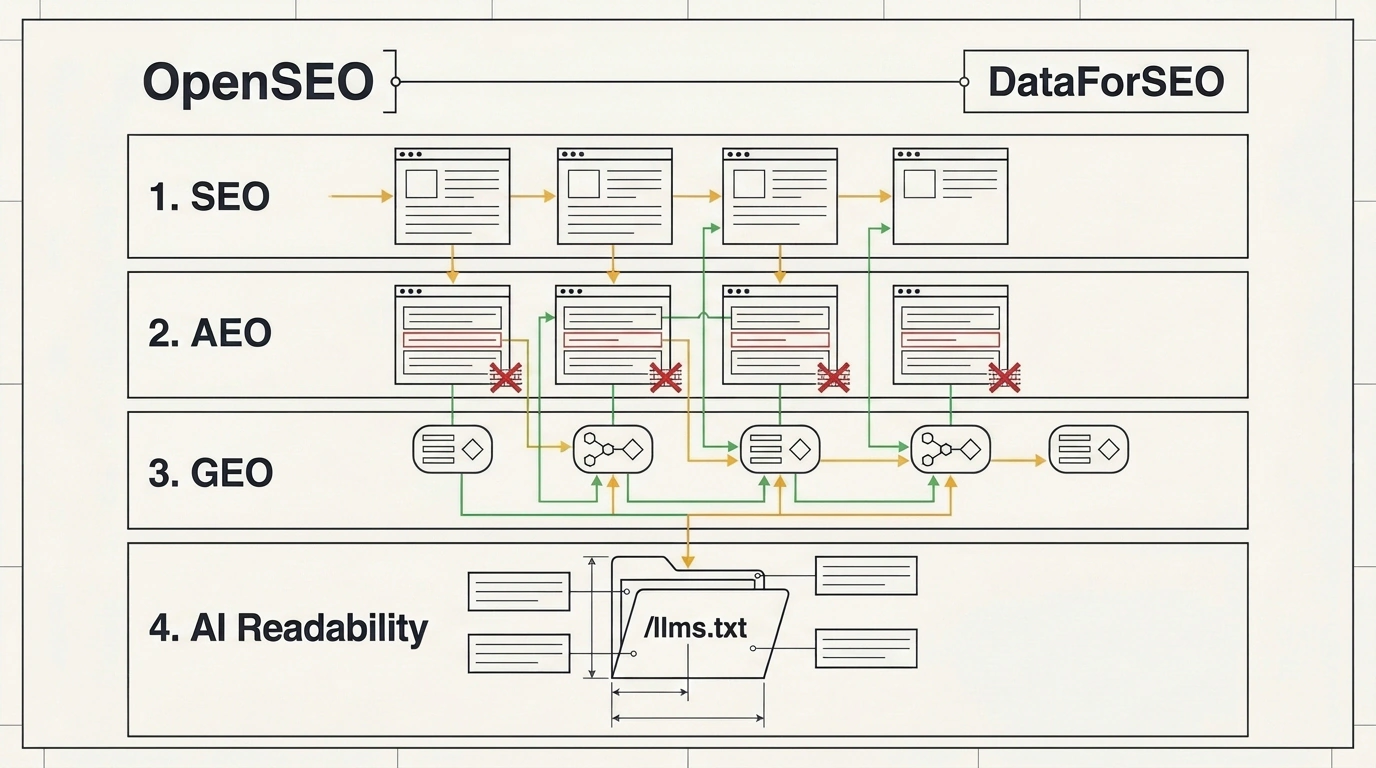
Четыре слоя видимости: классический SEO, блоки прямых ответов (AEO), цитирование в ИИ (GEO) и машинная читаемость
Большинство владельцев сайтов по старинке следят только за первым слоем — классическим SEO (Search Engine Optimization), где страница борется за место среди синих ссылок. Но сегодня путь к ответу распадается на четыре этажа, и провал на любом из них делает сайт невидимым для нейросетей:
- Классический поиск (SEO) — базовые позиции по ключевым словам и ссылочный вес домена.
- Блоки прямых ответов (AEO, Answer Engine Optimization) — спецблоки вверху выдачи (Google Featured Snippets), куда поисковик выдергивает один абзац, список или таблицу со страницы.
- Цитирование в генеративных ответах (GEO, Generative Engine Optimization) — упоминание сайта как источника внутри сводок Google AI Overviews, ChatGPT, Claude и Perplexity.
- Машинная читаемость (AI Readability) — доступность страниц для краулеров языковых моделей без запретов в
robots.txt, блокировок файервола и тяжелых скриптов.
Старые SEO-сервисы не показывают, какие именно строчки текста нейросеть забрала в ответ. Здесь выручает OpenSEO — бесплатная платформа под лицензией MIT, которую ты запускаешь в Docker. Она берет живые метрики из DataForSEO API (спрос, сложность ключей от 0 до 100, обратные ссылки и видимость в ИИ), включает 3D-панель Rank Orbit и сервер протокола MCP.
Через этот разъем к OpenSEO напрямую подключается Claude Code. Вместо ручной сводки таблиц из пяти сервисов основатель SaaS-сервиса планирования задач пишет одну фразу в терминале с просьбой просканировать конкурента под свой продукт. За три минуты агент выгружает статистику трафика, дословные цитаты из ответов ИИ и настройки доступа для ботов, сталкивая мифы с реальностью.
Разбор гигантов: почему Google AI цитирует конкретные таблицы Canva и карточки недвижимости Zillow слово в слово
Популярная иллюзия гласит: раз у Canva 716 000 ранжируемых запросов, то сервис держит сотни быстрых ответов за счет ярких лендингов. На деле у домена всего 27 блоков быстрых ответов (AEO), а в сводках Google AI он цитируется в 177 922 запросах. ИИ игнорирует рекламные заголовки: все 27 карточек Canva растут из сухих справочных страниц. Спрашивают размер обложки Facebook — модель берет строку, где первой стоит цифра (820 × 312 пикселей) и одно предложение следом; ищут код цвета морской волны — забирает HEX-код; нужны габариты флаера — берет таблицу из трех строк. В генеративных ответах алгоритм точно так же копирует блоки FAQ и короткие шаги вроде создания QR-кода («1. Откройте дизайн. 2. Перейдите к элементам...»). А в ответах ИИ на вопросы про лучший цифровой планер для iPad гигант уступает место маленьким блогам.
Второй пример — портал Zillow, получивший 574 992 цитирования в ИИ. Ты наверняка подумаешь: полмиллиона упоминаний — это же гигантская база объявлений! Но посмотри, какие слова модель вытаскивает со страниц Zillow. Из ипотечного калькулятора она берет строчку с формулой расчета ежемесячного платежа; из обзоров рынка — сводку с датой («По состоянию на...»); из профилей компаний — запись с названием, лицензией, адресом и телефоном; со страниц аренды — список фильтров. Структура побеждает длинные абзацы, а локальные страницы с цифрами по городу обыгрывают общие порталы.
Но главный сюрприз вскрылся на четвертом слое — при проверке машинной читаемости:
- Фильтр Canva: файл
robots.txtблокирует ботов ChatGPT и Claude на большинстве страниц, пуская их только в разделы инструментов, справки и обучения (боту Perplexity открыто всё). Гигант так фильтрует контент, но для малого сайта закрывать двери ботам — потеря охвата. - Файервол Zillow: в
robots.txtу Zillow написано, что ИИ-ботам рады везде, но при попытке агента загрузить страницу сетевой экран заблокировал запрос. На двери висит табличка «Открыто», а охранник никого не пускает. - Пустые шаблоны Notion: у Notion лучшая техническая база — открытый доступ для ChatGPT, Claude и Perplexity, текстовые копии страниц и карта
llms.txt. Но в ответах Google AI у него менее 9000 упоминаний (в основном брендовых). Причина проста: 94% небрендового трафика Notion приносит каталог шаблонов, а внутри топовых карточек раздел «Об этом шаблоне» оказался пуст: ни определения, ни шагов, ни FAQ.
Стандарт llms.txt на практике: как предоставить языковым моделям чистый контекст сайта без разметки и скриптов
Зачем нужна отдельная карта для ботов? Браузер легко переваривает скрипты и верстку, но краулеру языковой модели нужно быстро вытащить суть страницы и уложить ее в контекстное окно (оперативную память нейросети). Если бот тонет в меню и скриптах, он уходит к более понятному источнику. О том, как меняется отбор площадок в генеративных системах, читай в разборе GEO и AEO вместо классического SEO: как бренду пробиться в ответы нейросетей.
Чтобы дать роботам чистый контент без HTML-шума, в сентябре 2024 года Джереми Ховард (Answer.AI) предложил стандарт llms.txt. Это файл /llms.txt в корне домена, оформленный как курируемая карта сайта в формате Markdown, и парный к нему /llms-full.txt, собирающий всю документацию в единый текстовый файл для загрузки за один HTTP-запрос.
В нашем сквозном примере основатель SaaS-сервиса планирования видит через аудит в Claude Code и OpenSEO, что по запросу о софте для фрилансеров Notion не попадает в рекомендации ИИ (всплывая лишь в ветке на Reddit), а по справочным запросам поисковик цитирует чужие таблицы горячих клавиш. Команда проверяет доступ для ботов и добавляет в корень сайта файл /llms.txt:
# PlanFlow
> Сервис планирования задач и онбординга клиентов.

## Основная документация
- [Быстрый старт](https://example.com/docs/start): Установка и настройка.
- [Тарифы](https://example.com/pricing): Пакеты услуг и лимиты.
- [Шаблоны](https://example.com/docs/templates): Горячие клавиши и схемы.

## Optional
- [Архив блога](https://example.com/blog): Новости компании.
Посмотри, как работает эта разметка при обращении краулера. Заголовок # задает имя проекта, а цитата > сразу под ним в одной фразе объясняет суть продукта. Разделы ## группируют ссылки на главные справочные страницы с пояснениями после двоеточия. Второстепенные разделы вынесены в блок ## Optional: при жестком лимите контекстного окна агент пропустит этот хвост и сохранит токены для чтения основной документации. Главное — вовремя обновлять ссылки в /llms.txt, чтобы модели не получали устаревший контекст.
Три формата страниц, которые нейросети забирают в приоритетном порядке: определения, сопоставления и алгоритмы действий
Когда проход для ботов открыт, остается упаковать сам текст страницы. Сопоставление цитат трех гигантов показало, что нейросети в приоритетном порядке копируют три формата:
- Определения сущностей (Entity Definitions). Емкий первый абзац (до 250 символов) с прямым ответом «Что это такое?», цифрой или формулой в первой строке и маркированным списком характеристик следом.
- Сопоставительные таблицы (Comparison Matrices). Матрицы сравнения альтернатив («X против Y») с четкими параметрами, датой актуальности («По состоянию на...») и хотя бы одним уникальным фактом из практики компании.
- Пошаговые алгоритмы (How-To Workflows) и FAQ. Нумерованные инструкции из 4–5 шагов, где каждый пункт начинается с глагола действия без вводной «воды», плюс блок вопросов с микроразметкой
FAQ(Schema.org).
В нашем примере основатель SaaS-стартапа находит через OpenSEO запрос «client onboarding software» (480 поисков в месяц в США при сложности 14 из 100) и ключ «best client onboarding software» со сложностью 4. Вместо борьбы за перегретые ключи команда создает страницы под шаблоны и закрывает пробел Notion: ставит определение в первой строке, добавляет 4–5 шагов настройки, таблицу горячих клавиш и матрицу сравнения со своей статистикой, а внизу — блок FAQ. При повторном запросе в Perplexity сервис попадает прямо в первый блок источников с прямой ссылкой.
Конечно, /llms.txt и пара таблиц не решат все задачи с трафиком мгновенно. У генеративной выдачи есть обратная сторона — риск «нулевого клика» (zero-click search), когда пользователь читает твои цифры прямо в окне ИИ без перехода на сайт, а провайдеры держат формулы ранжирования в секрете. Универсального рецепта здесь нет — но теперь ты знаешь правила игры на всех четырех слоях поиска и видишь, где даже гиганты оставляют двери открытыми.