Cuando necesitas desplegar la base de datos en memoria Valkey en Kubernetes, los ingenieros suelen elegir entre dos extremos. El primer camino es alquilar una base de datos gestionada en la nube: obtienes alta disponibilidad de fábrica, pero pagas de más por la memoria y pierdes acceso a los ajustes finos. El segundo camino es levantar la base dentro de tu propio clúster mediante un StatefulSet, rodearte de scripts para conmutar réplicas y sobresaltarte con alertas nocturnas cuando se reinicia el maestro.
Me llamó la atención el proyecto abierto wellcake bajo licencia Apache-2.0, del que hablaron en el canal DevOps&SRE Library. Sus autores eliminaron el dilema entre el alquiler caro en la nube y los manifiestos frágiles: el controlador valkey-operator, escrito en Go, traslada las reglas de operación de Valkey —control de quórum, cambio de líder, resharding y copias de seguridad— directamente al ciclo de reconciliación de Kubernetes. Veamos por qué las primitivas básicas del orquestador se quedan cortas ante las bases de datos residentes en memoria y cómo funciona esta automatización.
Por qué un StatefulSet básico es ciego ante los fallos de Valkey y cómo funciona el operador
Tras el cambio de licencia de Redis, la industria respaldó el fork abierto Valkey bajo el paraguas de la Linux Foundation (en paralelo evolucionan otras soluciones compatibles con el protocolo RESP; hace poco analizamos KiviDB como alternativa multihilo a Redis y Valkey en Rust). Pero junto con la base de datos, también se trasladaron a Kubernetes los viejos dolores de cabeza.
Te preguntarás: ¿qué tiene de malo un StatefulSet normal, si asigna nombres y discos persistentes a los pods? Para el controlador básico de Kubernetes, un contenedor con una base de datos no se distingue de un servidor web. Es como el conserje de un edificio que vigila la luz de las oficinas, pero no sabe quién tiene en sus manos el libro mayor de contabilidad. Si el nodo de escritura cae, el orquestador levantará un contenedor limpio con el mismo nombre de red, y las réplicas, sin orden de reelección, seguirán esperando al antiguo líder o se sincronizarán con un nodo vacío, borrando los datos.
Para que el clúster entienda la lógica de la base de datos, se utiliza el patrón de operador: un controlador con recursos personalizados (CRD). En wellcake hay dos: ValkeyCluster define la topología y los discos, mientras que ValkeyACL configura los permisos de usuario mediante el comando idempotente ACL SETUSER ... reset.
El controlador bloquea de inmediato los errores típicos: prohíbe carpetas temporales emptyDir y exige volúmenes PersistentVolumeClaim, para que ante falta de espacio el kubelet no desaloje el pod de la base de datos. El límite maxmemory se fija automáticamente al 60% del límite de memoria del contenedor (resources.limits.memory). Y en lugar de ajustar decenas de parámetros a mano, hay dos perfiles disponibles:
Cache— caché rápida con desalojoallkeys-lru, sin escritura en disco y con un volumen de1Gi;Durable— almacenamiento con políticanoeviction, instantáneasRDB, registroAOFy un volumen de10Gi.
Cuatro topologías en un solo recurso: del nodo único al clúster con sharding
El principal acierto de wellcake es unificar cuatro esquemas de despliegue de Valkey en el recurso ValkeyCluster. El operador se instala desde el registro oci://ghcr.io/melancholictheory/charts/valkey-operator en el espacio de nombres valkey-system.
Veamos cómo funciona con un escenario completo: levantemos una caché tolerante a fallos en el espacio de nombres apps mediante el chart valkey-cluster con los parámetros topology=Replication, profile=Cache y replicas=3. Según la topología, el controlador activa su propia mecánica de protección:
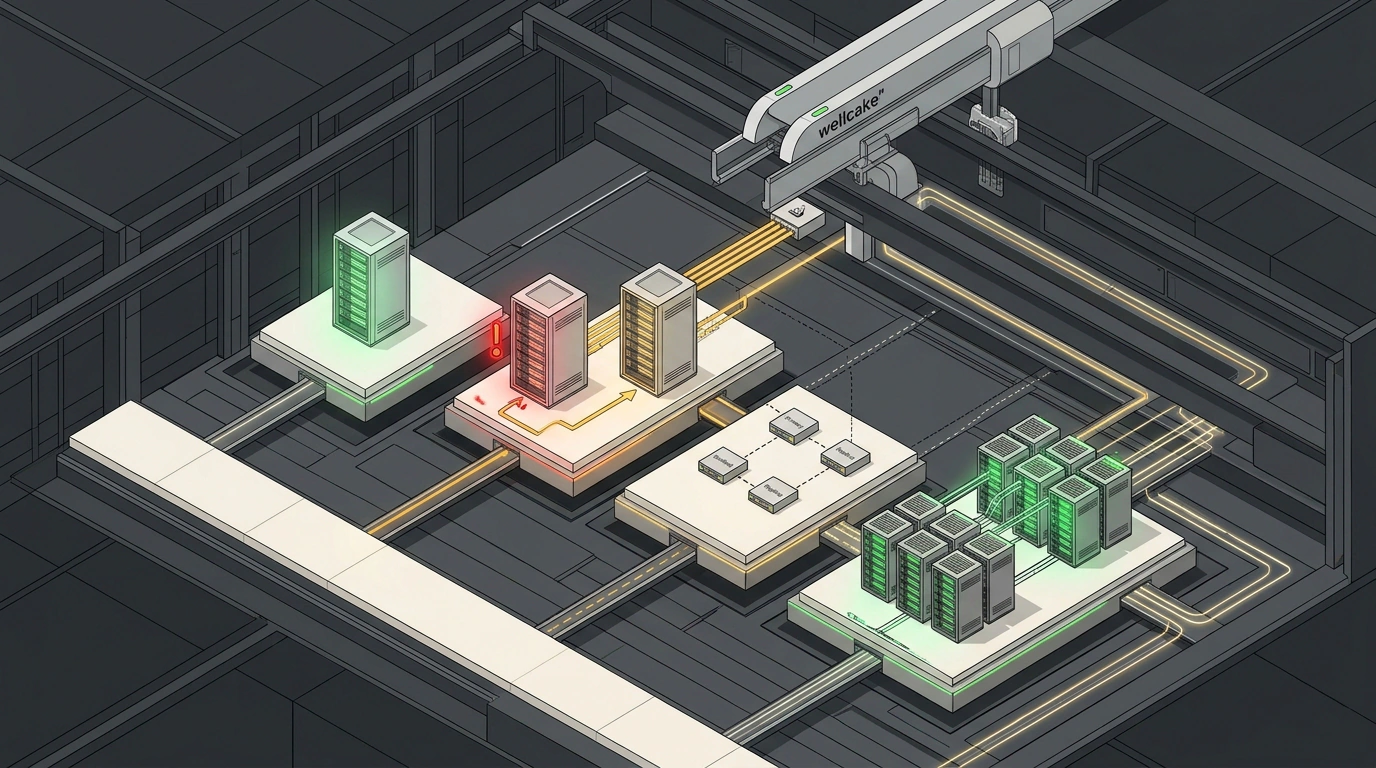
Standalone. Un único pod sin replicación para entornos de pruebas y cachés temporales.Replication. El esquema de nuestro ejemplo: un nodo primario (primary) y dos réplicas conectadas medianteREPLICAOF. Cada quince segundos el operador realiza un sondeo TCP a los nodos. Si el maestro deja de responder, el controlador compara los desplazamientos (offset), promueve a líder a la réplica con los datos más recientes y protege la base contra la división (split-brain) cuando vuelvepod-0. Al mismo tiempo, el operador reasigna la etiquetavalkey.wellcake.io/role: el servicio<cluster>-primarydirige las escrituras estrictamente al líder, y<cluster>-replicasreparte las lecturas entre las réplicas.Sentinel. Para aplicaciones cuyos clientes consultan directamente a Sentinel, el operador despliega unStatefulSetindependiente y un servicio en el puerto26379(26380con TLS), donde el cambio de líder lo decide un quórum de árbitros.Cluster. Las claves se dividen en hash-slots entre maestros conectados mediante el protocologossip. El operador ensambla el clúster convalkey-cli --cluster createy rebalancea los slots por sí solo al escalar (autoReshard). En Valkey 9.1+ funciona la migración atómica Atomic Slot Migration (ASM,ADR 0001), que transfiere un slot como una única transacción sin dejar claves colgadas ante un fallo de red. Además, el operador rescata el clúster cuando se pierde más de la mitad de los maestros a la vez (ADR 0006) ygossippierde el quórum: aísla los nodos muertos y ejecutaCLUSTER FAILOVER TAKEOVERen las réplicas supervivientes (de forma automática paraCacheo mediante la anotaciónvalkey.wellcake.io/quorum-takeoverparaDurable).
Operación sin interrupciones: reinicio proactivo, rotación de secretos y copias en S3
Sigamos con el ejemplo del clúster Replication: supongamos que hemos actualizado la imagen o modificado los límites de memoria.
En una actualización normal, Kubernetes apaga de golpe el pod maestro: mientras el sistema detecta el fallo y redirige el tráfico, pasan de 15 a 20 segundos de indisponibilidad para escritura. En wellcake, el reinicio proactivo (ADR 0004) se activa con la anotación valkey.wellcake.io/proactive-rollout: "true", que pasa el StatefulSet al modo OnDelete. El operador actualiza las réplicas una por una y, antes de detener al maestro, transfiere el liderazgo (replica promote, CLUSTER FAILOVER o SENTINEL FAILOVER) a una réplica ya actualizada. El antiguo maestro se reinicia como una réplica más, reduciendo el tiempo de caída prácticamente a cero. En imágenes de Valkey 9.0+ se activa además la directiva shutdown-on-sigterm failover.
Es cómodo gestionar el clúster mediante los interruptores integrados y la extensión de CLI:
valkey.wellcake.io/proactive-rollout: "true"— actualización sin tiempo de inactividad con transferencia previa del rol de maestro;valkey.wellcake.io/rotate-password— cambio de contraseñas al vuelo medianteACL SETUSERsin reiniciar pods;- plugin
kubectl valkey— comprobación rápida de estado (status), copia de seguridad (backup), resharding (reshard), conmutación del maestro (failover) y pausa del clúster (hibernate).
Por seguridad, las réplicas se conectan al maestro con la cuenta de servicio replicator (+psync +replconf +ping) sin acceso a las claves. Los certificados TLS actualizados se cargan al vuelo mediante CONFIG SET tls-cert-file (más comprobación automática tls-auto-reload-interval 3600). Las copias de seguridad en S3 se toman de forma programada con un CronJob mediante valkey-cli --rdb con restauración desde spec.restoreFrom, y el campo spec.replicateFrom levanta replicación asíncrona entre regiones combinando certificados (replicateFrom.caSecret) para TLS mutuo.
Dónde ahorra recursos del equipo wellcake y cuándo conviene esperar
Controladores como wellcake muestran cómo la automatización se traslada de las consolas en la nube al ecosistema abierto (sobre la evolución de estas soluciones hablamos en el resumen de seis herramientas de ingeniería de plataformas para Kubernetes). Pero cada herramienta tiene sus condiciones de trabajo y sus límites.
El operador encaja muy bien en equipos con sus propios clústeres de Kubernetes en bare-metal o en varias nubes que necesiten gestionar de forma declarativa su parque de Valkey vía GitOps, separar lecturas y escrituras en distintos servicios y automatizar el resharding junto con las instantáneas en S3.
No conviene implantarlo en dos casos:
- Miniproyectos y entornos desechables. Para un servicio pequeño donde perder la caché al reiniciar no se nota, instalar un operador y CRDs es una complejidad innecesaria; allí basta un contenedor único.
- Entornos financieros críticos con SLA estricto. Los propios autores señalan el estado
early / experimental: las API están en fasesv1alpha1yv1beta1, y los webhooks de validación vienen desactivados por defecto (--set webhooks.enabled=true). Antes de llevarlo a producción, conviene rodar el operador en un entorno de pruebas.
Pasar a Valkey en Kubernetes ya no obliga a escribir frágiles scripts de conmutación ni a soportar pausas de escritura en las actualizaciones: wellcake reúne cuatro topologías, failover sin cortes y copias en S3 en un solo recurso. Si quieres estudiar el código del controlador, revisar las notas en la carpeta docs/adr/ o probar el plugin kubectl valkey, pásate por la documentación y los ejemplos de manifiestos en el repositorio del proyecto.