Imagina esta escena tan típica: cae la tarde, arranca el pico de tráfico en tu servicio, el tiempo de respuesta de la API empieza a trepar sin freno y las gráficas de latencia p99 se tiñen de un rojo alarmante. Entras al servidor por SSH, abres htop y te topas con la paradoja de siempre: un núcleo de CPU está clavado al 100%, mientras los otros treinta y un núcleos de tu flamante procesador de 32 cores descansan plácidamente sin hacer nada.
Cualquier desarrollador backend conoce de sobra al culpable de este drama: el legendario Redis. allá por 2009, Salvatore Sanfilippo diseñó Redis con un ciclo de eventos (event loop) monohilo. Sin mutex, con código en C limpio y atomicidad estricta. Pero el hardware de los servidores hace años que escala sumando núcleos, y nuestra navaja suiza favorita sigue encerrada en los límites de uno solo.
Justo ese cuello de botella arquitectónico es el que viene a resolver KiviDB, un nuevo almacenamiento in-memory de código abierto con búsqueda integrada y escrito en Rust. Vamos a abrir el capó para ver cómo funciona por dentro y qué concesiones exige a cambio.
El techo de un solo núcleo: el precio de la clusterización
Cuando un núcleo de Redis toca el 100%, solo te quedan dos salidas: resignarte a las colas de espera o montar un Redis Cluster. Pero clusterizar dentro de un mismo servidor físico supone pagar un impuesto de ingeniería bastante pesado:
- Tienes que configurar el enrutamiento de red entre decenas de procesos y mantener abiertos puertos del 6379 al 6410;
- Cualquier operación compuesta como
MGETo una transacción exige que todas las claves vivan en el mismo hash slot, lo que te obliga a ensuciar el código con hash tags del estilouser:{1001}:profile; - Las librerías cliente de tu aplicación tienen que rastrear la topología de nodos e interceptar redirecciones
MOVED.
La analogía es muy simple: imagina un supermercado con 32 cajas donde solo trabaja una cajera. Montar un Redis Cluster es como construir treinta quioscos independientes al lado, cada uno con su propia valla, en lugar de sentar a más cajeros en las cajas contiguas.
Forks como Valkey se mantuvieron fieles a la arquitectura clásica por pura compatibilidad, mientras que Dragonfly apostó por C++. KiviDB ataca el problema apoyándose en el modelo de memoria de Rust.
Sharding por núcleos y la magia de io_uring
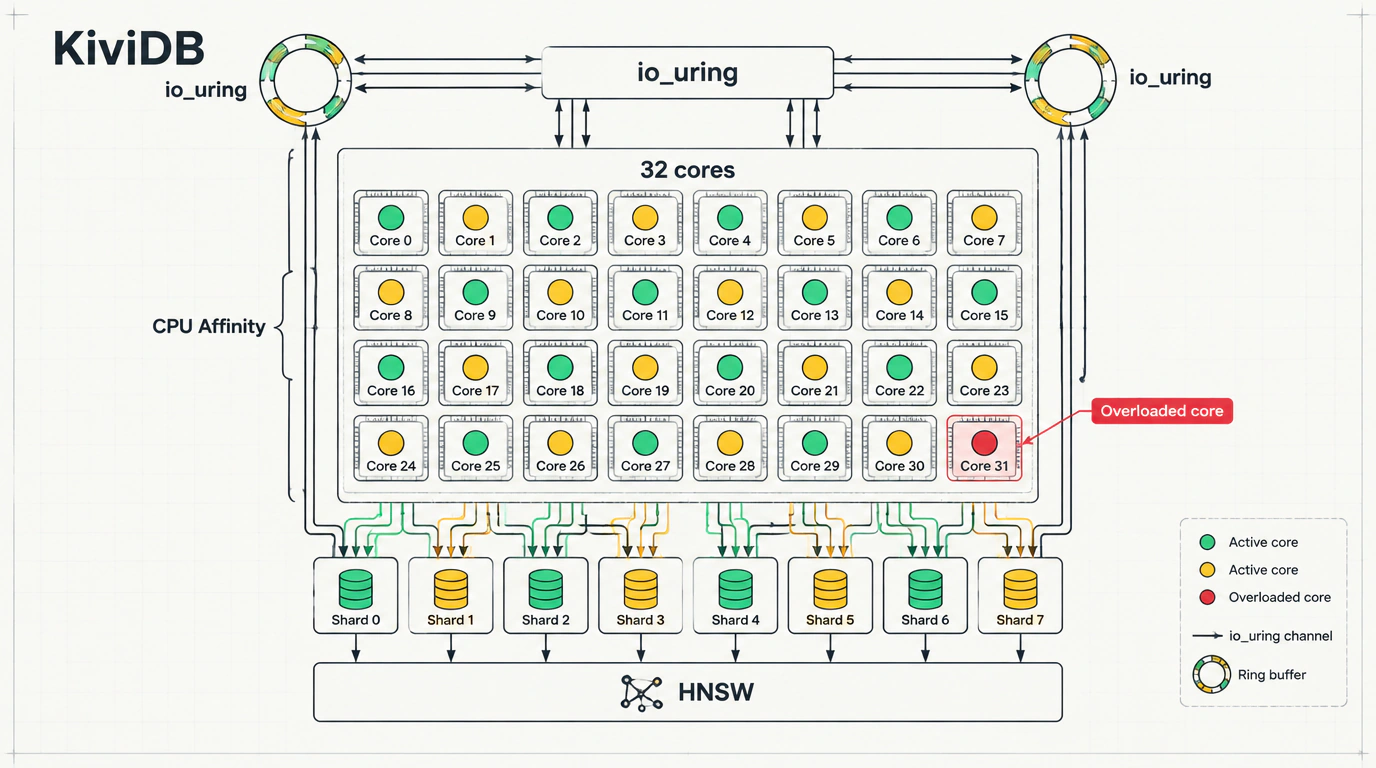
En el corazón de KiviDB late una arquitectura particionada por núcleo (sharded-by-core in-memory design). El espacio de claves se divide en particiones independientes y cada hilo de trabajo queda anclado de forma estricta a un núcleo de CPU concreto (CPU affinity).
Cuando llega un lote de comandos, KiviDB enruta cada clave directamente al hilo dueño de ese segmento de memoria. Como cada hilo tiene el control exclusivo sobre su partición, dentro de KiviDB no hacen falta bloqueos globales ni mutex.
La entrada/salida de red en Linux se apoya en la interfaz asíncrona del sistema io_uring a través del crate tokio_uring. En lugar de malgastar ciclos con cambios de contexto entre el espacio de usuario y el kernel, KiviDB intercambia datos mediante ring buffers (búferes circulares). Y si las políticas de seguridad bloquean io_uring, el runtime conmuta automáticamente a Tokio.
KiviDB implementa de forma transparente los protocolos binarios RESP2 y RESP3. Tus librerías habituales (redis-py, go-redis, colas como BullMQ o Celery) se conectan sin tocar una línea de código. Por defecto escucha en el puerto 6380, así que puedes levantarlo junto a tu Redis de producción para hacer pruebas sin estorbar.
Búsqueda vectorial HNSW integrada
Con el auge del RAG, es muy común necesitar búsquedas semánticas sobre vectores de documentos. Lo habitual es levantar una base de datos aparte (Qdrant, Milvus) o cargar extensiones pesadas.
KiviDB ya trae de serie un motor vectorial y de texto completo compatible con la sintaxis de Redis Stack (FT.*). Soporta índices FLAT (búsqueda exacta) y HNSW (grafo para aproximación de vecinos más cercanos), almacenando los vectores en formato FLOAT32 dentro de hashes estándar (HASH).
Aquí encontré un detalle de ingeniería brillante: a diferencia de otros sistemas donde al reiniciar el servidor toca reconstruir el grafo vectorial durante horas, KiviDB serializa el propio grafo HNSW ya calculado dentro del volcado dump.kdb cuando ejecutas SAVE. Al arrancar de nuevo, el grafo se carga en cuestión de segundos. También incluye soporte para registro de escritura anticipada (--aof).
Prueba de fuego: conexión y benchmarks
Levantemos una instancia de prueba con Docker para comprobar cómo responde:
# Arrancamos el contenedor de KiviDB en el puerto 6380
docker run -d --name kividb-test -p 6380:6380 kividb/kividb:latest

# Verificamos la conexión y escribimos datos por protocolo RESP
redis-cli -p 6380 SET user:1001:session '{"role":"developer"}' EX 3600
redis-cli -p 6380 GET user:1001:session
Ahora creamos un índice vectorial HNSW y lanzamos una búsqueda de los cinco vecinos más cercanos (KNN 5):
# Creamos un índice HNSW para vectores de cuatro dimensiones
redis-cli -p 6380 FT.CREATE idx:articles ON HASH PREFIX 1 article: SCHEMA \
  title TEXT embedding VECTOR HNSW 10 TYPE FLOAT32 DIM 4 DISTANCE_METRIC COSINE M 16 EF_CONSTRUCTION 128

# Insertamos un artículo y ejecutamos la búsqueda vectorial
redis-cli -p 6380 HSET article:42 title "Sharding" embedding "\xcd\xcc\xcc=\xcd\xccL>\x9a\x99\x99>\xcd\xcc\xcc>"
redis-cli -p 6380 FT.SEARCH idx:articles "*=>[KNN 5 @embedding $vec]" PARAMS 2 vec "\xcd\xcc\xcc=\xcd\xccL>\x9a\x99\x99>\xcd\xcc\xcc>" DIALECT 2
En un servidor AWS Graviton3 c7gn.metal de 32 núcleos con pipelining, KiviDB alcanzó 21.2 millones de GET/s y 19.2 millones de SET/s. Eso supone multiplicar por 2.3 el rendimiento de Dragonfly 2.0.2 (9.1 millones de GET/s) y superar casi 9 veces a Redis 8.10 (2.4 millones de GET/s). Bajo carga de 1,600 clientes simultáneos, la latencia p99 se quedó en 13.9 ms, frente a los 33.9 ms de Dragonfly y los 72.1 ms de Redis.
Ya analizamos un reto cercano sobre gestión de memoria en Despliegue tolerante a fallos de ArgoCD en modo Stateless sobre Kubernetes bare-metal, donde la fiabilidad de la caché marcaba directamente la estabilidad del controlador.
Puntos ciegos y límites de uso
Antes de meter KiviDB en tu stack, conviene tener en cuenta cuatro matices importantes:
- Licencia AGPL-3.0: Los clientes de red no quedan sujetos al copyleft, pero los equipos de seguridad de muchas corporaciones vetan la licencia AGPL en su infraestructura interna.
- Perfil seccomp: Para exprimir
io_uringal máximo, el contenedor necesita el flag--security-opt seccomp=unconfined, algo que requiere aprobación previa en clústeres restringidos. - Operaciones cross-shard: Los comandos que tocan claves repartidas entre distintas particiones exigen sincronización entre hilos y reducen la ventaja del sharding.
- Madurez: El proyecto va por la versión 1.1 (alrededor de 800 estrellas en GitHub), así que su historial en producción todavía se está forjando.
Levanta KiviDB en el puerto alternativo 6380 y configura un proxy para duplicar hacia él una fracción del tráfico de lectura de producción. Así comprobarás cómo se comporta bajo tu carga real sin poner en peligro a tus usuarios.