Una historia de detectives clásica en el desarrollo backend: el ingeniero de guardia ve en Grafana un pico repentino en el tiempo de respuesta de los endpoints HTTP de un servicio en Go. Las respuestas tardan un segundo entero en lugar de los veinte milisegundos habituales. Corre a los registros de la base de datos, activa el slow query log y se lleva una sorpresa mayúscula: en PostgreSQL o MySQL todo está impoluto. Cada consulta SQL se ejecuta en unos fulminantes dos milisegundos.
¿Dónde se esfuman entonces esos cientos de milisegundos? La respuesta se esconde en una cola invisible para el gestor de base de datos: dentro del paquete estándar database/sql. El retraso ocurre antes siquiera de que el primer byte de la consulta salga a la red: las goroutines se bloquean en un semáforo interno de la aplicación esperando a que quede libre un socket TCP del pool. Ya vimos un síntoma parecido en PostgreSQL va lento pero la CPU está libre: cazando consultas pesadas con pg_stat_statements, donde la causa real de las demoras se camuflaba tras métricas de procesador aparentemente sanas.
Cómo funciona el pool y por qué aparece la inanición
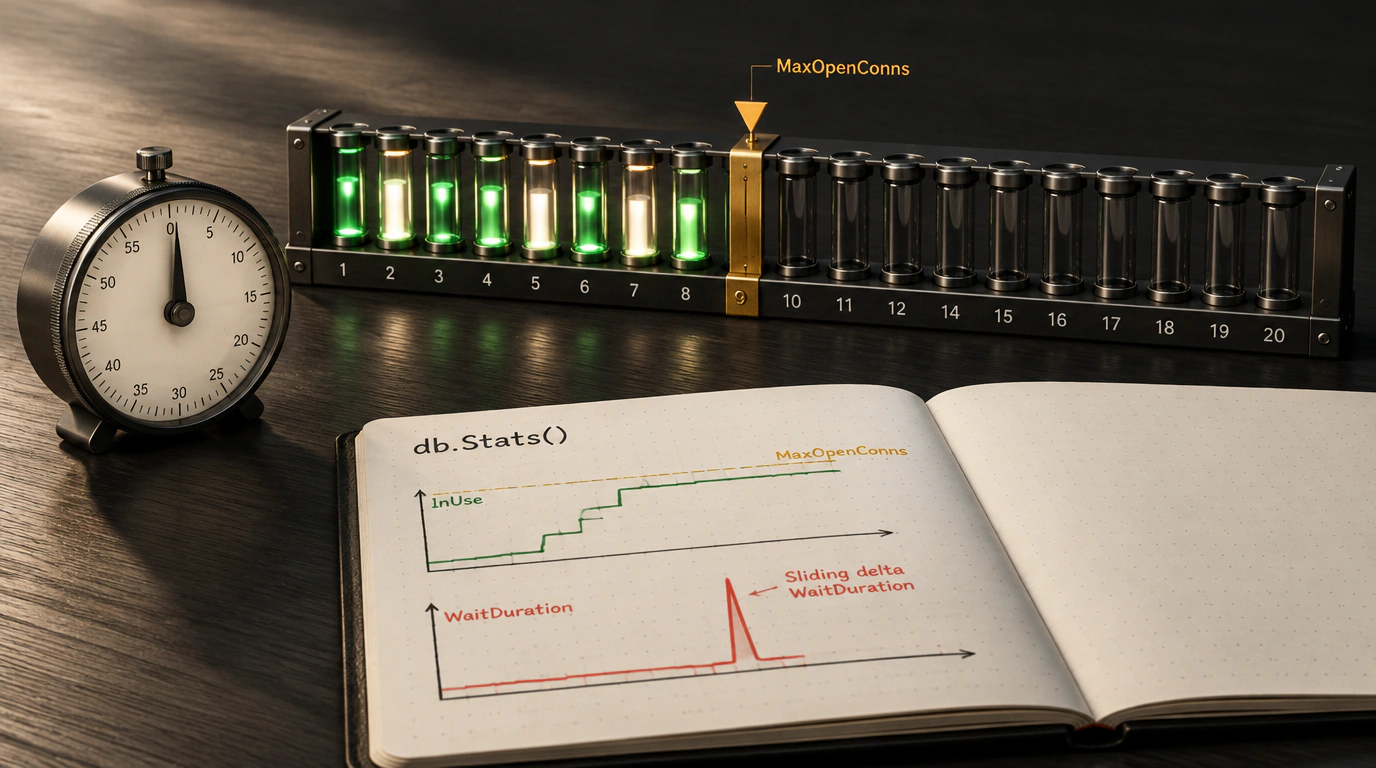
El objeto *sql.DB en Go no representa una única conexión física de red, sino un pool inteligente y seguro para concurrencia. Cuando tu código llama a db.Query() o db.Exec(), el runtime toma un socket libre del pool o abre uno nuevo si el total actual está por debajo del límite SetMaxOpenConns.
El problema estalla cuando se alcanza ese tope y todas las conexiones están ocupadas: las nuevas goroutines se quedan dormidas en un mutex. Si alguien olvidó llamar a rows.Close() o una transacción se quedó colgada esperando una respuesta HTTP externa, el socket no regresa al pool. Las peticiones entrantes se amontonan en cola y desencadenan un efecto de inanición en cascada (pool starvation).
Ajustar bien el pool exige equilibrar cuatro parámetros:
package main

import (
    "database/sql"
    "time"

    _ "github.com/jackc/pgx/v5/stdlib"
)

// InitPool configura límites predecibles para el pool de conexiones
func InitPool(db *sql.DB) {
    // Techo estricto de sockets físicos (InUse + Idle)
    db.SetMaxOpenConns(40)

    // Cantidad de conexiones en espera listas para reutilizarse
    db.SetMaxIdleConns(20)

    // Rotación de sockets para evitar fugas de memoria y cambios de DNS
    db.SetConnMaxLifetime(30 * time.Minute)

    // Cierre de sockets sobrantes en reposo cuando baja la carga
    db.SetConnMaxIdleTime(5 * time.Minute)
}
Introspección con db.Stats() y cálculo de deltas
Para cazar este cuello de botella en producción, la librería estándar ofrece el método db.Stats(), que devuelve la estructura sql.DBStats con contadores del estado del pool:
InUse: cuántos sockets están ejecutando consultas en este instante;Idle: cuántas conexiones listas esperan trabajo;WaitCount: cuántas veces tuvieron que bloquearse las goroutines por falta de espacio;WaitDuration: tiempo total acumulado esperando conexiones desde que arrancó el proceso.
La trampa clásica de novato es mirar el valor absoluto de WaitCount. Como ese contador crece de forma monótona desde el inicio del pod, una cifra alta por sí sola no dice nada. Para diagnosticar de verdad necesitas medir la delta móvil:
package main

import (
    "database/sql"
    "log"
    "time"
)

// MonitorPoolDeltas mide periódicamente la velocidad a la que crece la cola del pool
func MonitorPoolDeltas(db *sql.DB, interval time.Duration) {
    ticker := time.NewTicker(interval)
    var lastWaitCount int64
    var lastWaitDuration time.Duration

    for range ticker.C {
        stats := db.Stats()

        deltaWaitCount := stats.WaitCount - lastWaitCount
        deltaWaitDuration := stats.WaitDuration - lastWaitDuration

        lastWaitCount = stats.WaitCount
        lastWaitDuration = stats.WaitDuration

        if deltaWaitCount > 0 {
            avgWait := deltaWaitDuration / time.Duration(deltaWaitCount)
            log.Printf("[ATENCIÓN] Inanición del pool: %d goroutines esperaron turno, espera media: %v (InUse: %d, Open: %d)",
                deltaWaitCount, avgWait, stats.InUse, stats.OpenConnections)
        }
    }
}
Cuando un ingeniero ve subir WaitCount, su primer impulso suele ser disparar SetMaxOpenConns de 40 a 500. Pero si tienes 20 pods corriendo en Kubernetes, la base de datos recibirá hasta 10,000 sesiones paralelas. PostgreSQL caerá al instante con el error «sorry, too many clients already» al quedarse sin RAM para los procesos worker del backend. La solución real pasa por acortar las transacciones y sacar los cálculos largos fuera de los bloqueos.