Cualquier programador ha vivido este drama al menos una vez en su carrera. Llegas a un proyecto nuevo: aquella startup ágil de hace cinco años se ha convertido en una plataforma corporativa rentable, el negocio marcha viento en popa, el equipo supera el centenar de ingenieros y el repositorio ya rebasa el millón de líneas de código. Sin embargo, el ambiente en el equipo recuerda al de una fortaleza asediada.
El cambio más trivial —por ejemplo, añadir un campo de descuento al cálculo del carrito de compra— se transforma en una investigación de dos semanas con los líderes de tres departamentos distintos. A los ingenieros les da pánico tocar módulos antiguos porque cualquier ajuste provoca caídas en cascada en servicios de producción sin relación aparente. La compilación falla por dependencias circulares, los tests unitarios exigen trescientas líneas para inicializar mocks y el tiempo hasta llevar un cambio a producción (Lead Time to Production) crece de forma exponencial.
En la industria se suele culpar de todo a «la falta de microservicios», a «no usar arquitectura limpia» o a la típica «deuda técnica». Pero si miras bajo el capó de las bases de código gigantes reales, la raíz es más profunda. La experiencia de Dmitry Kmaladze —arquitecto de sistemas principal en grandes tecnológicas estadounidenses—, desgranada en una extensa charla técnica con Timur Shemsedinov en el canal HowProgrammingWorks, deja al desnudo la crisis estructural de la programación industrial moderna.
Vamos a desmontar pieza a pieza por qué los patrones habituales de programación orientada a objetos (POO) y los frameworks populares convierten los repositorios millonarios en un pantano intransitable, cómo levantar una arquitectura que separe de forma tajante el cálculo de negocio del cableado del sistema y por qué ese enfoque protege la cordura del equipo durante décadas.
La crisis de escala: por qué los frameworks y la POO pesada se rompen al millón de líneas
En proyectos pequeños de entre 10,000 y 50,000 líneas, herramientas como Spring Boot, NestJS o ASP.NET Core parecen el colmo de la elegancia. El desarrollador coloca una anotación @Injectable(), declara el servicio de base de datos en el constructor del controlador, añade @Entity() sobre la clase y en un par de días tiene una aplicación funcionando. La velocidad inicial deslumbra.
Pero cuando la base de código supera las 500,000 líneas y luego cruza el millón, toda esa magia del framework empieza a cobrarse su venganza sin piedad. Aparecen tres trampas sistémicas:
- Acoplamiento implícito mediante dependencias transitivas.
La POO clásica fomenta encapsular comportamiento y estado dentro de clases. Así,
OrderServicetermina importandoUserRepository,PaymentGateway,AuditLoggeryEmailNotificationService. Cada una de esas clases arrastra a su vez decenas de servicios más. Al final, la base de código deja de ser un grafo acíclico dirigido (DAG) para convertirse en una maraña densa donde cada módulo depende indirectamente de todos los demás. - Rehenes del ciclo tecnológico del framework. Todo framework web popular vive sujeto a las modas. Cada 3 o 5 años sufre un giro de paradigma: sus autores declaran obsoletas (deprecated) las APIs antiguas, cambian la sintaxis de los decoradores o sustituyen directamente el runtime base. Si tus reglas de negocio (cálculo de impuestos, cargos a saldos, verificación de permisos) están soldadas a las clases, anotaciones e interfaces del framework, actualizar el stack equivale a reescribir el millón de líneas entero. En la práctica nadie lo hace, y el proyecto queda congelado para siempre en una versión antigua y vulnerable.
- Dilución del contexto del dominio. Si abres el código fuente de un servicio enterprise típico, verás un cóctel explosivo: en el mismo método se valida el token JWT del usuario, se abre una transacción en PostgreSQL, se registra el cuerpo de la petición en Elasticsearch, se publica un mensaje en un tópico de Kafka y, perdido entre todo ese ruido, aparecen tres líneas con la matemática real del descuento. Ya examinamos esta degradación en Erosión arquitectónica: por qué el vibe coding destruye sistemas longevos, donde generar código sin control multiplicaba la entropía de dependencias.
Cuando la lógica de negocio queda untada en una capa fina sobre adaptadores de red y llamadas de infraestructura, el sistema se vuelve ingobernable. La única forma de recuperar el timón es trazar una frontera estricta en el propio manifiesto arquitectónico.
Separación de poderes: dominio puro frente al cableado del sistema (Wiring)
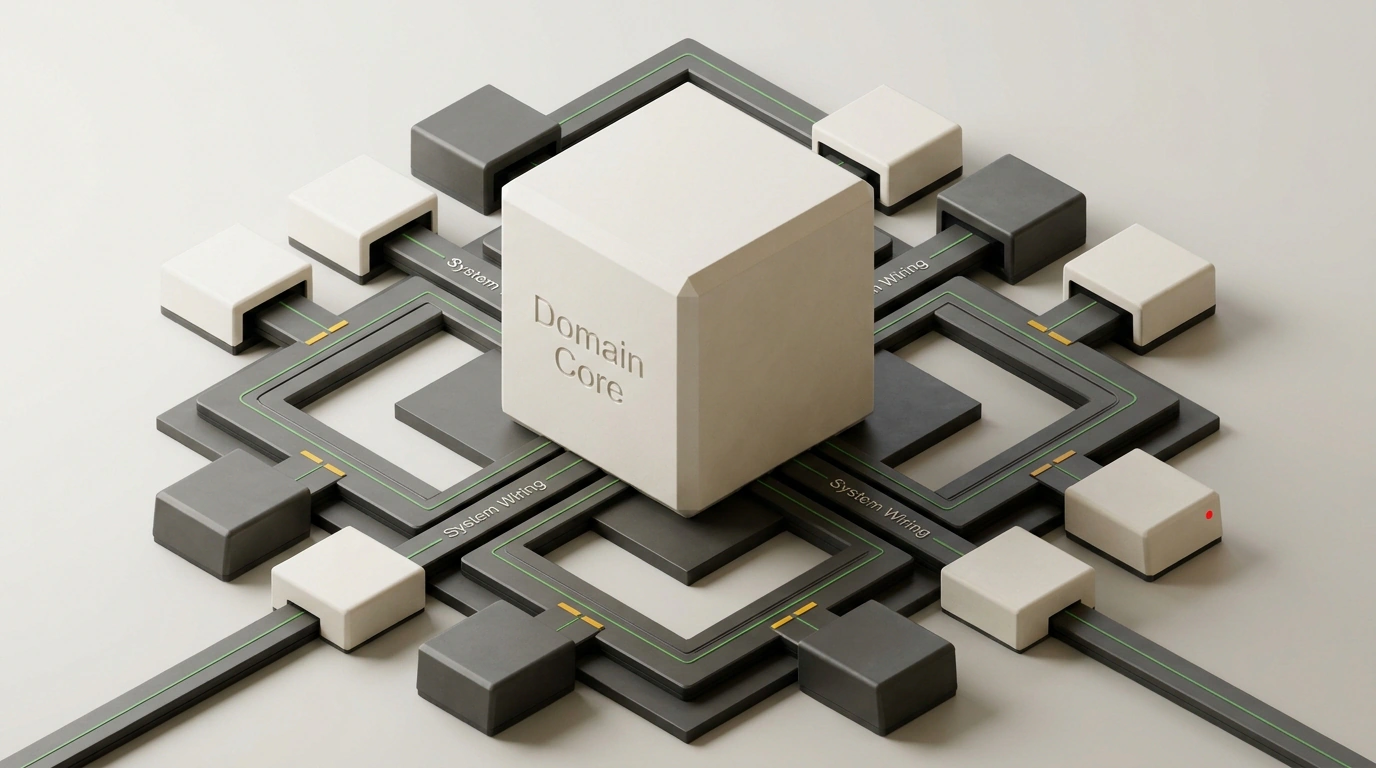
El postulado central de Dmitry Kmaladze suena engañosamente simple: la arquitectura de un sistema de software debe separar de raíz la lógica computacional del dominio (Domain Logic) del cableado del sistema (System Wiring).
Diagrama de despiece de ingeniería de un smartphone que separa el chip central de lógica computacional de la placa externa de cableado del sistema.
Usemos una analogía física muy clara. Piensa en un smartphone moderno. En su interior lleva un procesador que ejecuta algoritmos de compresión de vídeo o calcula hashes criptográficos. Al procesador le da exactamente igual de dónde salieron esos bytes: si llegaron por Wi-Fi, si se leyeron de la memoria flash o si los introdujo el usuario por la pantalla táctil. El chip es un dispositivo de cálculo puro.
Todo el resto del teléfono —la placa base, los módulos de radio, los controladores del bus PCIe y la gestión de energía— forma el sistema de cableado. Su único trabajo es entregar los bytes adecuados a la entrada del chip en el momento justo y recoger el resultado para enviarlo al altavoz o a la pantalla. La placa base no hace matemáticas de algoritmos, y el procesador no tiene ni idea de qué marca es la antena soldada a la placa.
En tu base de código debe regir exactamente la misma división:
- Núcleo del dominio (Domain Core): únicamente funciones puras deterministas y estructuras de datos inmutables (immutable). En esta capa están terminantemente prohibidas las operaciones de entrada/salida (I/O), llamadas de red, consultas a bases de datos, lecturas de relojes del sistema o acceso a variables de entorno. El módulo recibe datos de entrada y devuelve el resultado del cálculo;
- Adaptadores del sistema (System Adapters): módulos finos y aislados que saben hablar con el mundo exterior: lanzar una consulta SQL a PostgreSQL, enviar un evento a RabbitMQ o serializar una respuesta JSON para un cliente gRPC. Los adaptadores no contienen reglas de negocio;
- Capa de cableado (Wiring / Composition Root): un espacio dedicado en la aplicación donde los adaptadores se conectan con las funciones puras de negocio mediante contratos transparentes.
Anatomía del núcleo puro: funciones deterministas sin noción de bases ni red
Veamos cómo aterriza este principio en código real de TypeScript. Supongamos que diseñamos un flujo crítico para calcular el importe y validar las condiciones de un pedido corporativo complejo.
En el código enterprise tradicional, alguien habría creado un OrderService inyectándole en el constructor el pool de base de datos y el logger. Con el cableado separado, el núcleo del dominio queda completamente aislado:
// Listado 1. Núcleo puro de lógica de negocio (Domain Core)
// Fíjate: ¡en el archivo no hay ni un solo import externo! Ni frameworks, ni BD, ni ORM.

export interface OrderItem {
  readonly id: string;
  readonly price: number;
  readonly quantity: number;
}

export interface CustomerProfile {
  readonly id: string;
  readonly tier: 'standard' | 'premium' | 'vip';
  readonly balance: number;
}

export interface DiscountPolicy {
  readonly rate: number;
  readonly maxCap: number;
}

export interface CalculationResult {
  readonly subtotal: number;
  readonly discountAmount: number;
  readonly total: number;
  readonly isEligible: boolean;
}

// Función pura determinista: el resultado depende estrictamente de los argumentos de entrada
export function calculateOrderSettlement(
  items: readonly OrderItem[],
  customer: CustomerProfile,
  policy: DiscountPolicy
): CalculationResult {
  // 1. Cálculo del subtotal del carrito
  const subtotal = items.reduce((acc, item) => acc + item.price * item.quantity, 0);

  // 2. Cálculo del descuento base según el nivel del cliente
  let rawDiscount = 0;
  if (customer.tier === 'vip') {
    rawDiscount = subtotal * policy.rate;
  } else if (customer.tier === 'premium') {
    rawDiscount = subtotal * (policy.rate * 0.5);
  }

  // 3. Aplicación del tope máximo de descuento (maxCap)
  const discountAmount = Math.min(rawDiscount, policy.maxCap);
  const total = Math.max(0, subtotal - discountAmount);

  // 4. Verificación de la solvencia financiera del comprador
  const isEligible = customer.balance >= total;

  return {
    subtotal,
    discountAmount,
    total,
    isEligible,
  };
}
Observa con calma el Listado 1. No hay palabras clave async/await, ni excepciones lanzadas a mitad del cálculo, ni ataduras a ninguna librería concreta.
Esta misma función puede ejecutarse sin cambios en Node.js, compilarse a WebAssembly para correr en el navegador o desplegarse en un worker ligero de Cloudflare Workers. Es cristalina: si pasas los mismos datos de entrada, obtendrás siempre el mismo resultado bit por bit.
La capa de cableado: fábricas de Use Case, puertos y ensamblaje aislado
Ahora surge la pregunta lógica: si la función no sabe nada del mundo exterior, ¿quién le trae los datos desde la base y guarda el resultado en disco?
Para eso existe la capa de cableado del sistema. En la arquitectura de Kmaladze se implementa mediante funciones fábrica de casos de uso (Use Case Factories) y puertos de entrada/salida (Ports):
// Listado 2. Capa de cableado del sistema y fábrica del escenario (System Wiring)
// Aquí la matemática pura se conecta con los adaptadores de infraestructura.

import { calculateOrderSettlement, OrderItem, CustomerProfile, DiscountPolicy } from './domain-core';

// Puerto de almacenamiento: contrato abstracto sin ataduras a PostgreSQL ni MongoDB
export interface OrderStoragePort {
  loadCustomer(customerId: string): Promise<CustomerProfile>;
  loadPolicy(): Promise<DiscountPolicy>;
  commitTransaction(orderId: string, total: number): Promise<void>;
}

// Puerto de telemetría y registro
export interface LoggerPort {
  info(message: string, context?: Record<string, unknown>): void;
  warn(message: string, context?: Record<string, unknown>): void;
}

// Fábrica del escenario de negocio: realiza el ensamblaje de dependencias (Wiring)
export function createOrderCheckoutWorkflow(
  storage: OrderStoragePort,
  logger: LoggerPort
) {
  // Función de escenario devuelta: orquestador del flujo de datos
  return async function executeCheckout(
    orderId: string,
    customerId: string,
    items: readonly OrderItem[]
  ): Promise<{ success: boolean; total: number }> {
    logger.info('Inicio del proceso de confirmación de pedido', { orderId, customerId });

    // 1. Obtención asíncrona de los datos necesarios desde la infraestructura
    const [customer, policy] = await Promise.all([
      storage.loadCustomer(customerId),
      storage.loadPolicy(),
    ]);

    // 2. Delegación de la matemática a la función pura de lógica de dominio
    const settlement = calculateOrderSettlement(items, customer, policy);

    // 3. Bifurcación del flujo según el resultado del cálculo
    if (!settlement.isEligible) {
      logger.warn('Pedido rechazado: saldo del cliente inferior al importe requerido', {
        customerId,
        required: settlement.total,
        balance: customer.balance,
      });
      return { success: false, total: settlement.total };
    }

    // 4. Persistencia de efectos secundarios mediante el puerto de almacenamiento
    await storage.commitTransaction(orderId, settlement.total);
    logger.info('Pedido registrado con éxito en la base de datos', { orderId, total: settlement.total });

    return { success: true, total: settlement.total };
  };
}
Fíjate en la limpieza con la que se reparten el trabajo en el Listado 2:
- La función
executeCheckoutno ejecuta consultas SQL ni sabe en qué tabla viven los clientes; - Actúa como un despachador: pide las estructuras al puerto, se las entrega a
calculateOrderSettlement, revisa la banderaisEligibley ordena guardar el resultado; - El ensamblaje de la fábrica ocurre en un único punto de entrada de la aplicación (
Composition Root). Si mañana la empresa decide cambiar PostgreSQL por KiviDB o ScyllaDB, el núcleo del dominio no cambia ni una coma: solo sustituyes la implementación deOrderStoragePort.
En lugar de buscar servicios dinámicamente en un registro global durante la ejecución (Runtime Service Locator), las fábricas aprovechan el tipado estático estricto de TypeScript. Si olvidas pasarle el logger o el adaptador de base de datos a la fábrica, el proyecto ni siquiera compila. Se acabaron las caídas sorpresa en producción porque el contenedor DI no pudo resolver una dependencia circular al arrancar.
El fin del «infierno de los mocks»: cómo testear la lógica sin simular la base de datos
Pregúntale a cualquier desarrollador de un proyecto enterprise qué es lo que más odia, y te dirá sin dudarlo: escribir tests unitarios para servicios de negocio.
En las arquitecturas clásicas, un test unitario parece una tortura sofisticada. Para probar una bifurcación de descuento de 5 líneas, el ingeniero tiene que escribir 80 líneas configurando el framework de pruebas: mockear repo.findOne, mockear el gestor de transacciones, mockear el logger y vigilar que cada mock devuelva promesas con la forma exacta. Lo peor de todo es que, al menor cambio en una consulta SQL, el test se rompe aunque las reglas de negocio sigan intactas. Los tests acaban verificando detalles de implementación en vez del comportamiento.
Con un núcleo puro, testear vuelve a dar gusto:
- Para validar la lógica de negocio no necesitas mocks en absoluto. Creas tres objetos con cifras de prueba en memoria, se los pasas a
calculateOrderSettlementy compruebas el resultado con un simpleassert.strictEqual. El test corre en microsegundos; - Probar la capa de cableado (la fábrica del escenario) solo requiere stubs diminutos en memoria que devuelvan un perfil fijo;
- Los adaptadores de infraestructura se validan con tests de integración aislados en contenedores reales de Testcontainers, probando SQL de verdad contra una base viva.
Así, la pirámide de pruebas vuelve a apoyarse sobre su base: verificar cientos de escenarios del dominio con total fiabilidad tarda segundos en el pipeline de CI.
La ilusión de los microservicios y la ley de Conway en bases de código gigantes
Cuando un monolito empieza a atascarse, la dirección suele tomar una decisión tajante: «¡Partamos todo en microservicios!». Contratan ingenieros DevOps, configuran Kubernetes y trocean el código en 50 repositorios pequeños.
Pero si el monolito original sufría por mezclar cableado y lógica de negocio, trocearlo provoca una catástrofe conocida como monolito distribuido. El acoplamiento no desaparece: simplemente se muda de llamadas locales entre funciones a peticiones de red HTTP/gRPC mucho menos fiables. Ahora, en lugar de un error instantáneo del compilador, sufres latencias de red, caídas parciales de nodos, pérdida de integridad transaccional y la necesidad de montar trazado distribuido.
Dmitry Kmaladze insiste en que la frontera de un servicio no debe dictarla el tamaño de una carpeta de código, sino la estructura organizativa de los equipos (ley de Conway).
Si dos equipos modifican a diario el mismo escenario de negocio, separar su código en servicios de red distintos solo frenará el desarrollo. Es mucho más sano mantener el código en un único monorepositorio con linters estrictos para las fronteras entre módulos:
- Los núcleos puros de distintos dominios pueden convivir en paquetes vecinos;
- Tienen prohibido importarse directamente entre sí;
- La interacción se configura exclusivamente en el nivel superior de cableado.
Ya exploramos la naturaleza de las decisiones duraderas en Decisiones arquitectónicas reversibles e irreversibles en la era del código generado, donde vimos que aislar el núcleo de negocio vuelve totalmente reversible la infraestructura tecnológica.
Ruta práctica de migración: cómo desenredar el código legacy existente
Seguro que ahora estás pensando: «Todo eso suena fenomenal para un proyecto que empieza desde cero. ¡Pero nosotros ya tenemos un millón de líneas de espagueti con ORM y decoradores! ¿Cómo sobrevivimos?».
Jamás decretes una moratoria de seis meses sobre nuevas funcionalidades para reescribirlo todo desde cero (Second System Syndrome): el negocio nunca te lo perdonará. La transición se ejecuta mediante el patrón de estrangulamiento (Strangler Fig Pattern):
- Congela la lógica nueva en los servicios antiguos. Cuando entra una tarea de negocio nueva, queda prohibido añadir más métodos a las viejas clases acopladas a la base de datos;
- Extrae funciones puras. Empieza sacando los tramos algorítmicos. Localiza las fórmulas de cálculo dentro de un método gigante, muévelas a un archivo separado sin imports y cúbrelas con tests unitarios simples;
- Define los puertos de interfaz. Describe mediante un contrato de TypeScript qué datos exactos necesita esa función desde la base de datos;
- Convierte el servicio antiguo en un adaptador fino. Deja que la vieja clase de servicio simplemente lea los datos usando el ORM actual y llame a tu nueva función pura.
Paso a paso, el núcleo del dominio irá cristalizando, soltando el lastre de infraestructura, y tu base de código recuperará la flexibilidad y previsibilidad perdidas.
No, las funciones puras no necesitan librerías para sumar números o manipular objetos. Para las tareas de red (parseo de JSON, enrutamiento HTTP, pool de sockets) sigues usando librerías rápidas y probadas (Fastify, Hono, pg), conectándolas únicamente dentro de la capa fina de adaptadores.
Se configuran linters de arquitectura (por ejemplo, dependency-cruiser o reglas de ESLint como no-restricted-imports) en el pipeline de CI/CD para bloquear automáticamente cualquier commit si dentro del directorio domain aparece un import procedente de capas de infraestructura.