En el papel, un clúster de cinco servidores repartidos en tres centros de datos luce indestructible. Parece haber margen de sobra: si cae una máquina o incluso un centro de datos entero, el sistema aguanta. Esa tranquilidad hace que muchos equipos no disparen la alarma cuando uno de los cinco nodos se desconecta en silencio. «Lo arreglamos esta semana, total quedan cuatro vivos». Hasta que se va la luz en una zona y el servicio se congela por completo.
Qué falló realmente en Revolut el 20 de octubre
Exactamente así cayó Revolut el 20 de octubre de 2026. Según su resumen técnico oficial, alrededor de las 06:00 UTC se cortó la energía en la zona de disponibilidad Zone B (europe-west2-b) de Google Cloud en Londres, un centro de datos independiente con su propia red y suministro eléctrico dentro de la región. El incidente del proveedor en la nube duró 7 horas y 52 minutos.
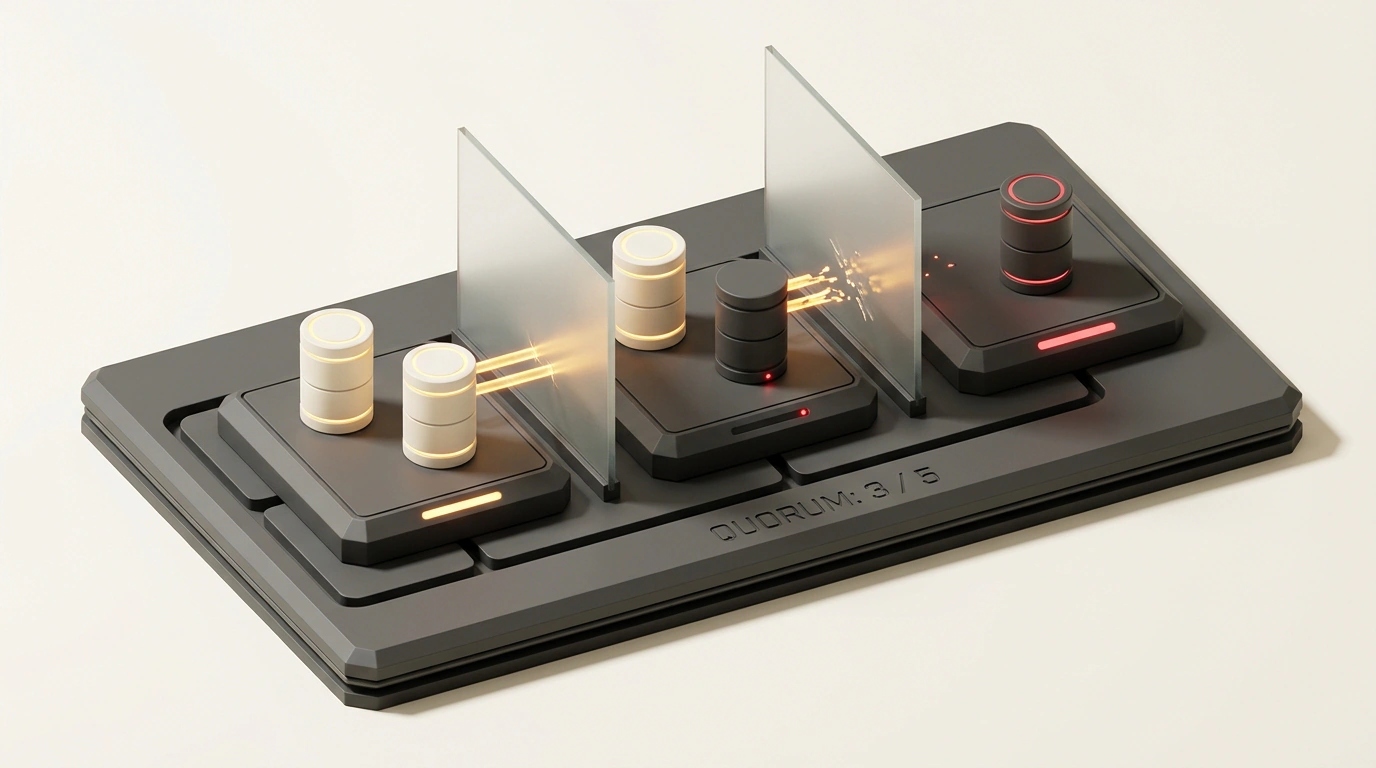
Las bases afectadas en Revolut dependían de grupos de cinco servidores de coordinación en tres zonas (2/2/1). Para hacer el cambio automático de líder (failover) necesitan quórum: mayoría estricta, es decir, al menos tres nodos vivos de cinco. Pero en varios grupos un servidor ya estaba caído antes del apagón; por un hueco en el monitoreo o un reemplazo inconcluso, ninguna alerta sonó. Al caer Zone B, desaparecieron otros dos nodos. Quedaron dos de cinco y la automatización se detuvo.
No fue un error de software, sino una defensa contra el split-brain («cerebro dividido»). Si la pareja restante se hubiera proclamado primaria y la parte aislada hubiera vuelto con el líder antiguo, ambas mitades aceptarían pagos incompatibles. Para un banco eso es peor que estar caído. Todo empeoró por un bucle de dependencias: parte de las herramientas de monitoreo y recuperación de Revolut vivían dentro de la misma Zone B, lo que retrasó la reparación manual. Las tarjetas empezaron a responder hacia las 12:40 UTC y el acceso masivo a la app volvió cerca de las 15:45 UTC.
Revolut no nombró el motor de coordinación. En el canal System Design & Highload, Alexey Rybak planteó la hipótesis de que debajo corría PostgreSQL + Patroni + cinco nodos de etcd, donde etcd guarda el consenso sobre el nodo líder y Patroni conmuta la base. Él mismo aclaró con honestidad que es una educated guess, sin certeza interna. Pero el software da igual: cualquier coordinador basado en Raft, como Consul o ClickHouse Keeper, reaccionaría igual.
Matemáticas del quórum: por qué 2/2/1 no perdona un fallo extra
Imagina un comité de cinco personas donde las decisiones solo pasan con mayoría de votos. Si dos están en una sala y ahí se corta la luz, los otros tres siguen votando sin problema. Pero si uno de esos tres faltó ayer por enfermedad y nadie se enteró, tras el apagón quedan solo dos en la sala. No pueden votar: tal vez los tres del otro lado sigan vivos y hayan decidido otra cosa.
En los clústeres rige la misma fórmula de mayoría ⌊N / 2⌋ + 1. En 2/2/1, el sistema sobrevive a perder una zona o a que fallen dos máquinas sueltas. Pero si un servidor ya estaba caído de antemano, la pérdida de la zona con dos nodos rompe el quórum al instante.
| Esquema de clúster | Quórum | ¿Soporta «zona + 1 nodo»? | Costo en latencia y recursos |
|---|---|---|---|
3 nodos (1/1/1) | 2 de 3 | No (queda 1 nodo) | Latencia mínima de escritura |
5 nodos (2/2/1) | 3 de 5 | No (quedan 2 nodos) | Latencia media, margen engañoso |
5 nodos + árbitro en 4.º DC (2/1/1/1) | 3 de 5 | Sí (salvo zona de 2 nodos + 1) | Casi como 2/2/1, VM barata en 4.ª zona |
9 nodos (3/3/3) | 5 de 9 | Sí (quedan 5 nodos) | Mayor latencia de escritura y tráfico de red |
Todo se reduce no al total de servidores, sino a cuántos votos se lleva un solo incidente. Mientras una zona concentre dos nodos a la vez, cualquier fallo previo de un vecino anula el seguro contra la caída de un centro de datos.
Cómo corregir esta topología en la práctica
Alexey Rybak resumió este principio básico de sistemas distribuidos con su ironía habitual y envió «ánimos a quienes tienen que redactar postmortems públicos después de algo así»:
«Como quien dice, un veterano levanta la vista, se rasca la cabeza y te suelta: colega, mete un nodo en el cuarto DC aunque sea en una VM mínima, o monta un 3/3/3 en lugar de 2/2/1, aunque la latencia suba un poco».
Lo primero que conviene ajustar son las alertas. En un esquema 2/2/1, la caída de un solo servidor debe despertar de inmediato a la guardia, porque ya no queda margen para perder una zona entera.
Si necesitas tolerancia real en la topología, hay dos caminos. El primero es colocar un nodo árbitro (tie-breaker) en una cuarta zona: una máquina virtual mínima sin datos pesados que solo vota en el consenso (o idealmente repartir cinco nodos en cinco zonas). El segundo es pasar a 3/3/3, asumiendo el costo en velocidad: cada escritura debe esperar confirmación de más nodos. La propia documentación de etcd desaconseja inflar el clúster a nueve máquinas para cargas normales y recomienda quedarse en tres o cinco. Y la lección final del caso Revolut: jamás alojes el monitoreo ni las herramientas de recuperación dentro de la misma zona que deben rescatar.