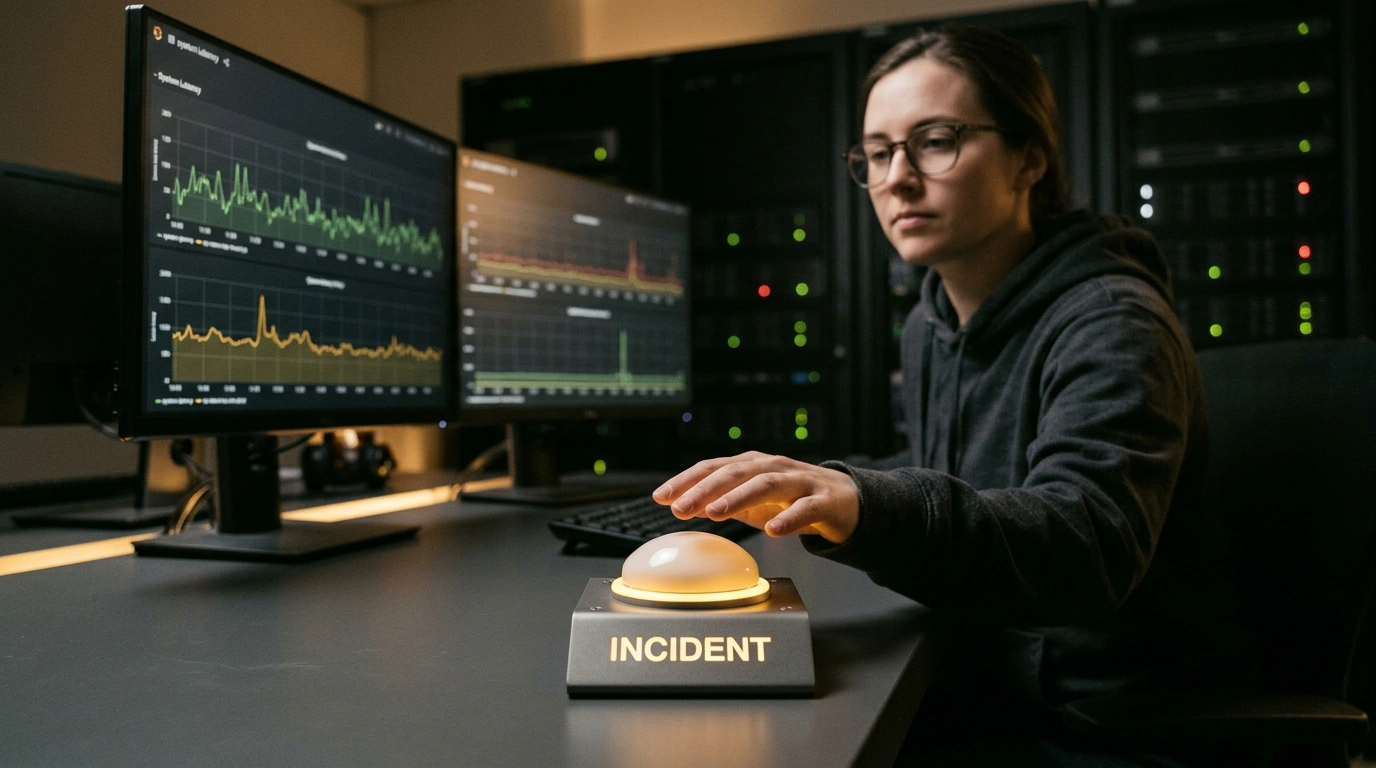
¿Cuántos minutos estás dispuesto a investigar en solitario una gráfica extraña durante tu guardia antes de pulsar el botón de «Declarar incidente»?
La escena es conocida. Estás en tu turno de on-call, esa guardia donde eres el primero en recibir las sorpresas de producción. Hace un par de días ajustaste un panel y entraste a comprobar si dibuja bien las métricas. De pronto notas un quiebre raro. Las alertas callan y el servicio suele ser sólido, pero si está fallando en silencio, va a estallar en grande.
Al instante dan ganas de escarbar logs diez minutos más por tu cuenta: igual fue una ilusión o se arregla solo. Hugo van der Horst, ex SRE y gestor de incidentes en Adyen y hoy fundador de Recoverable, explica esta pausa de forma simple en su ensayo para The Postmortem (publicado originalmente en Uptime Labs y reeditado en el boletín el 30 de octubre de 2026). No es pereza. Quien está de guardia sabe demasiado bien cuánto le cuesta un solo clic.
El precio oculto de un botón
Todos los campos del formulario de incidentes nacieron con buena intención. Elige severity, el nivel de gravedad del fallo que define a quién despertar y con qué urgencia actuar. Señala los productos afectados y estima el impacto. Asume el rol de líder del incidente. Programa un postmortem (el análisis escrito de causas raíz y plan preventivo) y acuerda tareas de seguimiento. En bancos y sectores regulados se suman además plazos estrictos de reporte.
Por separado, cada punto parece menor. Pero cuando todo cae sobre una sola persona en el primer minuto, el costo del botón «Incidente» se dispara por las nubes. La calculadora mental se enciende: voy a activar un montón de burocracia y molestar a gente, ¿y si es una falsa alarma? ¿Y si además tengo que dirigir el análisis cuando nunca lo he hecho? Van der Horst ironiza sobre lo fácil que es caer en el absurdo: «¿Y si estimamos de una vez la pérdida de ingresos antes de que nadie confirme siquiera que algo se rompió?».
La factura doble del silencio
Si la gráfica de verdad anunciaba un fallo, cada minuto en silencio golpea al equipo. Mientras un ingeniero revisa logs solo, compañeros que podrían ayudar en dos minutos no se enteran de nada. Soporte no sabe qué responderles a los clientes en el chat, y quienes entran más tarde arrancan a ciegas y con retraso.
Pero hay un segundo costo más dañino. Cuando declarar un incidente sale caro, la gente busca atajos. Empieza el shadow fixing, los arreglos en la sombra: los fallos en producción se corrigen por mensajes directos o chats cerrados, fuera del sistema de tickets. En los reportes la gráfica de incidentes luce impecable, la gerencia queda contenta y el equipo deja de aprender de sus caídas reales.
Tres reglas para un arranque barato y una métrica honesta
La objeción lógica salta rápido: si quitamos barreras, ¿no nos inundarán las falsas alarmas y cómo cumplimos con los reportes en fintech? No hace falta eliminar la burocracia para siempre; basta sacarla de los primeros cinco minutos y moverla a cuando el fallo esté confirmado y acotado. Esa misma idea aparece en el libro Google SRE: Managing Incidents: declara incidentes pronto y seguido, manteniendo ligera la coordinación.
Van der Horst resume el inicio ligero en tres reglas. Primera, un solo paso: un comando en el chat o un botón más una frase corta describiendo lo que ves. La severidad y las cifras de daño pueden esperar; si abrir un incidente toma más tiempo que explicar el problema, el proceso está sobrecargado. Segunda, desligar la alerta del postmortem obligatorio: la profundidad del análisis se decide tras apagar el fuego. Tercera, separar a quien detecta el fallo de quien lidera la respuesta. Una gráfica rara la puede ver alguien junior en su primera guardia, así que lo normal debería ser «avisar y pasar la posta».
Así solo queda una pregunta en mente: ¿puede que algo ande mal y me venga bien ayuda para comprobarlo? Si la respuesta es sí, pulsa el botón.
El ingeniero Callen Hebert puso el broche exacto al debate de aquel artículo el 30 de octubre de 2026. Señaló que la métrica habitual MTTR (tiempo desde la declaración formal hasta la reparación) no ve la demora más peligrosa: la brecha entre la primera sospecha registrada y el momento en que alguien más puede sumarse a ayudar. Para cerrar ese hueco basta dividir dos estados: «sospecha» (suspected) e «impacto confirmado» (confirmed impact). El primero permite llamar a colegas al instante sin inventar cifras de pérdidas en el primer mensaje, y el segundo activa los protocolos pesados justo cuando la falla queda demostrada.