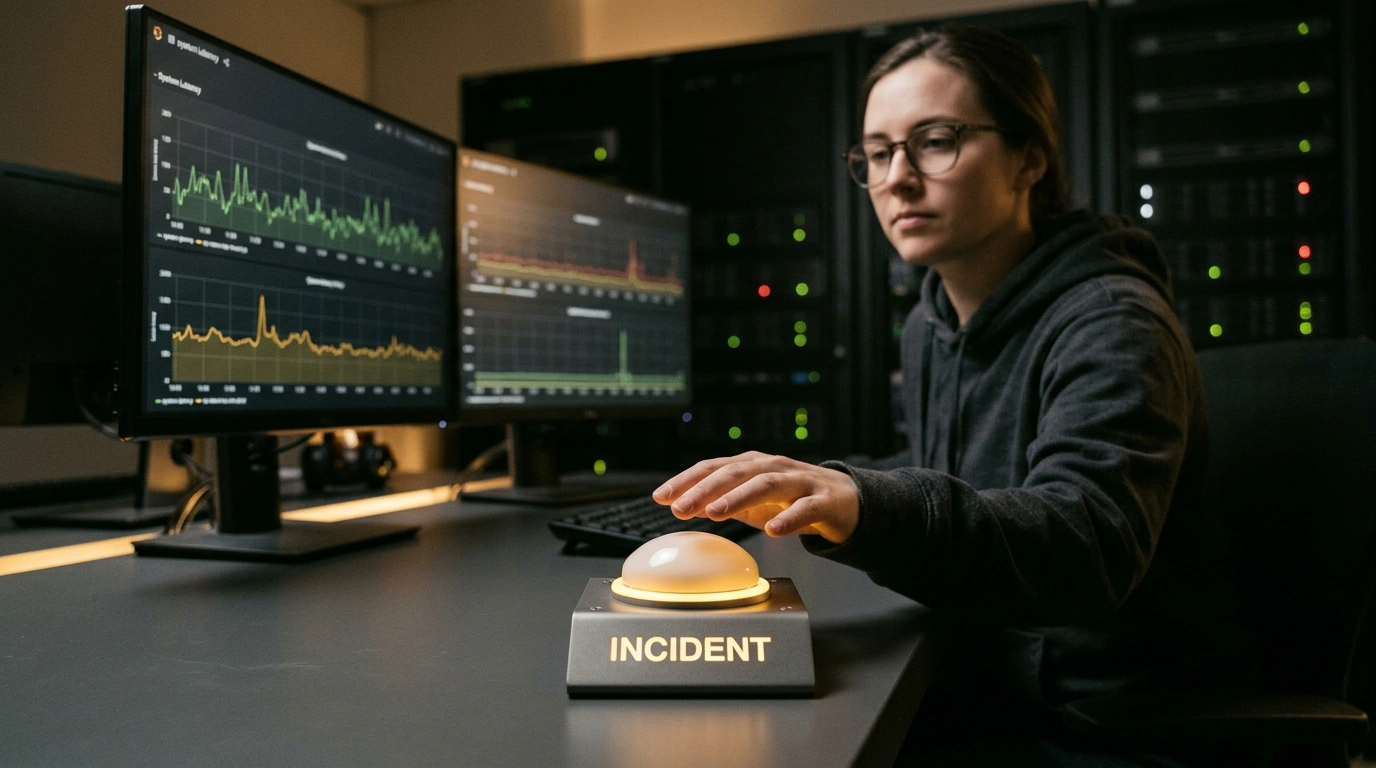
Сколько минут ты готов в одиночку ковырять странный график на дежурстве, прежде чем нажать кнопку «Объявить инцидент»?
Картинка знакомая. Идёт твоя смена на on-call — дежурстве, когда ты первым ловишь сюрпризы продакшена. Пару дней назад ты подправил дашборд и сейчас зашёл проверить, нормально ли он рисует метрики. Глаз цепляется за странный излом. Алерты молчат, сервис обычно железный, но если он прямо сейчас тихо чудит — рванёт по-крупному.
Сразу хочется ещё десять минут покопать логи самому: вдруг показалось, вдруг отпустит. Бывший SRE и инцидент-менеджер Adyen, а ныне основатель Recoverable Хьюго ван дер Хорст в эссе для рассылки The Postmortem (впервые оно вышло на Uptime Labs, а 30 октября 2026 года его перепечатали в рассылке) объясняет эту паузу просто. Дело не в лени. Дежурный слишком хорошо знает, во что ему обойдётся один клик.
Скрытый ценник одной кнопки
Все поля в форме инцидента придумали с благими намерениями. Выбери severity — уровень критичности сбоя, от которого зависит, кого будить и как срочно чинить. Укажи затронутые продукты и прикинь ущерб. Стань ведущим инцидента. Запланируй постмортем — письменный разбор причин аварии и плана профилактики — и согласуй задачи по итогам. В банках и других регулируемых отраслях сверху прилетают ещё и жёсткие сроки отчётности.
По отдельности каждый пункт кажется мелочью. Но когда всё сваливается на одного человека в первую минуту, цена кнопки «Инцидент» улетает в космос. В голове включается калькулятор: сейчас подниму кучу бюрократии, дёрну людей, а вдруг это ложная тревога? И неужели мне самому придётся вести разбор, если я ни разу этого не делал? Ван дер Хорст едко замечает, как легко команда доходит до абсурда: «А давайте ещё сразу прикинем потерю выручки, пока никто даже не подтвердил, что что-то сломалось».
Двойной счёт за молчание
Если график и правда предвещал сбой, каждая «тихая» минута бьёт по команде. Пока один инженер в одиночку листает логи, коллеги, способные помочь за пару минут, ничего не видят. Поддержка не знает, что отвечать клиентам в чате, а подключившиеся позже стартуют вслепую и с опозданием.
Но есть и вторая цена — коварнее. Когда объявлять инцидент дорого, люди находят обходной путь. Начинается shadow fixing — теневые починки: баги на проде правят в личке или закрытых чатиках, мимо трекера. На отчёте график инцидентов выглядит красиво, менеджмент доволен, а команда перестаёт учиться на реальных поломках.
Три правила дешёвого старта и одна честная метрика
Логичный встречный вопрос: а если убрать барьеры, нас не завалит ложными тревогами и как быть с отчётностью в том же финтехе? Бюрократию не нужно отменять насовсем — её достаточно вынести из первых пяти минут на этап, когда сбой подтверждён и локализован. Та же логика закреплена в книге Google SRE: Managing Incidents: объявляй инциденты рано и часто, держа координацию лёгкой.
Ван дер Хорст сводит лёгкий старт к трём правилам. Первое — один шаг: одна команда в чате или одна кнопка плюс короткая фраза о том, что ты видишь. Критичность и оценки ущерба подождут; если объявить инцидент дольше, чем описать проблему, процесс перегружен. Второе — отвязать тревогу от обязательного постмортема: глубину разбора выбирают уже после тушения пожара. Третье — развести роли того, кто заметил сбой, и того, кто ведёт реагирование. Увидеть странный график может и джун на первом дежурстве, поэтому нормой должно быть «объявил и передал».
Тогда в голове остаётся один вопрос: может быть, что-то не так, и мне пригодится помощь проверить? Если да — жми кнопку.
Точную точку в обсуждении статьи 30 октября 2026 года поставил инженер Callen Hebert. Он заметил, что привычная метрика MTTR (время от формального объявления инцидента до починки) не видит самую опасную задержку — разрыв между первым зафиксированным подозрением и моментом, когда к задаче может подключиться помощь. Чтобы убрать этот зазор, достаточно развести два статуса: «подозрение» (suspected) и «подтверждённый ущерб» (confirmed impact). Первый позволяет позвать коллег сразу, не выдумывая цифры потерь в первом сообщении, а второй запускает тяжёлые регламенты ровно тогда, когда поломка доказана.