Кластер из пяти серверов в трёх дата-центрах на схеме выглядит железобетонно. Кажется, запас огромный: отвалится машина или даже целый дата-центр — система выстоит. Из-за этого спокойствия команды часто не бьют тревогу, когда один из пяти узлов тихо уходит в офлайн. Мол, починим на неделе, четыре же живых. А потом гаснет свет в одной зоне, и сервис встаёт колом.
Что на самом деле сломалось у Revolut 20 октября
Именно так 20 октября 2026 года лёг Revolut. По официальному техническому обзору, около 06:00 UTC пропало питание в зоне доступности Zone B (europe-west2-b) лондонского Google Cloud — это отдельный дата-центр со своим питанием и сетью внутри региона. Авария у облака длилась 7 часов 52 минуты.
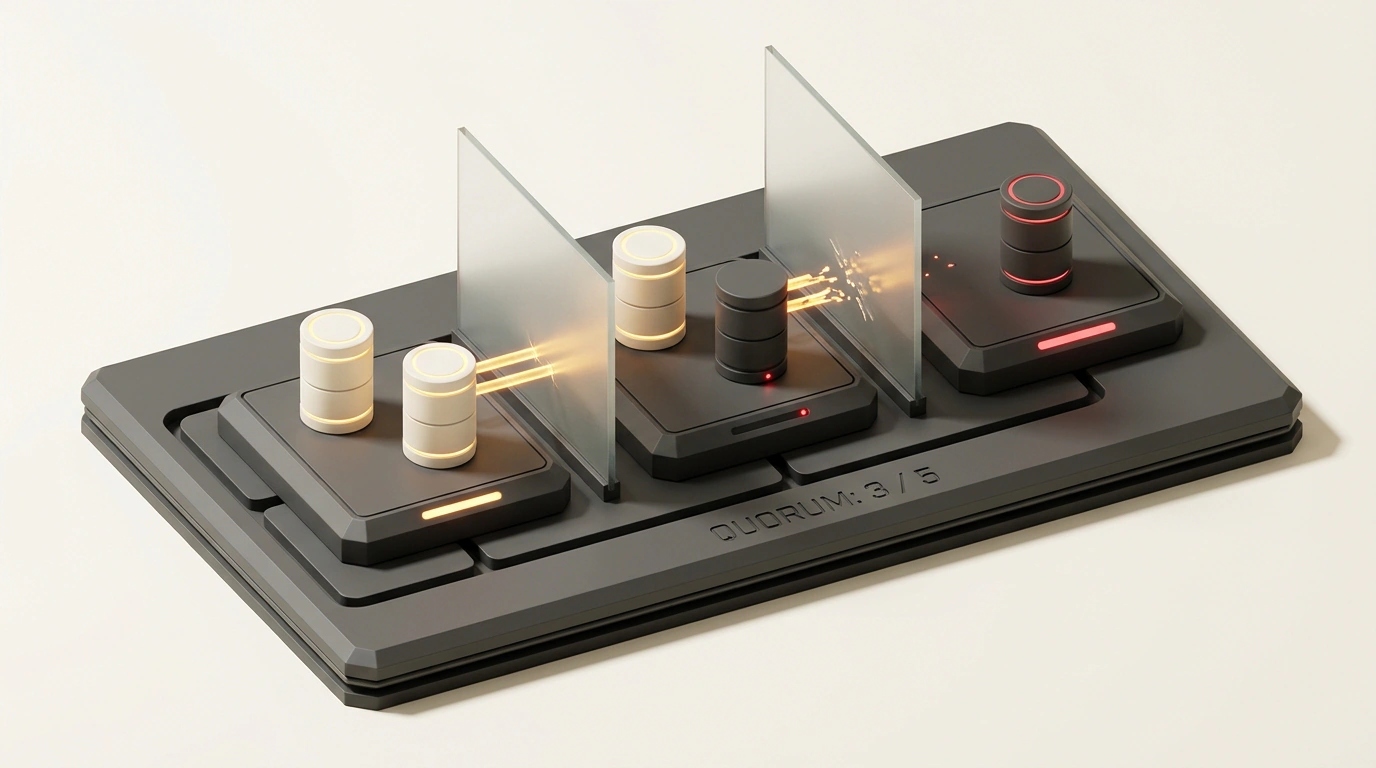
Затронутые базы Revolut опирались на группы из пяти серверов координации в трёх зонах (2/2/1). Для автоматического переключения (failover) им нужен кворум — строгое большинство, минимум три живых узла из пяти. Но в части групп один сервер уже лежал до аварии: из-за дыры в мониторинге или незавершённой замены тревога не сработала. Когда потухла Zone B, отвалились ещё два узла. Осталось двое из пяти, и автоматика встала.
Это не баг, а защита от split-brain («раздвоения мозга»). Если бы оставшаяся пара объявила себя главной, а отрезанная часть ожила со старым лидером, обе половины начали бы принимать конфликтующие платежи. Для банка это хуже простоя. Положение добила петля зависимостей: часть инструментов мониторинга и восстановления Revolut жила в той же Zone B, что затянуло ручную починку. Карты начали оживать к 12:40 UTC, а доступ в приложение массово вернулся к 15:45 UTC.
Revolut не назвал движок координации. Алексей Рыбак в канале System Design & Highload предположил, что под капотом стояла связка PostgreSQL + Patroni + пять узлов etcd, где etcd хранит решение о главном узле, а Patroni переключает базу. Сам он честно оговорился: это лишь educated guess, «свечку не держал». Но суть не в названии софта — точно так же сломается любой Raft-координатор вроде Consul или ClickHouse Keeper.
Математика кворума: почему 2/2/1 не прощает лишний отказ
Представь совет из пяти человек, где решение проходит только при большинстве голосов. Если двое сидят в одной переговорке и там вырубило свет, оставшиеся трое спокойно голосуют дальше. Но если один из тройки вчера ушёл на больничный и никто не заметил, после отключения света в зале остаётся двое. Голосовать нельзя: вдруг те трое за стеной живы и уже приняли другое решение.
В кластерах работает та же формула большинства ⌊N / 2⌋ + 1. В схеме 2/2/1 система переживает либо потерю одной зоны, либо выход из строя пары отдельных машин. Но если один сервер уже мёртв заранее, падение зоны с двумя узлами мгновенно выбивает кворум.
| Схема кластера | Кворум | Переживёт «зона + 1 узел»? | Цена по задержке и ресурсам |
|---|---|---|---|
3 узла (1/1/1) | 2 из 3 | Нет (остаётся 1 узел) | Минимальная задержка записи |
5 узлов (2/2/1) | 3 из 5 | Нет (остаётся 2 узла) | Средняя задержка, ложный запас |
5 узлов + арбитр в 4-м ДЦ (2/1/1/1) | 3 из 5 | Да (кроме зоны на 2 узла + ещё 1) | Почти как 2/2/1, дешёвая ВМ в 4-й зоне |
9 узлов (3/3/3) | 5 из 9 | Да (остаётся 5 узлов) | Выше задержка записи и нагрузка на сеть |
Всё упирается не в число серверов, а в то, сколько голосов уносит одна авария. Пока в одной зоне стоит сразу пара узлов, любой фоновый сбой соседа обнуляет страховку от падения дата-центра.
Как чинить такую раскладку на практике
Алексей Рыбак описал эту базу распределённых систем с фирменной иронией и передал «лучи поддержки тем, кто вынужден писать публичные пост-мортемы после такого»:
«Так сказать, бомж оторвался от своих пожитков, почесал репу и говорит: братела, на четвертом ДЦ ноду добавь, хоть на минимальной виртуалке, или засетапь 3/3/3 вместо 2/2/1, но задержки будут дольше».
Первое, что стоит поправить — алерты. В схеме 2/2/1 падение даже одного сервера должно сразу будить дежурного: запаса на отказ целой зоны больше нет.
Если нужен реальный запас по топологии, выбор из двух вариантов. Первый — поставить узел-арбитр (tie-breaker) в четвёртую зону: минимальную виртуалку без тяжёлых данных, которая просто участвует в голосовании (а в идеале разнести пять узлов по пяти зонам). Второй — перейти на 3/3/3, но платить за это придётся скоростью: каждой записи нужно дождаться подтверждения от большего числа узлов. Сама документация etcd не советует раздувать кластер до девяти машин под обычную нагрузку, ограничиваясь тремя или пятью. Ну и главное правило из опыта Revolut: мониторинг и инструменты восстановления нельзя держать в той же зоне, которую они должны спасать.