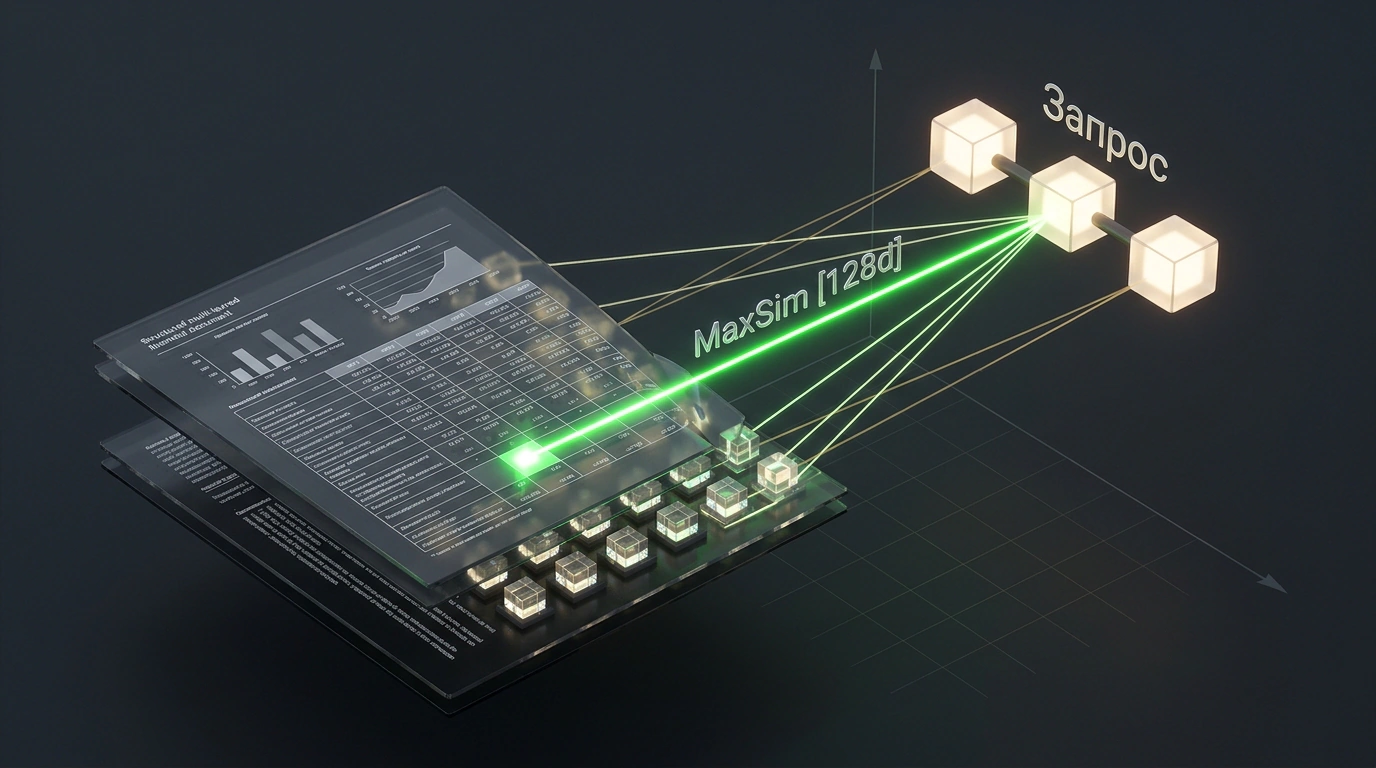

Построение корпоративного семантического поиска и RAG по сложным документам — финансовым отчетам, сканам, таблицам и презентациям — упиралось в узкое горлышко классических Bi-Encoder моделей. Стандартный энкодер сжимает страницу текста в единый вектор фиксированной размерности (768 или 1536 чисел), из-за чего точные цифры в ячейках таблиц и подписи к графикам неизбежно растворяются.
Компания Perplexity AI представила открытое семейство мультимодальных моделей pplx-embed-v2-late (в версиях 0.6B и 9B параметров) под лицензией MIT.
В основе новинки лежит архитектура позднего взаимодействия (Late Interaction), развивающая идеи метода ColBERT с поддержкой визуальных токенов. Мы уже следили за развитием экосистемы компании в обзоре Perplexity Computer, а теперь исследовательская команда открывает базовый поисковый фундамент сообществу.
Механика Late Interaction и оператор MaxSim
В отличие от стандартных моделей, pplx-embed-v2-late не сплющивает документ в одну точку латентного пространства. Модель сохраняет компактный 128-мерный вектор для каждого отдельного токена запроса и документа.
Релевантность вычисляется через оператор MaxSim:
- Для каждого токена запроса вычисляется косинусное сходство со всеми токенами документа.
- Фиксируется максимальное значение соответствия.
- Найденные максимумы суммируются по всем токенам запроса.
Такой подход сохраняет контекст деталей: если пользователя интересует конкретный финансовый показатель в сноске, модель найдет максимальное совпадение именно с этим токеном. Кроме того, страницы PDF можно подавать как изображения — модель выравнивает визуальные токены таблиц с текстом запроса без предварительного OCR.
Загрузка модели и вычисление MaxSim
Посмотрим, как инициализировать модель через Hugging Face Transformers и рассчитать релевантность на PyTorch:
import torch
import torch.nn.functional as F
from transformers import AutoTokenizer, AutoModel

model_id = "perplexity-ai/pplx-embed-v2-late-0.6b"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModel.from_pretrained(model_id, torch_dtype=torch.bfloat16).cuda().eval()

query = "Каковы операционные расходы за третий квартал?"
document = "В третьем квартале операционные расходы составили 14.2 миллиона долларов."

with torch.no_grad():
    q_inputs = tokenizer(query, return_tensors="pt").to("cuda")
    d_inputs = tokenizer(document, return_tensors="pt").to("cuda")

    # 128-мерные токенные эмбеддинги
    q_embeds = F.normalize(model(**q_inputs).last_hidden_state, p=2, dim=-1)
    d_embeds = F.normalize(model(**d_inputs).last_hidden_state, p=2, dim=-1)
Второй шаг — расчет оператора позднего взаимодействия MaxSim:
def calculate_maxsim(query_embeds: torch.Tensor, doc_embeds: torch.Tensor) -> float:
    # Матрица косинусных расстояний: [query_len, doc_len]
    sim_matrix = torch.matmul(query_embeds[0], doc_embeds[0].transpose(0, 1))

    # Максимальное совпадение для каждого токена запроса
    max_sim_per_token, _ = torch.max(sim_matrix, dim=-1)

    # Итоговый скор — сумма максимумов
    return torch.sum(max_sim_per_token).item()

score = calculate_maxsim(q_embeds, d_embeds)
print(f"MaxSim Score: {score:.4f}")
Благодаря нормализации векторов операция выполняется на GPU за доли миллисекунды, обеспечивая точность, сопоставимую с тяжелыми Cross-Encoder моделями.
Накладные расходы и вердикт
Плата за точность Late Interaction — размер индекса. Хранение векторов для каждого токена требует больше памяти, чем одиночные векторы. Однако сниженная размерность (128d вместо 1536d) и поддержка движков вроде Vespa, Qdrant и LanceDB с квантованием делают архитектуру жизнеспособной для продакшена.
Итог: открытый релиз pplx-embed-v2-late под лицензией MIT — важный шаг для RAG. Возможность искать по таблицам и сканам без потери деталей дает разработчикам мощный поисковый инструмент.