
Гонка кодинг-ассистентов долгое время шла по пути непрерывного наращивания весов: от моделей на 70 миллиардов параметров переходили к сотням миллиардов, вынуждая разработчиков либо оплачивать дорогостоящие облачные API, либо собирать домашние серверы с несколькими видеокартами. При этом встроенные в IDE модели автодополнения часто выдавали синтаксически правдоподобный, но неработающий код, требующий ручной доводки.
Компания JetBrains продемонстрировала иной подход, выпустив открытую кодинг-модель Mellum 2.1 (Mellum2.1-12B-A2.5B-Thinking) под свободной лицензией Apache 2.0.
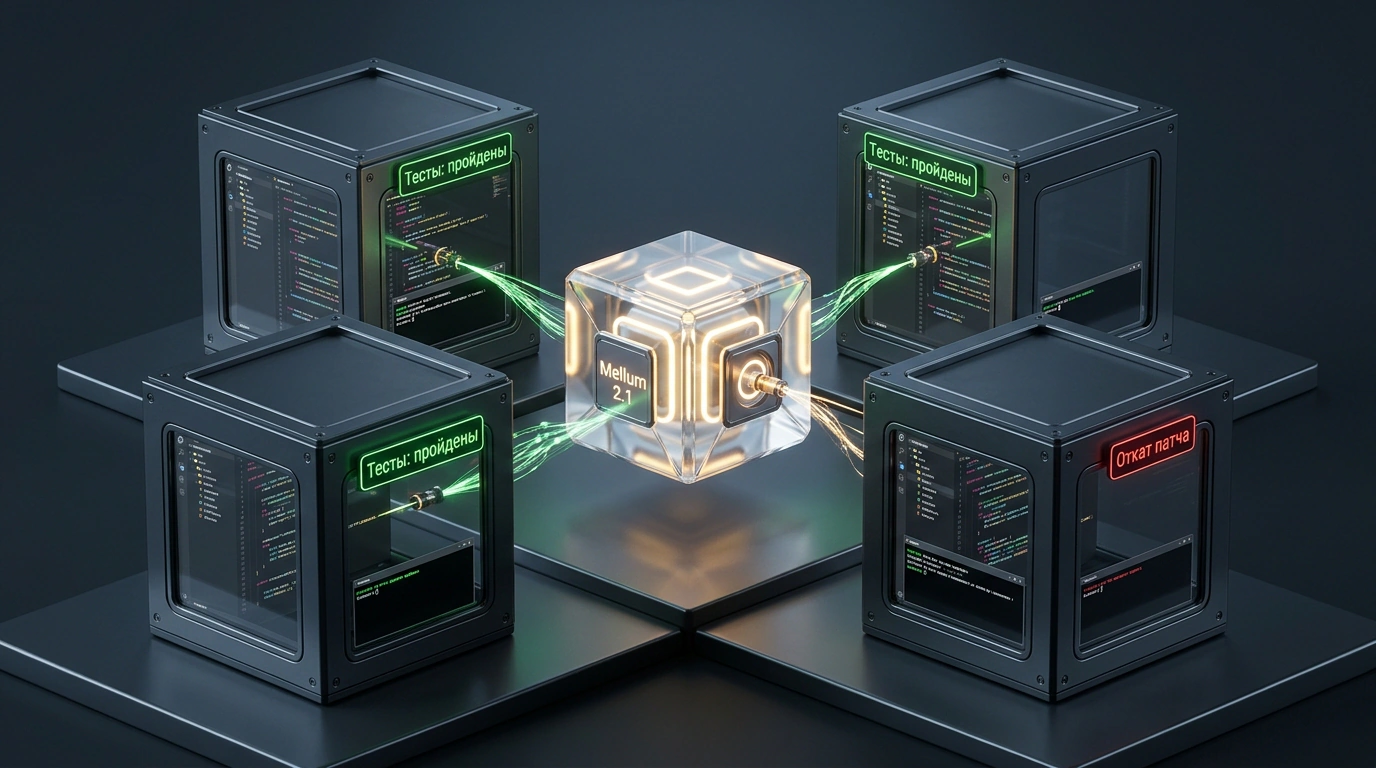
Архитектурно сеть построена на базе смеси экспертов (MoE) с общим объемом 12 миллиардов параметров, из которых на каждый токен активируются всего 2,5 миллиарда. Главная сенсация релиза заключается не в смене архитектуры, а в методике пост-тренировки: масштабном обучении с подкреплением (Reinforcement Learning) в миллионах изолированных песочниц.
Ранее мы сравнивали открытые инструменты в материале GLM 5.2 против Claude Code: свободные кодеры всё ближе подбираются к закрытым лидерам. Но Mellum 2.1 делает ставку на компактность и предельную скорость отклика внутри редактора.
Обучение на тестах: от угадывания токенов к работе в терминале
Классическое предварительное обучение учит нейросеть предсказывать следующее слово в коде. В результате модель отлично заучивает распространенные шаблоны, но теряется при возникновении ошибок компиляции или нестыковок типов данных.
При подготовке Mellum 2.1 инженеры JetBrains поместили модель в виртуальные изолированные среды с реальными репозиториями на Python, Kotlin, Java, Go и TypeScript. Модель взаимодействовала с проектами как живой программист:
- Считывала дерево файлов и конфигурации сборщиков (Gradle, Maven, npm).
- Вносила точечные изменения в исходный код через стандартные операции шелла.
- Запускала линтеры и тестовые наборы проектов.
- Получала награду исключительно по бинарному факту прохождения тестов (
pass/fail).
Если правка приводила к падению сборки, модель получала отрицательное подкрепление и была вынуждена анализировать диагностический вывод, формируя цепочки внутренних рассуждений (Thinking Process) перед внесением следующего патча.
Прорыв в бенчмарках и интеграция в IDE
Результаты практического обучения превзошли ожидания создателей. На индустриальном бенчмарке решения реальных задач разработки SWE-bench Verified показатель Mellum 2.1 взлетел с 2,0% (у предыдущего поколения Mellum 2) до впечатляющих 43,8%. При этом физический размер модели не изменился ни на байт — весь колоссальный прирост обеспечен эффективной адаптацией весов под решение инженерных задач.
Модель оптимизирована для бесшовного встраивания в среду разработки (IntelliJ IDEA, PyCharm, WebStorm, CLion):
- Низкая задержка первого токена: благодаря активации всего 2,5 млрд параметров инференс на локальном GPU или компактном сервере происходит почти мгновенно, не прерывая мыслительный процесс разработчика.
- Понимание контекста репозитория: модель ориентируется в графе символов проекта, точно подставляя внутренние классы и методы без галлюцинаций.
- Поддержка субагентов: легковесный формат позволяет запускать несколько экземпляров Mellum параллельно (например, один проверяет синтаксис, второй генерирует юнит-тесты).
Ограничения и инженерный вердикт
Несмотря на прорывные показатели, Mellum 2.1 проектировалась как специализированный инструмент для IDE, а не универсальный планировщик. Для масштабного проектирования архитектуры с нуля или глубокого логического рассуждения флагманские облачные модели по-прежнему незаменимы.
Однако для повседневной работы — рефакторинга методов, генерации тестов и локального поиска багов — Mellum 2.1 устанавливает новый отраслевой стандарт эффективности. Релиз JetBrains доказывает: будущее открытых кодинг-моделей лежит не в раздувании параметров, а в обучении действиям в реальной среде разработки.