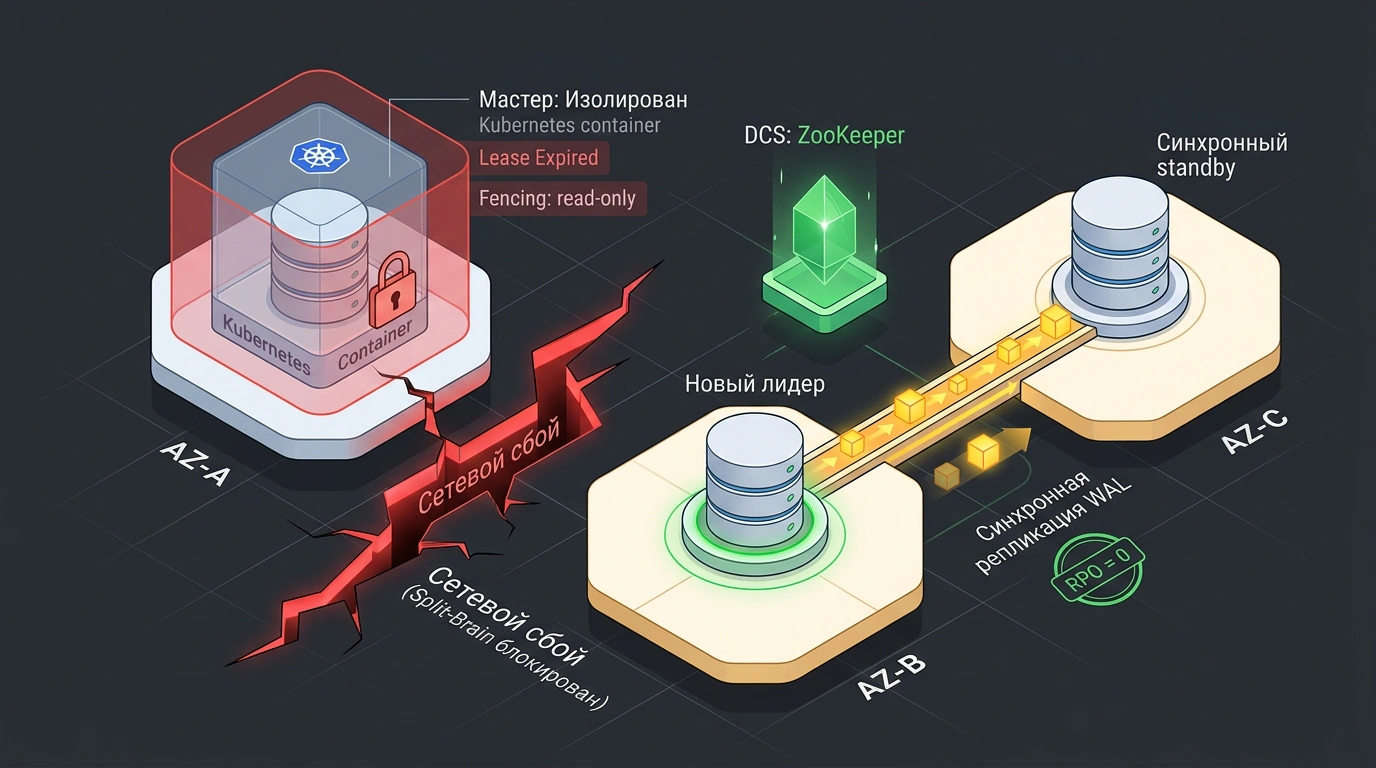

Развертывание реляционных баз данных в динамической среде Kubernetes давно перестало быть табу для индустрии. StatefulSet, CSI-драйверы для сетевых дисков и операторы высокой доступности сделали запуск PostgreSQL в контейнерах повседневной практикой. В типичной архитектуре инженеры разворачивают кластер с одним пишущим мастером (primary) и несколькими репликами, настраивают оператор Patroni и полагаются на автоматический failover: если мастер перестает отвечать на пробы жизнеспособности, система выбирает новую реплику и перенаправляет клиентский трафик.
В теории эта схема выглядит безупречно. Однако на практике, когда в реальной инфраструктуре публичного облака случается сетевая деградация между зонами доступности (Availability Zones), автоматика может превратить рядовой сбой в катастрофу с потерей подтвержденных транзакций и рассинхронизацией данных (split-brain). В масштабном исследовании инженеров Datadog детально разобрано, почему наивная конфигурация высокой доступности отказывает в самый неподходящий момент и как спроектировать кластер, гарантирующий нулевую потерю данных (RPO = 0).
Ловушка асинхронного failover при сетевой деградации
Классическая настройка PostgreSQL по умолчанию использует асинхронную потоковую репликацию (Streaming Replication). Когда клиент выполняет COMMIT, транзакция записывается в локальный журнал упреждающей записи (Write-Ahead Log, WAL) мастера и сбрасывается на диск, после чего клиент немедленно получает подтверждение успеха. Процесс wal_sender отправляет эти записи репликам в фоновом режиме.
Пока сеть стабильна, задержка репликации (replication lag) измеряется миллисекундами и десятками байт в показателях LSN (Log Sequence Number). Но что происходит во время зонных учений (Gamedays / Chaos Engineering) или реального сетевого шторма?
Инженеры смоделировали ситуацию, когда между двумя зонами доступности выросла задержка и часть пакетов стала теряться. Мастер продолжал быстро подтверждать транзакции локально, накапливая WAL, в то время как реплики начали стремительно отставать. В критический момент связь между зонами разорвалась полностью. Оркестратор высокой доступности Patroni попытался выполнить аварийное переключение, но натолкнулся на защитный предохранитель maximum_lag_on_failover (по умолчанию лимитирующий отставание реплики, например, порогом в 1 МБ).
Возник парадокс:
- Мастер изолирован сетевым разделением и не может обслуживать трафик;
- Все доступные реплики отстали от мастера больше допустимого порога;
- Patroni запрещает промоушен отстающей реплики, защищая кластер от отката данных;
- Кластер полностью зависает в режиме «мертвой петли» без пишущего узла, требуя ручного вмешательства дежурных инженеров посреди ночи.
Хуже того: если бы защитный порог был отключен, новая реплика стала бы мастером, потеряв последние транзакции. А когда сетевая связность восстановилась бы, старый мастер всё еще считал бы себя лидером. Запись одновременно в два независимых узла — это классический сценарий split-brain, распутать который без ручного анализа дампов и потери целостности базы данных невозможно. Подобные риски автоматического failover требуют пересмотра топологии на системном уровне.
Разделение ролей: Leader Pool против Read Replicas
Чтобы решить проблему рассинхронизации, инженеры Datadog пересмотрели структуру кластера, разделив узлы базы данных на два изолированных пула с принципиально разным назначением:
- Leader Pool (Пул отказоустойчивости): состоит ровно из трех экземпляров PostgreSQL — один активный пишущий лидер и два синхронных резервных узла (standby). Эти узлы разнесены по трем изолированным зонам доступности (Availability Zones) с помощью правил
podAntiAffinity. Их единственная задача — обеспечивать бесперебойную запись и мгновенный безопасный failover. Они не обслуживают пользовательские запросы на чтение. - Read Replica Pool (Пул горизонтального масштабирования): произвольное количество асинхронных реплик, подключенных к мастеру для выполнения тяжелых аналитических выборок, формирования отчетов и обслуживания read-only API. Эти узлы сознательно исключены из голосования за лидерство и никогда не участвуют в кворуме при переключении.
Такое разделение устраняет паразитное влияние клиентского чтения на скорость репликации в контуре высокой доступности.
Под капотом Patroni: DCS, аренда лидерства и ограждение (fencing)
Координация узлов в Kubernetes возложена на Patroni, который взаимодействует с распределенным хранилищем конфигураций (Distributed Configuration Store, DCS) — в данной архитектуре используется ZooKeeper (или etcd).
Лидерство в кластере оформляется через механизм аренды (lease) с помощью эфемерных узлов (ephemeral znodes) и счетчика сессий. Активный мастер обязан регулярно (каждые loop_wait секунд, обычно 10 с) продлевать блокировку лидера в DCS. Если мастер изолируется от сети, его аренда истекает через интервал ttl (обычно 30 с).
В этот момент вступают в силу критически важные механизмы:
- Автоматическое саморазжалование (Self-demotion / Fencing): как только локальный демон Patroni на мастере обнаруживает потерю связи с ZooKeeper дольше установленного таймаута, он немедленно переводит экземпляр PostgreSQL в безопасный режим
read-onlyили завершает процесс (SIGTERM/SIGQUIT), предотвращая локальную запись в изоляции. - Откат таймлайнов через
pg_rewind: когда изолированный старый мастер возвращается в сеть, его история транзакций (timeline) уже расходится с новым избранным лидером. Patroni автоматически запускает системную утилитуpg_rewind. Она сканирует заголовки страниц WAL с момента расхождения, возвращает измененные блоки данных к согласованной точке и переводит узел в режим потокового догона нового лидера без многочасового копирования терабайтных бэкапов черезpg_basebackup.
Уровни синхронного коммита: цена гарантии RPO = 0
Чтобы гарантировать, что в Leader Pool всегда есть узел с актуальными данными, кластер переводится на синхронную потоковую репликацию (synchronous_mode: true). Но здесь кроется ключевой инженерный компромисс между задержкой (latency), пропускной способностью (throughput) и надежностью (durability).
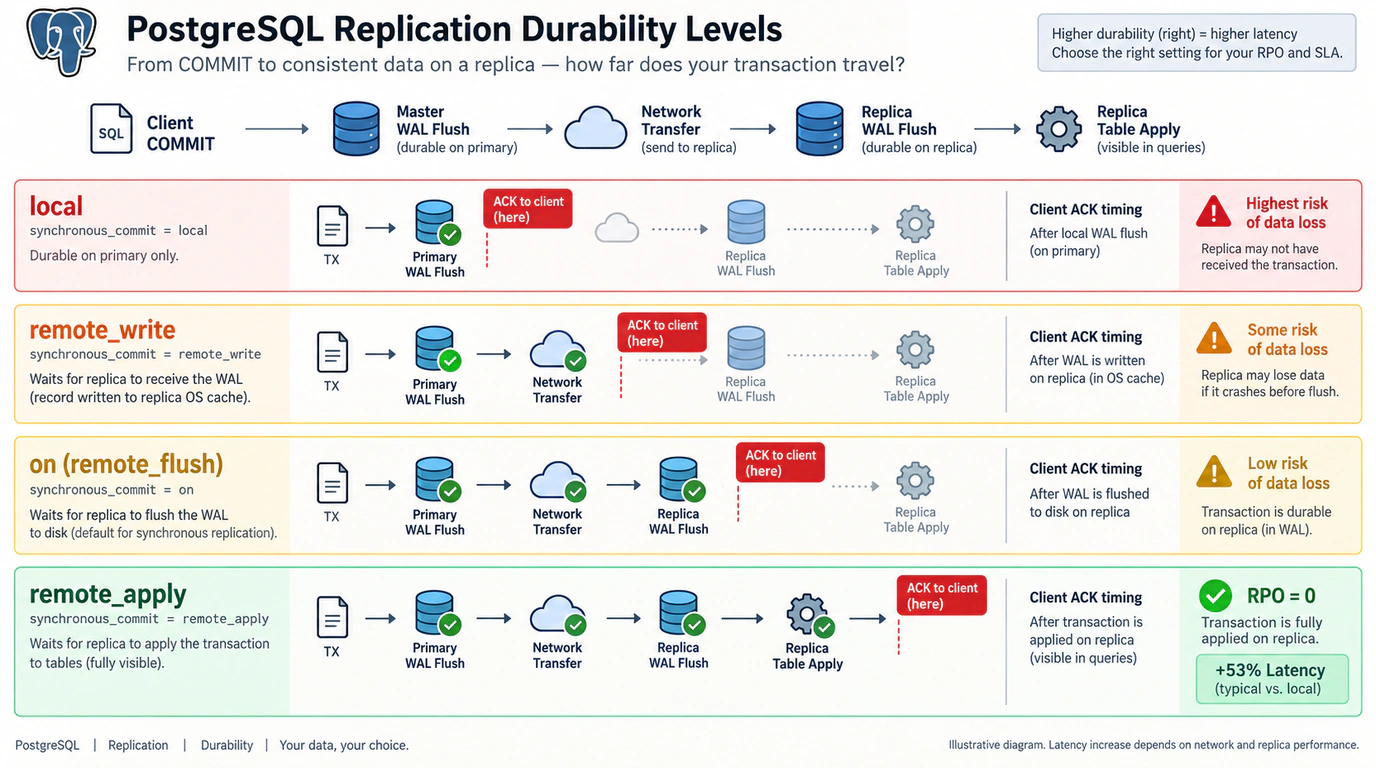
В PostgreSQL параметр synchronous_commit определяет, на каком именно этапе репликации мастер возвращает клиенту подтверждение транзакции:
local: подтверждение сразу после локального сброса WAL на диск мастера. Максимальная скорость, но возможна потеря данных при падении узла.remote_write: мастер ждет, пока реплика получит WAL по сети и запишет его в буферы операционной системы (без сброса на диск). Защищает от падения самого процесса PostgreSQL на реплике, но уязвимо к одновременному отключению питания хостов.on(илиremote_flush): мастер ждет, пока реплика физически сбросит полученный WAL на диск (fsync). Стандартная гарантия сохранности данных.remote_apply: максимальный уровень строгости. Мастер подтверждает коммит только после того, как реплика не просто сбросила WAL на диск, но и применила (replay) изменения в память и файлы таблиц. Это гарантирует, что данные становятся немедленно видимыми для чтения на реплике без малейшей задержки.
Инженеры провели серию нагрузочных испытаний с помощью утилиты pgbench (тест TPC-B, 100 000 транзакций) и зафиксировали реальные накладные расходы относительно базового уровня local:
Режим synchronous_commit | Рост средней задержки | Падение пропускной способности (TPS) |
|---|---|---|
remote_write | +38% | -27% |
on (remote_flush) | +46% | -31% |
remote_apply | +53% | -34% |
Рост задержки на 53% в синтетическом тесте выглядит пугающе. Однако при переносе в реальный продакшен выяснилось, что при сетевой задержке между зонами облака в пределах 1–2 миллисекунд абсолютный прирост времени отклика на прикладных эндпоинтах составил единицы миллисекунд. Для подавляющего большинства сервисов это совершенно незаметно, но взамен система получила фундаментальную гарантию: при аварии любого узла потеря данных исключена полностью.
Практический сценарий: настройка Patroni и оперативное управление
Рассмотрим боевую конфигурацию кластера Patroni для безопасного развертывания в Kubernetes. В первом листинге приведен манифест настроек кластера с активацией строгой синхронности:
scope: postgres-ha-cluster
namespace: /service/postgres

# Интеграция с распределенным консенсусом (ZooKeeper / etcd)
zookeeper:
  hosts: ['zk-0.zk-hs:2181', 'zk-1.zk-hs:2181', 'zk-2.zk-hs:2181']

# Параметры строгой синхронной репликации и кворумного failover
synchronous_mode: true
# В строгом режиме отказ реплик блокирует запись, исключая split-brain
synchronous_mode_strict: true
synchronous_node_count: 1
# Максимально допустимый лаг для промоушена реплики (1 МБ)
maximum_lag_on_failover: 1048576

postgresql:
  parameters:
    wal_level: replica
    hot_standby: "on"
    # Гарантия сохранности: коммит подтверждается после применения на реплике
    synchronous_commit: "remote_apply"
    max_wal_senders: 10
    max_replication_slots: 10
  pg_hba:
    - host replication replicator 0.0.0.0/0 md5
Параметр synchronous_mode_strict: true здесь играет решающую роль. Если обе резервные ноды внезапно станут недоступны, Patroni намеренно заблокирует операции записи на мастере, выставив * в synchronous_standby_names. Приложение получит ошибку таймаута транзакции, но не сможет записать данные, которые впоследствии окажутся утраченными.
Во втором листинге представлены команды для проверки топологии кластера, контроля синхронизации и динамического изменения параметров через интерфейс patronictl:
# 1. Проверка текущего лидера, реплик и состояния синхронности (Sync Standby)
patronictl -c /etc/patroni/patroni.yml list

# 2. Инспекция параметров кластера в распределенном хранилище DCS
patronictl -c /etc/patroni/patroni.yml show-config

# 3. Динамическое изменение конфигурации без перезапуска экземпляров СУБД
patronictl -c /etc/patroni/patroni.yml edit-config --set synchronous_mode=true

# 4. Проверка ожиданий синхронной репликации внутри PostgreSQL через psql
# SELECT pid, application_name, client_addr, sync_state, sync_priority FROM pg_stat_replication;
Архитектурный чек-лист для production-кластеров
При построении High Availability для PostgreSQL в Kubernetes соблюдайте следующие базовые правила:
- Разносите узлы физически: используйте строгие правила
topologySpreadConstraintsилиpodAntiAffinityпо зонам (topology.kubernetes.io/zone), чтобы мастер и синхронная реплика гарантированно находились в разных дата-центрах; - Изолируйте DCS: кластер etcd или ZooKeeper должен содержать не менее трех узлов и располагаться вне тех же самых воркеров, где крутятся поды базы данных;
- Настройте мониторинг ожидания
SyncRep: отслеживайте события ожидания синхронной репликации вpg_stat_activity— рост задержек на этом событии сигнализирует о деградации межзональной сети задолго до реальной аварии; - Регулярно проводите учения: тестируйте сценарии аварийного отключения питания узлов и разрыва сетевых каналов на боевых объемах данных.
Отказоустойчивость в распределенных системах — это всегда осознанный компромисс. Пожертвовав третью пропускной способности на записи ради синхронного применения транзакций, вы получаете предсказуемую, надежную систему, готовую к любым штормам облачной инфраструктуры.