Когда ты пишешь обычный цикл for и складываешь два среза []float32, кажется, что процессор трудится на полную. Внутри картина грустнее. Ядро берёт по одной паре чисел, прогоняет через обычный регистр и пишет сумму в память — шаг за шагом. Это скалярный цикл. А рядом простаивают широкие векторные регистры, способные сложить восемь чисел за одну команду. В Go 1.27 к ним можно дотянуться из обычного Go-кода — без ассемблера.
Как один широкий регистр обгоняет обычный цикл
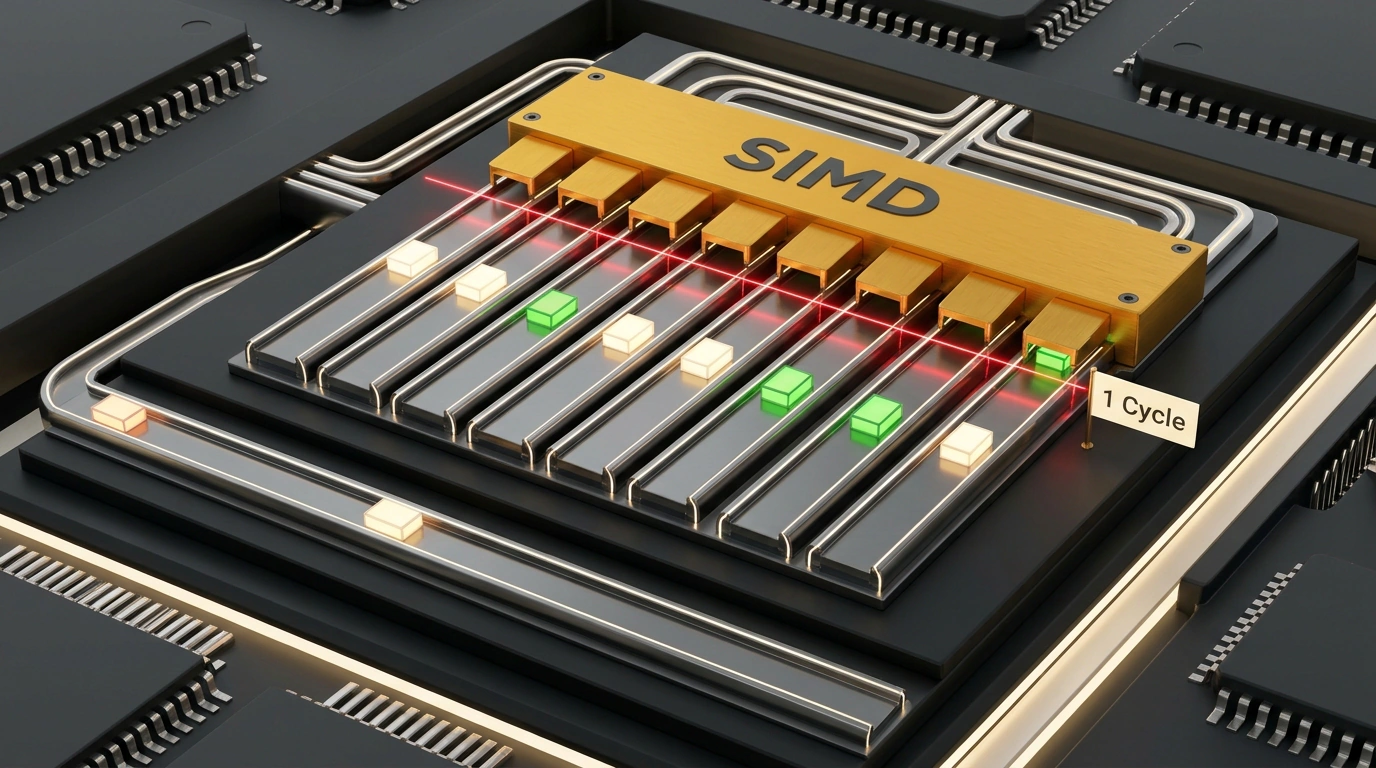
SIMD (Single Instruction, Multiple Data) — это одна команда сразу на пачку данных. Представь кассу в магазине, где вместо одной ленты работают восемь дорожек, а кассир жмёт одну кнопку — и все восемь товаров пробиваются разом. В процессоре эту роль играет векторный регистр на 128, 256 или 512 бит (AVX2 на amd64, Neon на arm64). Внутри он разбит на слоты — lanes: в 256 бит влезает восемь float32, четыре float64 или тридцать два int8.
Вся работа сводится к трём шагам: загрузить порцию среза в регистр (Load), выполнить операцию по всем слотам (Operate) и выгрузить результат в память (Store). Главное правило: все слоты выполняют одну и ту же команду, поэтому ветвления if приходится заменять битовыми масками.
От ассемблера к пакетам simd и simd/archsimd
Компилятор Go почти не векторизует циклы сам, так что раньше ради SIMD приходилось писать Go Assembly под каждую архитектуру. В Go 1.26 под флагом GOEXPERIMENT=simd появился низкоуровневый пакет simd/archsimd (Float32x8 для amd64). В Go 1.27 туда добавили 128-битный Neon для arm64 и SIMD для wasm, а поверх положили переносимый пакет simd (simd.Float32s, simd.Int8s). Компилятор сам подбирает ширину под железо, а без аппаратной поддержки откатывается на обычные вычисления.
В разборе SIMD в Go Хесус Эспино сравнил обычный цикл с новым пакетом на сложении двух []float32:
//go:build goexperiment.simd

import "simd"

// Скалярный цикл: по одной паре за шаг
func addScalar(a, b, out []float32) {
    for i := 0; i < len(a); i++ {
        out[i] = a[i] + b[i]
    }
}

// Переносимый SIMD (Go 1.27+): ширина под CPU
func addPortable(a, b, out []float32) {
    var v simd.Float32s
    n := v.Len() // 4, 8 или 16 элементов
    i := 0
    for ; i+n <= len(a); i += n {
        x := simd.LoadFloat32s(a[i:])
        y := simd.LoadFloat32s(b[i:])
        x.Add(y).Store(out[i:])
    }
    // Хвост считаем обычным циклом
    for ; i < len(a); i++ {
        out[i] = a[i] + b[i]
    }
}
Никаких страшных C-интринсиков: метод Add — встроенный интринсик, который компилятор заменяет прямой машинной инструкцией. Если нужно выжать максимум из конкретного CPU, берут simd/archsimd. В том же разборе Эспино посчитал скалярное произведение (dot product) на Go 1.27.0 через Float32x8 и MulAdd (FMA — умножение со сложением) и получил ускорение примерно в 9 раз:
//go:build goexperiment.simd

import "simd/archsimd"

func dotSIMD(a, b []float32) float32 {
    // Без проверки код упадёт с SIGILL на старом CPU
    if !archsimd.X86.AVX2() || !archsimd.X86.FMA() {
        return dotScalar(a, b)
    }
    var acc archsimd.Float32x8
    i := 0
    for ; i+8 <= len(a); i += 8 {
        x := archsimd.LoadFloat32x8(a[i:])
        y := archsimd.LoadFloat32x8(b[i:])
        // acc = x*y + acc по всем восьми слотам
        acc = x.MulAdd(y, acc)
    }
    // Хвост < 8 элементов: пустые слоты добьются нулями
    x, _ := archsimd.LoadFloat32x8Part(a[i:])
    y, _ := archsimd.LoadFloat32x8Part(b[i:])
    acc = x.MulAdd(y, acc)

    // Сворачиваем 8 сумм в одно число
    s := acc.GetLo().Add(acc.GetHi())
    s = s.ConcatAddPairs(s)
    s = s.ConcatAddPairs(s)
    return s.GetElem(0)
}
Запускается такой код командой GOEXPERIMENT=simd go run .. Хвост грузится через LoadFloat32x8Part — пустые слоты добиваются нулями и не портят сумму. А проверка archsimd.X86.AVX2() и archsimd.X86.FMA() с откатом на обычный цикл обязательна: иначе бинарник упадёт с SIGILL на процессоре без этих инструкций.
Когда SIMD реально ускоряет, а когда только мешает
Девятикратный прирост манит, но переписывать всё подряд бессмысленно. SIMD отлично работает там, где тысячи однотипных чисел проходят через простую формулу без ветвлений: картинки, звук, сжатие, криптография, поиск по байтам, векторный поиск и подготовка данных для ML.
На коротких срезах, при частых if/else или в задачах, упирающихся в скорость памяти, накладные расходы легко съедят весь выигрыш. Плюс API под GOEXPERIMENT=simd пока экспериментальный и не защищён гарантией совместимости Go 1 — имена методов ещё могут поменяться. Для обычного бэкенда проще начать с PGO, а векторный код держать за //go:build goexperiment.simd только в тех горячих циклах, куда ткнул профилировщик.