Cuando escribes un bucle for normal para sumar dos slices []float32, parece que el procesador trabaja a toda máquina. Por dentro la escena es más lenta: el núcleo toma un par de números cada vez, los pasa por un registro normal y escribe la suma en memoria paso a paso. Es un bucle escalar. Mientras tanto, al lado están sin uso los anchos registros vectoriales, capaces de sumar ocho números con una sola instrucción. En Go 1.27 ya puedes usarlos desde código Go normal, sin escribir ensamblador.
Cómo un registro ancho adelanta al bucle habitual
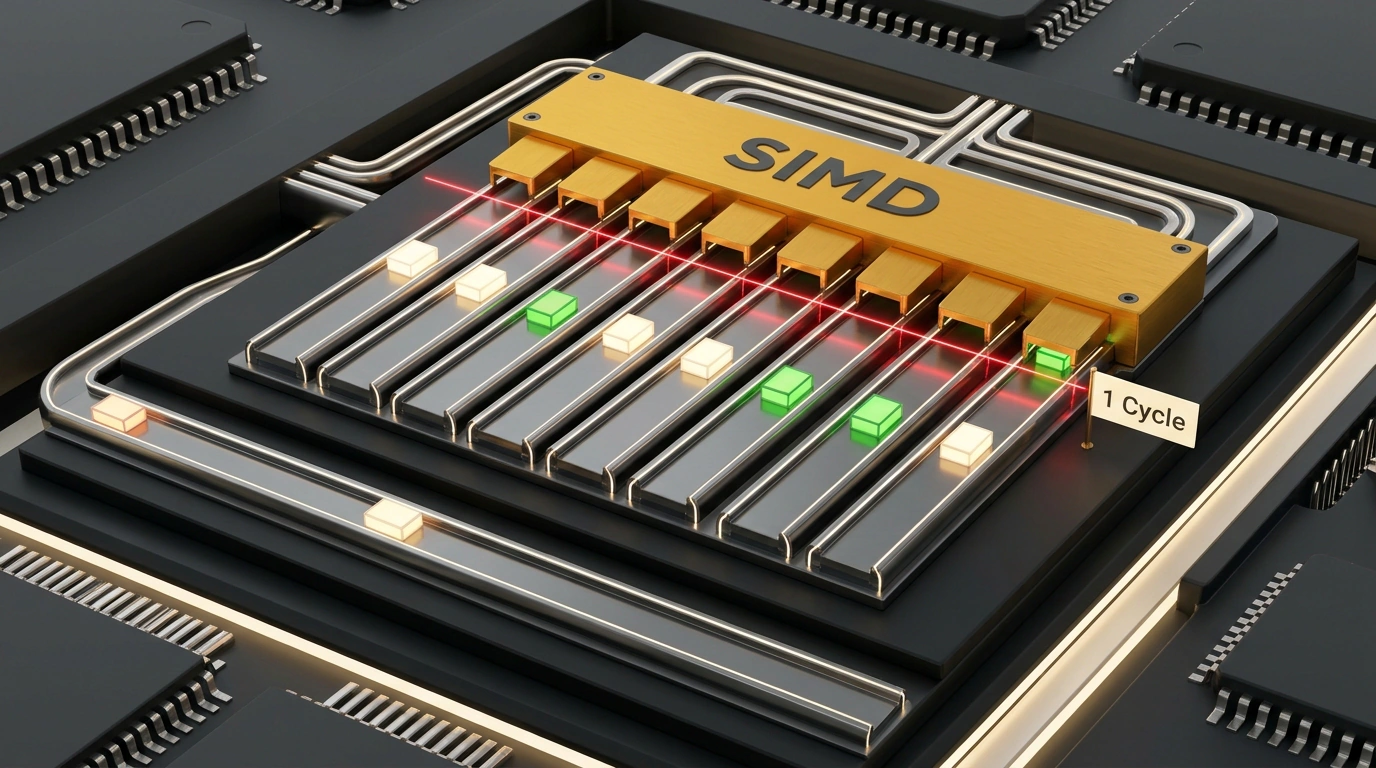
SIMD (Single Instruction, Multiple Data) aplica una sola instrucción a un lote de datos a la vez. Imagina una caja de supermercado donde en lugar de una cinta corren ocho carriles en paralelo, el cajero pulsa un botón y los ocho artículos se registran juntos. En la CPU ese papel lo cumple un registro vectorial de 128, 256 o 512 bits (AVX2 en amd64, Neon en arm64). Por dentro se divide en ranuras (lanes): en 256 bits caben ocho float32, cuatro float64 o treinta y dos int8.
Todo el trabajo se resume en tres pasos: cargar una porción del slice en el registro (Load), ejecutar la operación en todas las ranuras (Operate) y guardar el resultado en memoria (Store). La regla clave: todas las ranuras ejecutan la misma instrucción, por lo que las ramas if se sustituyen con máscaras de bits.
Del ensamblador a los paquetes simd y simd/archsimd
El compilador de Go casi no vectoriza bucles por su cuenta, así que antes para usar SIMD había que escribir Go Assembly para cada arquitectura. En Go 1.26, bajo el flag GOEXPERIMENT=simd, apareció el paquete de bajo nivel simd/archsimd (Float32x8 para amd64). En Go 1.27 añadieron Neon de 128 bits para arm64 y SIMD para wasm, y encima colocaron el paquete portable simd (simd.Float32s, simd.Int8s). El compilador elige el ancho según el hardware y, si no hay soporte, vuelve a cálculos normales.
En su análisis de SIMD en Go, Jesús Espino comparó un bucle normal con el nuevo paquete sumando dos []float32:
//go:build goexperiment.simd

import "simd"

// Bucle escalar: un par de elementos por paso
func addScalar(a, b, out []float32) {
    for i := 0; i < len(a); i++ {
        out[i] = a[i] + b[i]
    }
}

// SIMD portable (Go 1.27+): el ancho se adapta a la CPU
func addPortable(a, b, out []float32) {
    var v simd.Float32s
    n := v.Len() // 4, 8 o 16 elementos
    i := 0
    for ; i+n <= len(a); i += n {
        x := simd.LoadFloat32s(a[i:])
        y := simd.LoadFloat32s(b[i:])
        x.Add(y).Store(out[i:])
    }
    // El resto final se calcula con un bucle normal
    for ; i < len(a); i++ {
        out[i] = a[i] + b[i]
    }
}
Nada de intrínsecos feos de C: el método Add es un intrínseco integrado que el compilador traduce a una instrucción directa de máquina. Si necesitas exprimir al máximo una CPU concreta, se usa simd/archsimd. En el mismo artículo, Espino calculó el producto escalar (dot product) en Go 1.27.0 con Float32x8 y MulAdd (FMA, multiplicación y suma combinadas) y logró una aceleración cercana a 9×:
//go:build goexperiment.simd

import "simd/archsimd"

func dotSIMD(a, b []float32) float32 {
    // Sin comprobar, el código fallará con SIGILL en CPUs antiguas
    if !archsimd.X86.AVX2() || !archsimd.X86.FMA() {
        return dotScalar(a, b)
    }
    var acc archsimd.Float32x8
    i := 0
    for ; i+8 <= len(a); i += 8 {
        x := archsimd.LoadFloat32x8(a[i:])
        y := archsimd.LoadFloat32x8(b[i:])
        // acc = x*y + acc en las ocho ranuras a la vez
        acc = x.MulAdd(y, acc)
    }
    // Cola < 8 elementos: las ranuras vacías se rellenan con ceros
    x, _ := archsimd.LoadFloat32x8Part(a[i:])
    y, _ := archsimd.LoadFloat32x8Part(b[i:])
    acc = x.MulAdd(y, acc)

    // Reducimos las 8 sumas parciales a un solo número
    s := acc.GetLo().Add(acc.GetHi())
    s = s.ConcatAddPairs(s)
    s = s.ConcatAddPairs(s)
    return s.GetElem(0)
}
Este código se ejecuta con GOEXPERIMENT=simd go run .. La cola final se carga con LoadFloat32x8Part: las ranuras sobrantes se rellenan con ceros para no alterar la suma. Y comprobar archsimd.X86.AVX2() y archsimd.X86.FMA() con respaldo escalar es obligatorio, o el binario morirá con SIGILL en procesadores sin esas instrucciones.
Cuándo acelera de verdad SIMD y cuándo solo estorba
Un salto de 9× tienta, pero reescribir todo sin criterio no tiene sentido. SIMD brilla donde miles de números homogéneos pasan por una fórmula sencilla sin ramificaciones: imágenes, audio, compresión, criptografía, búsqueda por bytes, búsqueda vectorial y preparación de datos para ML.
En slices cortos, con muchos if/else o en tareas limitadas por el ancho de banda de memoria, el costo extra se come toda la ganancia. Además, la API bajo GOEXPERIMENT=simd sigue siendo experimental y no está cubierta por la garantía de compatibilidad de Go 1, así que los nombres de métodos aún pueden cambiar. Para un backend normal conviene empezar con PGO y aislar código vectorial tras //go:build goexperiment.simd solo en los bucles calientes que señale el perfilador.