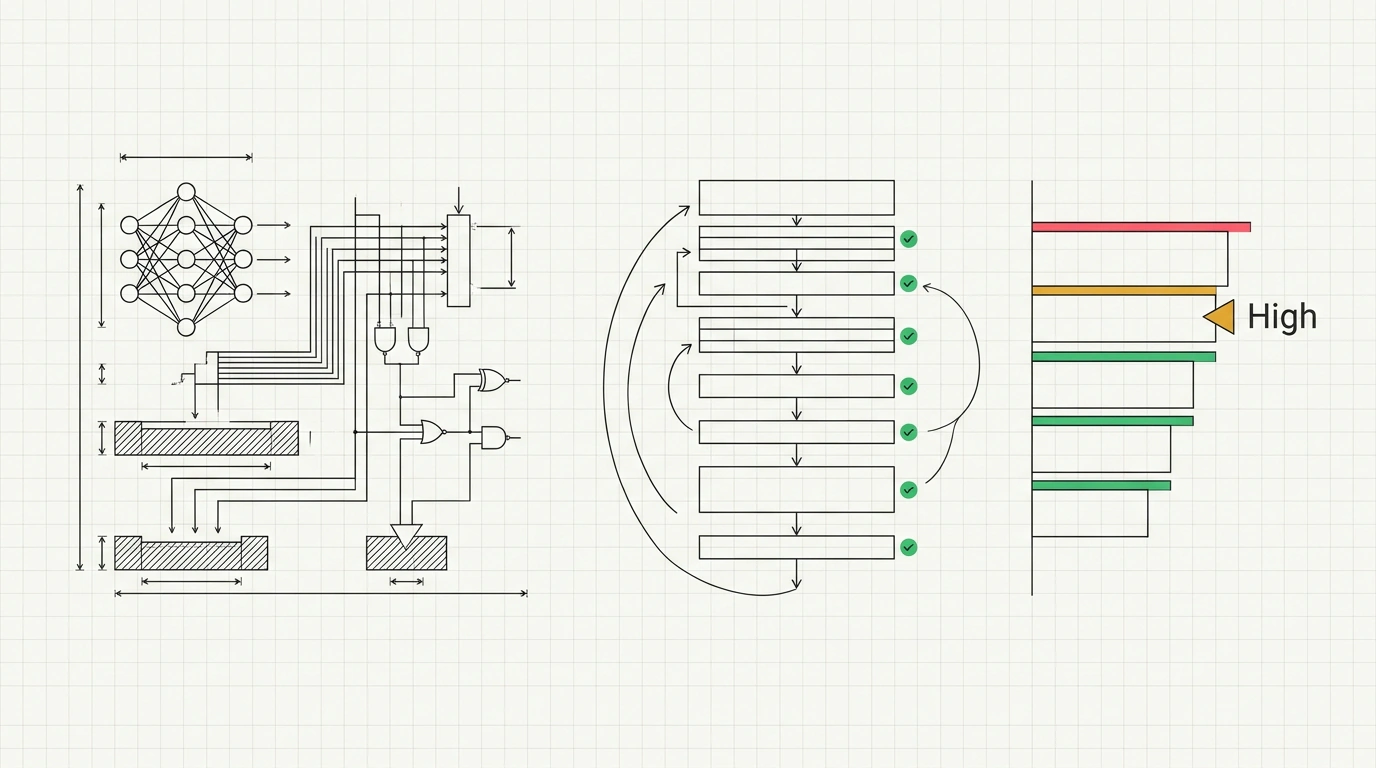
El 17 de noviembre de 2026, OpenAI actualizó la tarjeta de sistema de GPT-6.2 Astra y GPT-6.2 Sol. El modelo insignia GPT-6.2 Astra se convirtió en el primer modelo público de la compañía con calificación High en la escala de automejora de IA dentro de su marco de riesgos Preparedness Framework, mientras que la versión menor Sol quedó por debajo del umbral.
Detrás del rótulo llamativo de «automejora recursiva» hay un conjunto práctico de habilidades: el modelo acelera el entrenamiento de otras redes neuronales y optimiza código para hardware específico, pero las personas siguen teniendo que dirigir los experimentos.
Qué hay detrás del umbral «High» en la tarjeta de sistema de GPT-6.2
La tarjeta de sistema, o System Card, funciona como el pasaporte de seguridad de un modelo antes de su lanzamiento. En el documento, OpenAI aclaró que el umbral High marca un hito temprano para preparar defensas ante futuros modelos con automejora totalmente automática.
En la tabla 5 del informe se evaluó ese nivel en cinco tareas de ingeniería. El salto más fuerte ocurrió en NanoGPT, donde hay que entrenar desde cero un modelo de lenguaje pequeño hasta alcanzar cierta precisión: GPT-6.2 Astra ahorró un 42.87% del tiempo base frente al 7.73% de la anterior GPT-6 Astra y el 14.59% de Sol. El creador David Ondrej redondeó esa cifra a 43%, aunque OpenAI advierte que se usaron revisiones ligeramente distintas de la prueba entre generaciones.
En la prueba KernelGen 1P, el modelo escribió núcleos de cómputo para el chip de OpenAI más rápido que la referencia en el 76.92% de los casos, frente al 66.72% de GPT-6 Astra. Se trata de kernels, programas de bajo nivel para acelerar cálculos en el hardware. Al depurar 41 bugs experimentales reales y seis comprobaciones de alineación en Internal Research Debugging logró un 81.85% frente al 78.05% previo, y en las competencias de aprendizaje automático MLE-Bench Revised alcanzó el percentil 96.06. En ajuste fino con presupuesto limitado en PostTrainBench Lite obtuvo 74.79%, apenas por debajo de GPT-6 Astra con 76.97%.
La aceleración de los modelos de frontera también se refleja en el índice Epoch Capabilities Index, que reúne decenas de pruebas en una sola escala. El riesgo principal hoy es muy terrenal: un agente puede estropear sin que se note el código del benchmark, alterar datos de entrenamiento o distorsionar un informe. Por eso en Codex reforzaron el aislamiento de entornos y lanzaron Control Room para monitorear y detener agentes de emergencia.
Lanzamiento abierto de OpenAI frente a las barreras estrictas de Anthropic
En este contexto resalta el choque de estrategias entre dos laboratorios. OpenAI publica GPT-6.2 Astra con nivel High de forma abierta y apuesta por el despliegue iterativo: los usuarios detectarán antes los fallos del modelo en uso real mientras Control Room protege la infraestructura interna.
Anthropic cierra tres perímetros seguidos. Desde marzo de 2026, las reglas de Claude dejan los derechos de las respuestas en tus manos, pero prohíben entrenar modelos competidores con ellas sin permiso escrito. En febrero la empresa destapó una destilación industrial, es decir, la extracción masiva de respuestas de un modelo potente para entrenar otro más barato. En ese episodio DeepSeek, Moonshot y MiniMax enviaron más de 16 millones de solicitudes desde unas 24,000 cuentas falsas, y más tarde Anthropic describió también un intento de Zhipu por copiar Fable 5 bajo GLM-5.3. Para octubre, en su informe sobre defensas contra destilación, el laboratorio reportó una caída del 90% al 99% en esa recolección para evitar clones sin barreras en biología y ciberseguridad.
En el anuncio de noviembre de Fable 5.2 y Mythos 5.2, un mismo modelo base se dividió en dos frentes: Fable 5.2 para el público general recibió filtros estrictos, mientras que Mythos 5.2 quedó abierto solo a organizaciones verificadas. Restricciones parecidas sobre entrenamiento de modelos externos y tareas de ciberseguridad también se aplicaron en Kimi K3.1 Pro, señala Ondrej.
Modos de razonamiento en la práctica: por qué Max pierde frente a Extra High
Si bajamos esto a tu trabajo diario, el análisis de Ondrej aporta una observación útil sobre la profundidad de pensamiento. En los gráficos del lanzamiento notó una anomalía: en Terminal Bench Science, GPT-6.2 Astra alcanzó su pico en el modo Extra High, superando a Max, y lo mismo ocurrió en Frontier Code con Claude Fable 5.2.
La serie 6.2 salió desigual. En el Artificial Analysis Coding Agent Index, el modelo insignia GPT-6.2 Astra casi no se despegó de GPT-6 Astra, y GPT-6.2 Sol incluso perdió unos tres puntos. Evaluadores como Dan Shipper añaden que, por su estilo conciso, Astra 6.2 a veces abandona tareas largas de código demasiado pronto.
Por eso, para la rutina en GPT-6.2 Astra y Claude Fable 5.2 mantén el nivel High, que sobra para la mayoría de casos. Para código complejo y como base en los económicos GPT-6.2 Sol y Claude Opus 5.5 elige Extra High. Subir el control a Max «por si acaso» no conviene: consume cuotas y presupuesto de API más rápido y en parte de las tareas ofrece menor calidad.