«En el informe dice backup — success. ¿Qué revisas después?» Con esa pregunta, analizada en el canal DevOps by REBRAIN, suelen empezar muchas entrevistas para DevOps, sysadmin o DBA. El estado en verde demuestra una sola cosa: el script salió con código 0. Pero no dice absolutamente nada sobre si tu servicio volverá a la vida tras un fallo.
Por qué un estado en verde y una base arrancada no demuestran nada
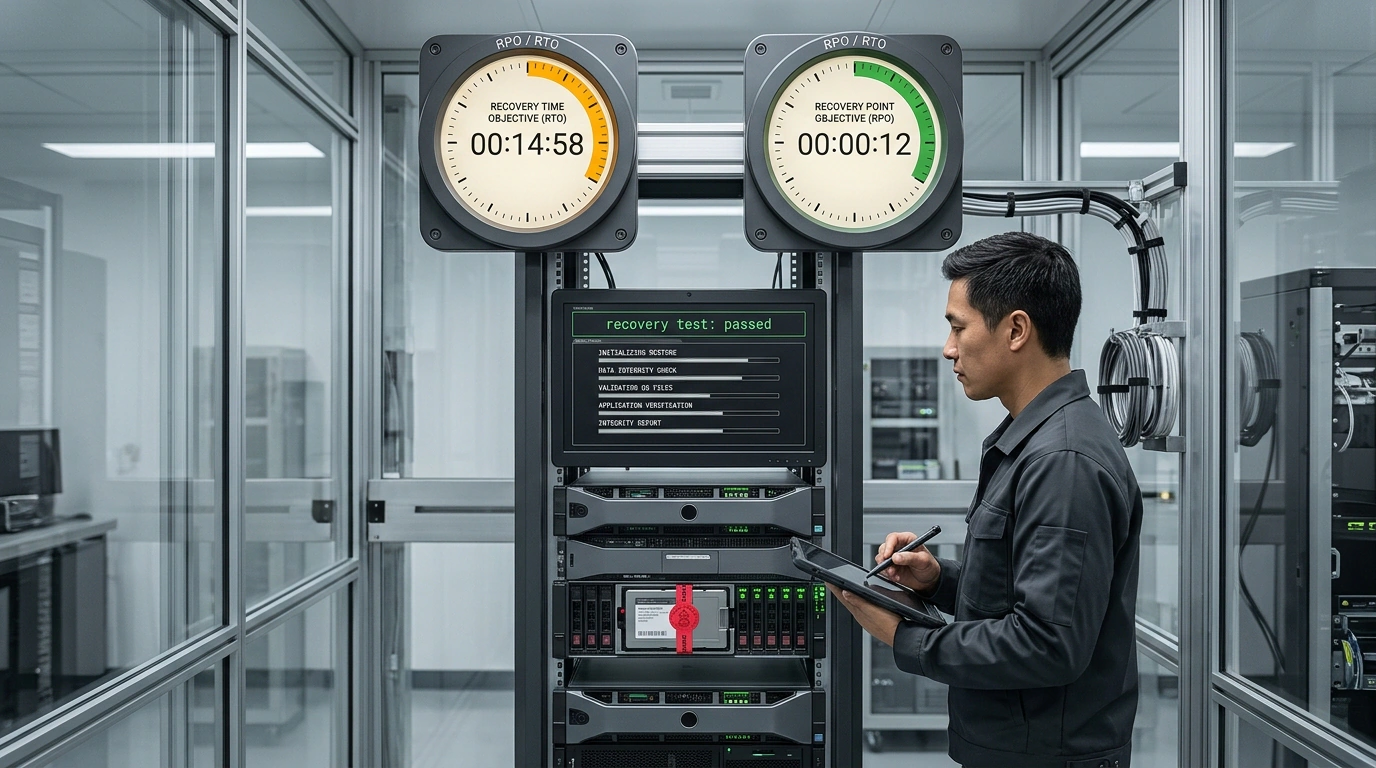
Incluso si la base arranca sin quejas desde la copia, aún es pronto para celebrar. Primero fijamos los criterios de éxito. El estándar NIST SP 800-34 define dos métricas para esto: RPO (Recovery Point Objective) y RTO (Recovery Time Objective). En palabras simples: el RPO indica cuántos minutos de datos está dispuesto a perder el negocio en un fallo, y el RTO cuánto tiempo puede estar caído el servicio mientras lo recuperas.
Después concretamos el escenario: fallo de disco, pérdida del servidor o un DELETE accidental sin WHERE. En ese último caso no basta el volcado nocturno: hace falta PITR (Point-in-Time Recovery), es decir, volver justo al minuto previo a la consulta errónea.
Con los criterios claros, revisa el paquete completo. Una carpeta con el archivo no sirve si las claves de descifrado están en un almacén inaccesible o se fueron con un excompañero. Necesitas la copia, las claves, los archivos de configuración, versiones compatibles del software y permisos. En backups incrementales hace falta toda la cadena; en PostgreSQL se recompone con pg_combinebackup, descrita en la documentación de PostgreSQL sobre archivado continuo y PITR.
Para PITR en PostgreSQL la regla es estricta: copia base más cadena continua de WAL (Write-Ahead Log, registro previo de escritura). Si falta un segmento WAL, la recuperación se detiene antes del minuto buscado. Archivos como postgresql.conf y pg_hba.conf van aparte del WAL, y la integridad de la copia base se comprueba con la utilidad oficial pg_verifybackup.
Restauración de ensayo sin riesgo para producción y prueba desde la app
El examen real es una prueba en un entorno aislado, totalmente desconectado de producción. Sigue al pie de la letra el mismo manual de emergencia que abrirías de madrugada. Pon el cronómetro desde el minuto cero, incluyendo buscar la copia, descargarla, obtener claves y preparar el servidor.
Dos tropiezos frecuentes en ensayos. Primero, integraciones sin desactivar: olvidas cortar pagos reales, envíos de correo o webhooks, y el simulacro provoca un incidente real a los clientes (en PostgreSQL conviene además cerrar accesos en pg_hba.conf durante la recuperación). Segundo, volumen de juguete: si en producción hay terabytes y ensayas con un volcado recortado, tu medición de RTO miente.
En PostgreSQL con PITR cuida los detalles propios del motor: vacía el directorio de datos y el viejo pg_wal/, descomprime la copia con el usuario del sistema de la BD (no root), ajusta postgresql.conf y crea el marcador recovery.signal. Además, CREATE TABLESPACE se registra en el WAL con ruta absoluta: en otra máquina la restauración puede fallar o pisar un directorio ajeno, así que tras trabajar con tablespaces saca una copia base nueva.
Cuando la base esté arriba, valida el resultado con ojos de la aplicación. Entra con una cuenta de prueba, busca un pedido o documento de control, lee y crea un registro. Compara totales (número de pedidos e importes), relaciones entre tablas, adjuntos y logs de errores. Los cambios que entraron en producción después del punto de corte no estarán aquí, y eso es lo esperado.
Contando minutos y convirtiendo los simulacros en rutina
Al final comparamos los tiempos reales con las metas del negocio. En el análisis de DevOps by REBRAIN lo muestran con un fallo ocurrido justo a las dos de la tarde:
| Escenario | Datos restaurados a las | Aplicación lista a las | Pérdida / caída | Resultado (RPO 15 min, RTO 60 min) |
|---|---|---|---|---|
| Todo según el plan | 13:55 | 14:42 | 5 min / 42 min | Aprobado |
| Punto antiguo | 13:30 | 14:42 | 30 min / 42 min | Fallo en RPO |
| Arranque lento | 13:55 | 15:10 | 5 min / 70 min | Fallo en RTO |
Ni una base intacta salva el día si el equipo tardó demasiado buscando claves y superó la ventana permitida. Y al revés, un arranque veloz tampoco sirve si se perdió la parte reciente de los datos por un hueco en el archivo.
Para que la validación sea constante, lleva un acta: versión del manual, ID de la copia, punto de restauración, RPO/RTO reales y cada fallo detectado. Asigna un responsable y un calendario de simulacros, y ejecuta pruebas extraordinarias tras cambios de esquema, actualizaciones del motor o cambios en el sistema de backups. Empezar es simple: elige un servicio, acuerda RPO y RTO y restaura una copia reciente en un entorno aislado; las claves perdidas y pasos rotos del manual saldrán ahora, no en mitad de una crisis.