Diez mil consultas por segundo, respuesta por debajo de 20 ms en mediana (p50) y, al mismo tiempo, la mitad de las filas de la tabla de perfiles en NULL. En ese escenario se vio Maya en el análisis de SQL Portal basado en un caso de @rauljuncoV (joinenginuity.com). La tabla tenía campos opcionales display_name, timezone y bio, y varios servicios esperaban un único valor no vacío sin NULL.
A primera vista parece fácil: envuelve los campos en COALESCE, la función SQL que devuelve el primer argumento no nulo. Cómodo. Pero bajo carga alta esa salida pronto sale cara.
Por qué COALESCE en la ruta crítica frena y rompe la coherencia
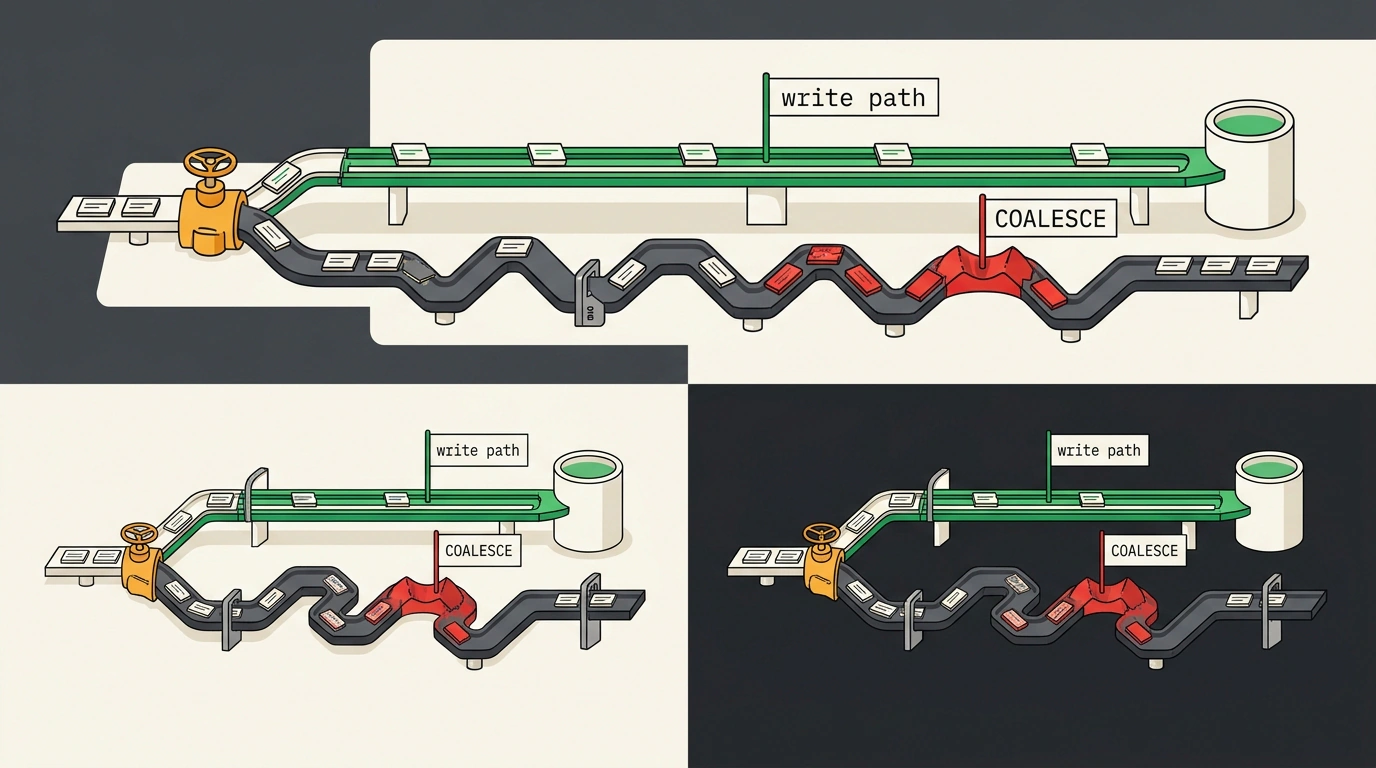
Leer un perfil es la ruta crítica (hot path), el tramo más transitado del sistema. Si allí corre COALESCE, la base quema CPU diez mil veces por segundo repitiendo el mismo cálculo.
-- Opción A: los valores por defecto se calculan en cada lectura
SELECT
    user_id,
    COALESCE(display_name, 'User #' || user_id::text)
        AS effective_display_name,
    COALESCE(timezone, 'UTC') AS effective_timezone
FROM user_profiles
WHERE user_id = $1;
El problema no es solo el procesador. Un índice B-tree normal sobre display_name no acelera búsquedas por COALESCE(...): hace falta un índice por expresión que coincida carácter por carácter con la consulta. Peor aún: distintos equipos ponen sus propios valores por defecto ('Anonymous', 'User'), y un mismo perfil se ve distinto en el feed, las notificaciones push y la analítica.
Cuatro opciones y por qué gana calcular al escribir
Poner DEFAULT y aplicar NOT NULL (opción C) suena limpio, pero DEFAULT solo arregla filas nuevas. Según la documentación de ALTER TABLE en PostgreSQL, un SET NOT NULL normal escanea toda la tabla (sin el proceso en dos pasos CHECK ... NOT VALID y VALIDATE CONSTRAINT), arriesgando bloqueos e inflando el disco. Pasar los valores por defecto a cada servicio o al API Gateway (opción D) es aún más fácil, pero pronto aparecen cinco versiones distintas de la verdad.
| Enfoque | Dónde se calcula | Índices | Riesgo principal |
|---|---|---|---|
A. COALESCE en SELECT | Al leer | Por expresión | CPU y reglas dispares |
B. Columnas effective_* | Al escribir / CDC | B-tree normal | Escritura más compleja, backfill |
C. DEFAULT + NOT NULL | Al insertar nuevas | B-tree normal | Migración pesada |
| D. Lógica en servicios | En el consumidor | Sin índice final | Distintas versiones de la verdad |
Maya eligió la opción B, materialización al escribir (write-time precomputation): calcular el resultado una vez al guardar y almacenarlo en effective_display_name, effective_timezone y effective_bio. Los campos crudos se conservan, así siempre sabes si el usuario escribió UTC o lo puso el sistema.
Para reglas simples sin otras tablas, PostgreSQL ofrece columnas generadas STORED.
CREATE TABLE user_profiles (
    user_id      bigint PRIMARY KEY,
    display_name text,
    timezone     text,
    -- Indicamos STORED explícitamente para guardar el resultado en disco
    effective_display_name text GENERATED ALWAYS AS (
        COALESCE(display_name, 'User #' || user_id::text)
    ) STORED,
    effective_timezone text GENERATED ALWAYS AS (
        COALESCE(timezone, 'UTC')
    ) STORED
);
CREATE INDEX idx_profiles_eff_name
    ON user_profiles (effective_display_name);
Matiz de PostgreSQL 18/19: sin STORED se crea una columna VIRTUAL, que vuelve a calcularse al leer. Además la fórmula debe ser IMMUTABLE y sin subconsultas. Para lógica compleja (idiomas, feature flags), effective_* lo escribe el propio servicio o CDC (Change Data Capture, seguimiento en flujo de cambios como Debezium). Así la lectura queda reducida a pura E/S.
El costo oculto: backfill, lag de CDC e idempotencia
El SELECT rápido se paga al escribir: suben un poco la latencia de INSERT/UPDATE, el espacio en disco y el WAL. Cambiar la fórmula de GENERATED ... STORED con SET EXPRESSION AS reescribe la tabla y borra estadísticas, por lo que luego hace falta ANALYZE.
Las filas antiguas tampoco se rellenan solas: hace falta un backfill, un rellenado en segundo plano por lotes sin bloqueos.
-- El worker procesa lotes hasta que no queden NULL
WITH batch AS (
    SELECT user_id FROM user_profiles
    WHERE effective_display_name IS NULL
    LIMIT 5000 FOR UPDATE SKIP LOCKED
)
UPDATE user_profiles p
SET effective_display_name =
        COALESCE(p.display_name, 'User #' || p.user_id::text),
    effective_timezone = COALESCE(p.timezone, 'UTC')
FROM batch b WHERE p.user_id = b.user_id;
FOR UPDATE SKIP LOCKED evita que el worker estorbe a las consultas vivas, y en la ruta crítica queda un simple SELECT sobre effective_*. Con CDC se suma un retraso de sincronización y el procesador debe ser idempotente (repetir un evento tras un fallo no debe dañar datos), además de resolver condiciones de carrera. Por eso, en un servicio con diez peticiones por segundo conviene dejar COALESCE, mientras que mover el cálculo a la escritura compensa cuando manejas miles de lecturas por segundo.