«В отчёте backup — success. Что проверишь дальше?» — с этого вопроса, который разобрали в канале DevOps by REBRAIN, часто начинаются собеседования на DevOps-инженера, сисадмина или DBA. Зелёный статус доказывает лишь одно: скрипт завершился с кодом 0. А вот поднимется ли из этой копии живой сервис после аварии, он не говорит вообще.
Почему зелёный статус и запущенная база ничего не доказывают
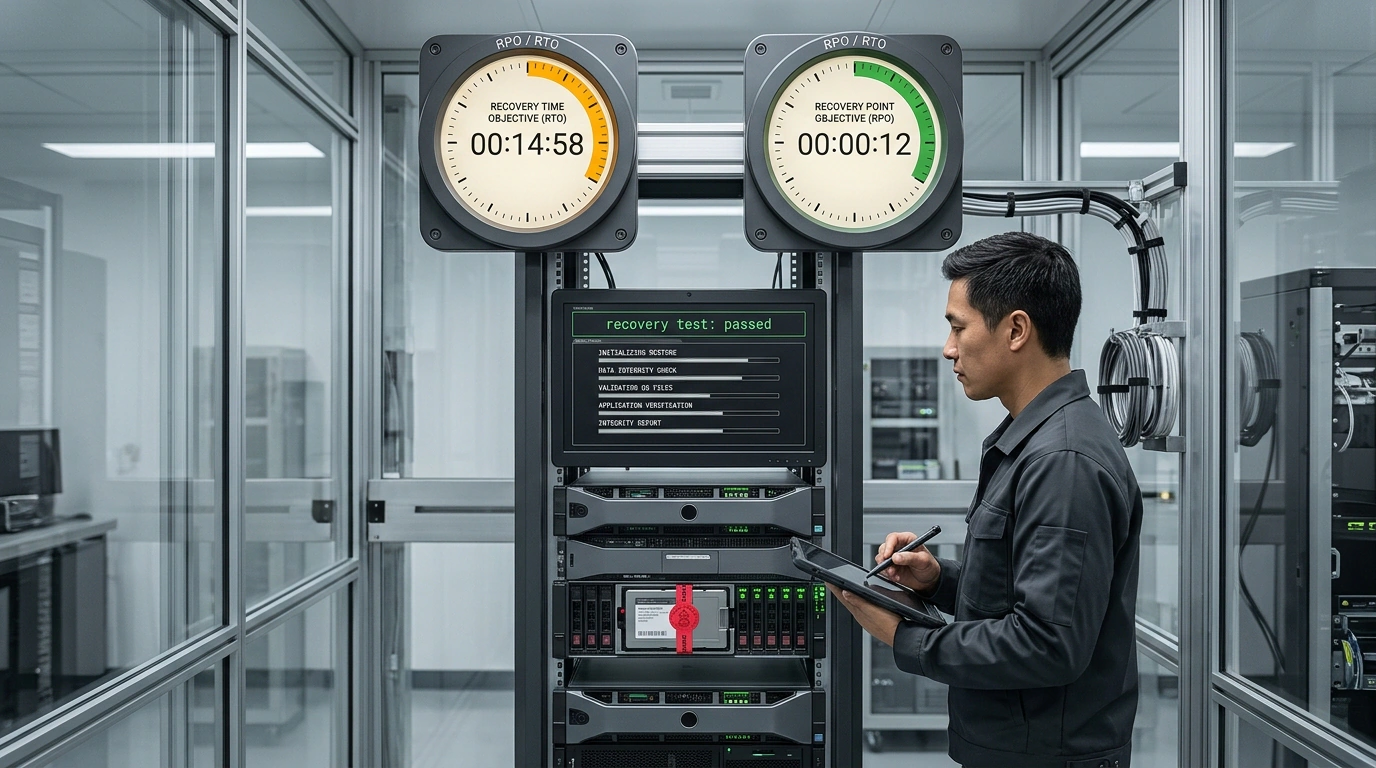
Даже если база из копии спокойно стартовала, радоваться рано. Сначала фиксируем критерии успеха. В стандарте NIST SP 800-34 для этого есть две метрики: RPO (Recovery Point Objective) и RTO (Recovery Time Objective). Проще говоря, RPO — сколько минут данных бизнес готов потерять при сбое, а RTO — сколько минут сервис может лежать, пока ты его чинишь.
Дальше уточняем сценарий: отказ диска, потеря сервера или случайный DELETE без WHERE. В последнем случае ночного дампа мало — нужен PITR (Point-in-Time Recovery), то есть откат ровно на минуту до ошибочного запроса.
Когда условия ясны, проверяй весь комплект. Одна папка с архивом бесполезна, если ключи расшифрования лежат в недоступном хранилище или ушли с бывшим коллегой. Нужны сама копия, ключи, конфиги, совместимые версии ПО и права. Для инкрементальных бэкапов требуется вся цепочка — в PostgreSQL её собирают утилитой pg_combinebackup из документации PostgreSQL по непрерывному архивированию и PITR.
Для PITR в PostgreSQL правило жёсткое: базовая копия плюс непрерывная цепочка WAL (Write-Ahead Log — журнал упреждающей записи). Пропал один сегмент WAL — откат остановится раньше нужной минуты. Конфиги вроде postgresql.conf и pg_hba.conf хранятся отдельно от WAL, а целостность самой копии проверяй штатной утилитой pg_verifybackup.
Учебное восстановление без риска для прода и проверка глазами приложения
Настоящий экзамен — пробный прогон на изолированном стенде, полностью отрезанном от продакшена. Иди строго по той же боевой инструкции, которую откроешь ночью при аварии. Секундомер жми с самого старта — включая поиск копии, скачивание, ключи и подготовку хоста.
Две частые грабли на стенде. Первая — незаглушенные интеграции: забыл отключить реальные платежи, рассылки или вебхуки, и учебный прогон сам устроил инцидент живым клиентам (в PostgreSQL на время отката ещё и закрой доступ в pg_hba.conf). Вторая — игрушечный объём: если в проде терабайты, а тренировка идёт на урезанном дампе, замер RTO врёт.
В PostgreSQL при PITR не забывай про нюансы самой СУБД: очисти каталог данных и старый pg_wal/, распакуй копию под системным пользователем БД (не root), задай параметры в postgresql.conf и создай маркер recovery.signal. А ещё CREATE TABLESPACE пишется в WAL с абсолютным путём — на другой машине откат может сломаться или затереть чужой каталог, так что после работы с табличными пространствами снимай свежую базовую копию.
Когда база стартовала, проверяй результат глазами приложения. Зайди под тестовым аккаунтом, найди контрольный заказ или документ, прочитай и создай запись. Сверь контрольные числа (число заказов и их сумму), связи между таблицами, вложения и логи ошибок. Правки, попавшие в прод уже после точки отката, здесь отсутствуют — это нормально.
Считаем минуты и ставим учения на поток
В финале сравниваем реальные замеры с требованиями бизнеса. В разборе DevOps by REBRAIN это показано на примере сбоя ровно в два часа дня:
| Сценарий | Данные восстановлены на | Приложение готово в | Потеря / простой | Итог (RPO 15 мин, RTO 60 мин) |
|---|---|---|---|---|
| Всё по плану | 13:55 | 14:42 | 5 мин / 42 мин | Пройдено |
| Старая точка | 13:30 | 14:42 | 30 мин / 42 мин | Провал по RPO |
| Медленный старт | 13:55 | 15:10 | 5 мин / 70 мин | Провал по RTO |
Даже идеально целая база не спасает, если команда слишком долго искала ключи и выбилась из отведённого окна. И наоборот, быстрый старт не засчитывается, если свежая часть данных потерялась из-за дыры в архиве.
Чтобы проверка работала регулярно, веди протокол: версия инструкции, ID копии, точка отката, фактические RPO/RTO и все сбои. Назначь ответственного и график учений, а вне очереди запускай тест после смены схемы БД, обновления СУБД или нового способа бэкапа. Начать просто: выбери один сервис, согласуй RPO и RTO и прогони восстановление свежей копии на стенде — забытые ключи и кривые шаги инструкции всплывут сразу, а не посреди аварии.