Контроллер базы шлёт проверку здоровья мастеру PostgreSQL и получает в ответ… тишину. В эту секунду за кулисами уже зреет неприятная история: приложения не могут нормально писать, а управляющий узел гадает, что случилось. Сервер правда умер или просто моргнула сеть до контроллера, пока сам мастер спокойно обслуживает клиентов? Поспешишь поднять реплику — получишь два живых мастера одновременно. Привет, split-brain и разъехавшиеся данные.
Как этого избежать, разобрал инженер PlanetScale Шломи Ноах в статье от 5 ноября 2026 года про аварийный фейловер в Neki — их шардированном PostgreSQL. В предыдущем разборе речь шла о плановом переключении, где все узлы здоровы, преемник выбран заранее, а роутеры буферизуют запросы. При внезапном обрыве сети или отказе железа этой роскоши нет: системе нужно на лету понять, действительно ли мастер недоступен и какая реплика безопасно его заменит.
Почему тишина на health check — ещё не повод менять мастера
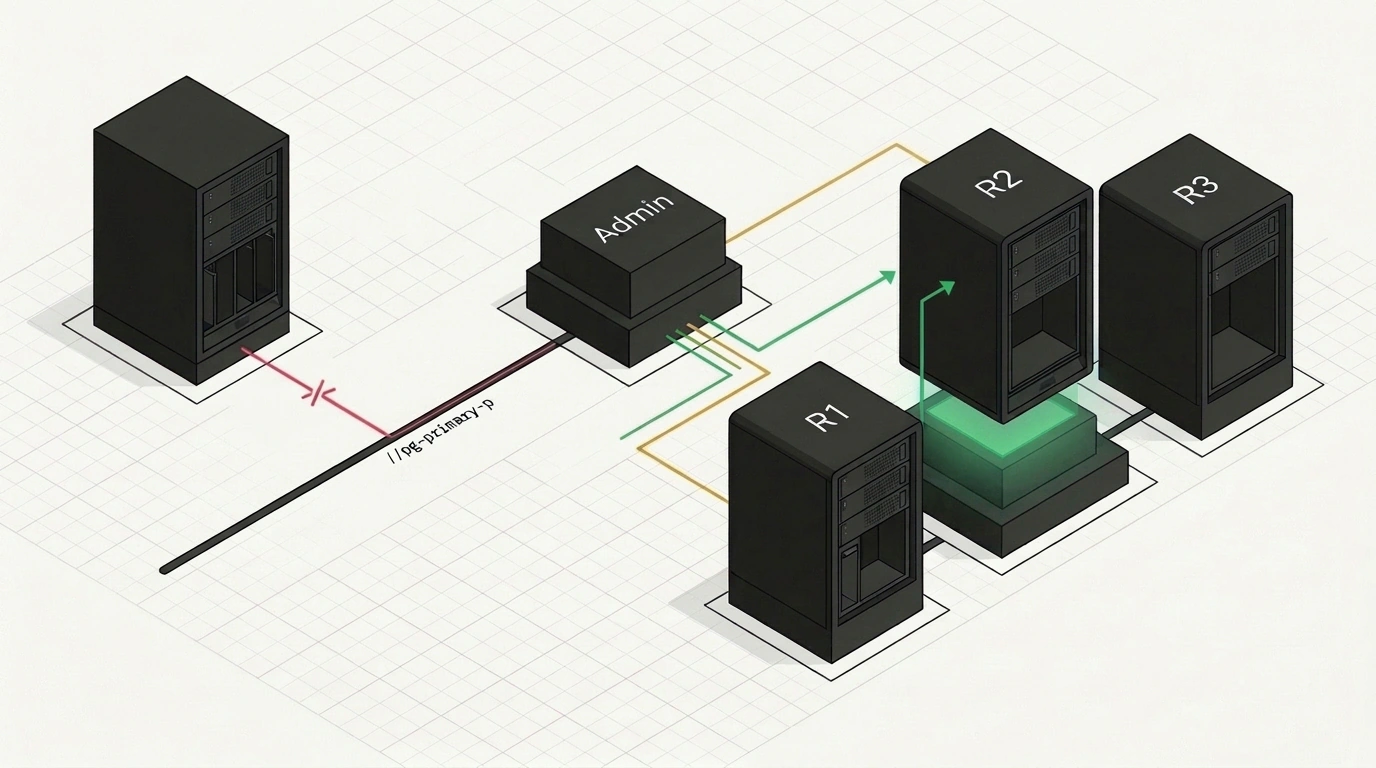
Представь обычный шард Neki: мастер P принимает запись, а реплики R1, R2 и R3 непрерывно тянут и проигрывают WAL (Write-Ahead Log — журнал предзаписи, куда PostgreSQL сначала складывает все изменения). Если управляющий узел Admin теряет связь с P, повторять проверку бесполезно: с разовой потерей пакетов это поможет, а вот если в сетевой изоляции оказался сам Admin, ответа не будет, хотя мастер и реплики спокойно работают дальше.
Многие системы высокой доступности ставят на распределённые лизы — агент на мастере продлевает ключ с таймером в общем хранилище, и когда ключ протух, сервер считают мёртвым. В Neki от лизов для проверки здоровья отказались. Вместо этого Admin опрашивает реплики через системное представление pg_stat_wal_receiver.
-- Admin проверяет состояние приёма WAL на каждой живой реплике
SELECT status,
       written_lsn,
       flushed_lsn,
       last_msg_receipt_time
FROM pg_stat_wal_receiver;
Логика решения простая. Если Admin не видит P, но хоть одна реплика стримит с него данные, переключения не будет — скорее всего, отвалился сам Admin. Если Admin не видит P, минимум одна доступная реплика рапортует об обрыве и никто ей не противоречит, мастера объявляют мёртвым. А если не отвечают ни P, ни реплики, контроллер просто ждёт: промоутить кого-то вслепую — прямой путь ко второму мастеру.
Уверенность здесь даёт синхронная репликация. По умолчанию Neki задаёт в synchronous_standby_names политику ANY 1 (R1, R2, R3) при synchronous_commit = on: мастер не подтвердит клиенту коммит, пока хотя бы одна реплика не сбросит WAL на диск. В момент T подтвердить может R1, а в T+1 — R3. Но если до мастера не достучится ни одна реплика, он физически не завершит ни одной записи, даже оставаясь в живых.
Четыре поломки и один сигнал: как поймать даже зависший Postgres
Чтобы опрос реплик срабатывал быстро, они должны оперативно замечать обрыв. А падает база по-разному.
При обычном краше процесса локальный менеджер PostgresManager (его горутина ждёт завершения процесса) мгновенно шлёт в Admin событие PROCESS_EXITED — правда, контроллер всё равно сверяется с репликами. Если между узлами встал фаервол и режет трафик, соединения сразу падают с ошибкой.
Хуже с тихой потерей пакетов: сокет молчит, а TCP-соединение ещё долго кажется живым. Но самый коварный случай, как пишет Ноах, — зависший процесс PostgreSQL: ядро сервера исправно отвечает по TCP, коннект выглядит здоровым, а сама база вообще ничего не делает.
Различать эти сценарии реплике не нужно. Neki настраивает таймауты так, чтобы любой сбой заканчивался обрывом репликации: потерю пакетов ловят короткие TCP keepalive и tcp_user_timeout, а зависший процесс добивает wal_receiver_timeout. По умолчанию в PostgreSQL он равен 60 секундам, но Neki сжимает его до нескольких секунд — если мастер молчит дольше, реплика сама рвёт связь.
# На мастере (postgresql.conf): коммит ждёт flush WAL от 1 реплики
synchronous_commit = on
synchronous_standby_names = 'ANY 1 (R1, R2, R3)'

# На репликах (postgresql.conf): быстрый разрыв при зависшем мастере
# Дефолт PostgreSQL — 60s; здесь 5s — пример «нескольких секунд»
wal_receiver_timeout = 5s
Так четыре непохожие аварии сводятся к одному сигналу в pg_stat_wal_receiver, без отдельных костылей под каждый вид отказа.
Трюк с двумя слэшами: как отрезать путь «воскресшему» мастеру
Как только Admin решил переключаться, включается жёсткое правило: «С этого момента исходим из худшего: старый мастер может внезапно ожить в любую секунду». Пока фейловер не начался, возврат P безобиден — реплики просто переподключатся. А вот если он воскреснет в разгар переключения, реплики сами вернутся к нему, WAL снова поедет, и P опять сможет закрывать коммиты по ANY 1.
В MySQL для остановки приёма лога есть STOP REPLICA IO_THREAD, а в физической репликации PostgreSQL такого рубильника нет. Поэтому Neki делает обратимую правку primary_conninfo на всех доступных репликах — дописывает // перед именем хоста мастера.
# До фейловера: реплика подключена к мастеру pg-primary-p
primary_conninfo = 'host=pg-primary-p port=5432 application_name=R2'

# Старт фейловера: префикс // ломает резолв хоста, не давая реплике
# вернуться к ожившему P и замораживая её позицию в журнале WAL
primary_conninfo = 'host=//pg-primary-p port=5432 application_name=R2'
Тот же приём работает в Neki и при плановом переключении. Польза двойная: воскресший P останется без реплик и не сможет ничего записать, а позиции WAL на всех узлах намертво замирают для честного сравнения.
Выбор нового лидера по LSN, переключение и судьба старого мастера
Позицию в журнале задаёт LSN (Log Sequence Number): receive_lsn показывает, сколько лога реплика забрала по сети, а replay_lsn — сколько уже применила. Вот пример среза после заморозки:
| Реплика | Получено (receive_lsn) | Применено (replay_lsn) |
|---|---|---|
R1 | 120 | 120 |
R2 | 125 | 122 |
R3 | 123 | 123 |
Вторая реплика забрала по сети больше всех записей, но ещё доигрывает хвост локального лога. Третья чуть отстаёт по приёму, зато уже применила всё полученное. Первая просто отстала. Сначала Admin ищет узел, который уже проиграл самый свежий лог; такого нет, поэтому он ждёт короткое окно, пока лидер по приёму доиграет свой хвост. Если за окно никто не догнал, берут кандидата с максимальным receive_lsn, а при равенстве — с максимальным replay_lsn.
Поскольку WAL строго последователен, максимум по приёму гарантирует, что у кандидата есть вся подтверждённая история, кто бы из реплик ни подтверждал отдельные коммиты. Бонусом остальные реплики содержат префикс нового мастера и легко переходят на новый timeline. Исключение — если впереди оказалась реплика на обслуживании, которую нельзя промоутить: её потом придётся откатывать через rewind или пересобирать.
Дальше Admin создаёт на выбранном узле слоты репликации, промоутит его в PostgreSQL, переключает Routers и перенацеливает остальные реплики. Первые записи на новом мастере немного подождут: по правилу ANY 1 ему нужна хотя бы одна подключившаяся реплика.
Старый мастер P после аварии никогда не возвращают автоматом в реплики — на нём могли остаться неподтверждённые записи. Его переводят в TEARDOWN (вне трафика, репликации и мониторинга), но диск сразу не стирают: логи, последний WAL и состояние диска — лучшая улика для постмортема.
Границы у схемы тоже честные. Если P и одна из реплик окажутся отрезаны вдвоём, они смогут продолжать коммитить по ANY 1 — риск снижают кросс-AZ подтверждениями ценой задержки записи. Не спасёт автоматика и при одновременной гибели мастера и самой свежей реплики, а в асинхронном режиме обрыв реплик даёт лишь сильный сигнал, но не гарантию. Наконец, упасть может и сам Admin — этот разбор Шломи Ноах оставил на следующую статью.