Всего 17% провальных задач сожгли почти треть бюджета на токены. А 30% всех вызовов инструментов ушло на то, чтобы заново выяснять факты о проекте, которые агент уже находил пару часов назад. Такие цифры получили исследователи из Microsoft Research, UC Berkeley и Microsoft Security, прогнав Claude Code через 60 последовательных задач из SWE-bench — популярного набора реальных багов из открытых Python-проектов.
Картина до боли знакомая. Каждую новую сессию кодинг-агент просыпается с чистой головой: снова ищет команду запуска тестов, спотыкается об отсутствующий глобальный pytest и прощупывает структуру папок. А ты каждый раз платишь за один и тот же урок. Чтобы закрыть эту дыру, команда выпустила открытый плагин TokenEconomizer под лицензией MIT — он работает локально, не трогает веса модели и учится на твоих прошлых сессиях.
Три утечки, на которых сгорают токены
Авторы препринта на arXiv запускали задачи подряд в одних и тех же репозиториях — ровно как в обычной рабочей неделе. Так вскрылись три конкретные дыры.
Первая — «амнезия» по проекту. После пяти выполненных задач в одном репозитории почти треть обращений к инструментам повторяла действия из прошлых сессий этой же папки. Между разными репозиториями совпадений было всего 7%. Модель переучивала не программирование, а бытовые мелочи твоего проекта: порядок сборки, переменные окружения или python -m pytest вместо голого pytest.
Вторая — балласт лишних инструментов. На каждом шаге в контекст уходило 23 описания инструментов, из которых 16 не пригодились вообще ни разу. Модель исправно перечитывала этот справочник на каждом ходе — впустую.
Третья — дорогие тупики. Застрявший агент не просто проваливает задачу, он проваливает её задорого: те 17% неудачных запусков съели 32% общего счёта. Авторы прогнали на тех же задачах три популярных открытых плагина экономии токенов, но единого победителя не нашлось: каждый помогал в одних проектах и проигрывал в других. Универсальная настройка не работает — экономия должна подстраиваться под конкретный репозиторий.
Как устроен Token Economizer под капотом
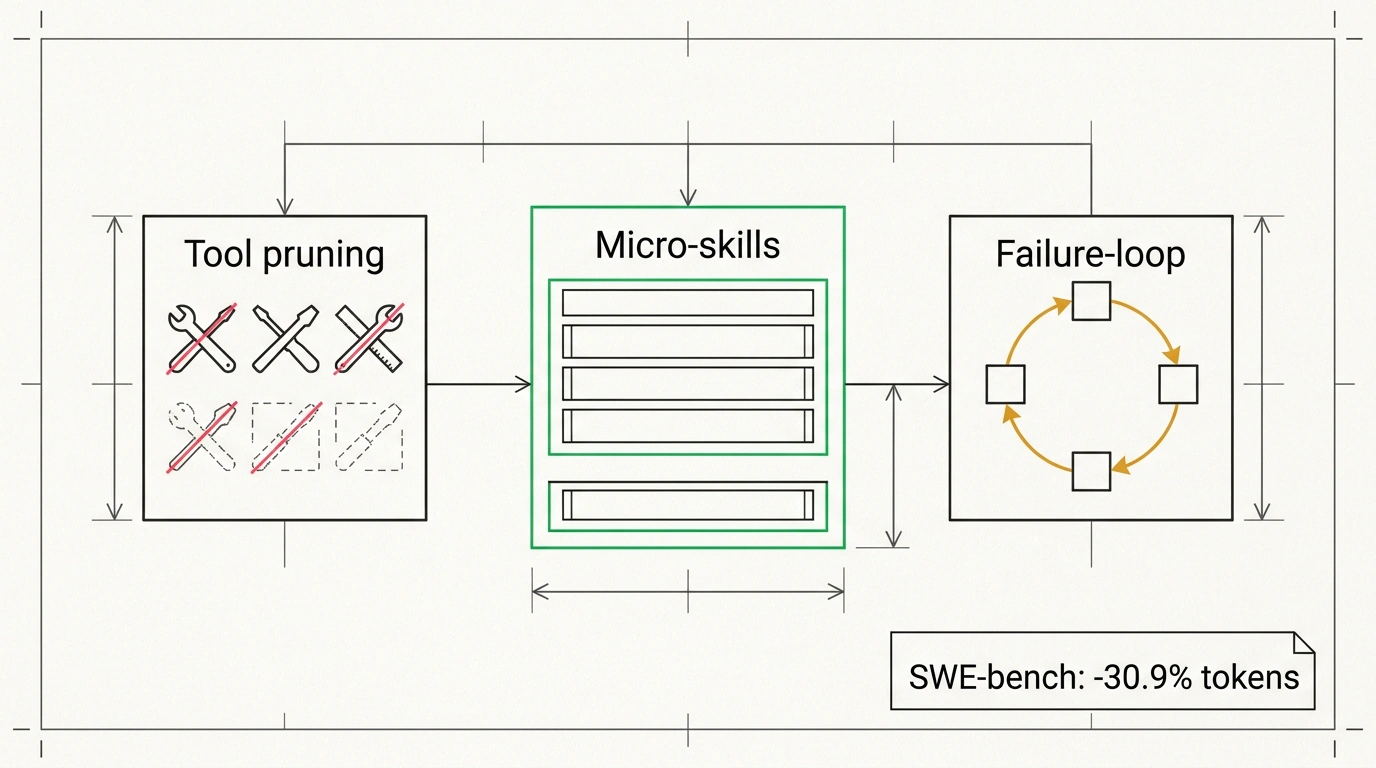
Плагин работает как чёрный ящик: не требует менять модель, переписывать агента или заводить отдельный API-ключ. Весь накопленный опыт лежит локально в ~/.tokeneconomizer, а в работу он встраивается через штатные хуки, стартовый контекст и настройки агента. Внутри три модуля — каждый закрывает свою утечку, а вместе они дают максимальный выигрыш.
Micro-skills (микронавыки проекта) лечат «амнезию». Это короткие однострочные заметки о репозитории: команды сборки, флаги тестов, пути к конфигам. Плагин собирает их из повторяющихся ошибок и через модель-ревьюера, которая раз в 3 сессии просматривает логи. Защита от мусора простая: заметка попадает в стартовый контекст только после подтверждения в 3 разных сессиях и сразу вылетает, если новые сессии ей противоречат. В GitHub-версии модуль выключен по умолчанию — его включают отдельной командой. Есть и лёгкий режим, который учится только на ошибках без допвызовов модели.
Tool pruning (отсев неиспользуемых инструментов) убирает лишний балласт из промпта. Если инструмент или MCP простаивает 10 промптов подряд минимум в двух сессиях (или 5 сессий любой длины), плагин прячет его через настройки агента. Базовые команды чтения, правки файлов и запуска в терминале неприкосновенны. Боишься, что отключат нужное? Включи режим propose — плагин лишь предложит список на скрытие, а вернуть любой инструмент можно одной командой toolprune restore.
Failure-loop intervention (судья зацикливания) ловит дорогие тупики. Набрав хотя бы 5 успешных ходов в проекте для понимания обычного темпа, модуль следит за повторяющимися ошибками. Когда агент бьётся в одну стену, подключается модель-судья и отличает реальный ступор от медленного прогресса. При уверенности от 70% в контекст вбрасывается короткая подсказка сменить подход — не чаще раза за ход. Не помогло? Плагин не убивает задачу, а предупреждает тебя и подсказывает, куда вмешаться. И если сам плагин вдруг упадёт с ошибкой, сессия просто продолжится как ни в чём не бывало.
Тесты и ловушка «ленивых рассуждений»
В главном замере прогнали 277 задач SWE-bench по шести репозиториям на пяти связках агент+модель — стартуя с нуля, без накопленной истории. Все цифры ниже честные (нетто): стоимость собственных вызовов плагина уже вычтена с учётом реального кэширования токенов.
| Связка агент + модель | Изменение стоимости | Изменение pass@1 |
|---|---|---|
| Claude Code + Sonnet 5 | −23,6% | +1,3 |
| Claude Code + Opus 4.8 | −30,9% | −1,0 |
| Codex + GPT-5.6 Terra | −24,7% | +0,9 |
| Codex + GPT-5.6 Sol | −26,1% | +1,6 |
| Copilot CLI + Sonnet 5 | −18,4% | +2,6 |
Метрика pass@1 показывает долю задач, решённых правильно с первой попытки. Картина в таблице говорит сама за себя: во всех 30 парах «репозиторий × связка» работа стала дешевле базовой — без исключений. При этом в четырёх из пяти связок точность даже слегка подросла: агент перестал тратить контекст на суету. Небольшая просадка вышла только у самой тяжёлой модели в обмен на самый заметный выигрыш по чеку. Интерактивные графики доступны на странице проекта.
Дальше плагин проверили за пределами багфиксов. На последовательных задачах веб-разработки Web-Bench расходы упали на 16,0–21,2%. Даже в двух бенчмарках по аудиту безопасности, где каждая задача шла в новом репозитории без истории, чек всё равно снизился на 6,4–19,6% — меньше контекста для обучения, скромнее эффект, но он сохраняется.
А вот самый поучительный вывод касается reasoning effort — настройки глубины рассуждений, задающей, сколько внутренних токенов модель тратит «на подумать». Интуитивно кажется: зачем плагины, если можно просто скрутить рассуждения пониже и сразу сэкономить? Исследователи проверили и это. Токенов действительно уходило столько же или меньше, но качество кода резко падало. Разница простая: урезая рассуждения, ты экономишь за счёт того, что агент глупеет; Token Economizer экономит за счёт того, что агент лучше знает твой проект.
Установка и честная оговорка про «разгон»
Официально поддерживаются Claude Code, Codex, GitHub Copilot CLI и Pi. Экспериментально плагин работает с opencode, Cursor Agent (только macOS и Linux), Hermes Agent, Grok Build, Antigravity CLI и Factory Droid. Нужен авторизованный агент и Python 3.10+. Клонированную папку удалять нельзя: агенты запускают плагин прямо из неё.
Установка для Claude Code:
# Клонируем репозиторий и оставляем папку на диске
git clone https://github.com/microsoft/TokenEconomizer.git

# Регистрируем локальный маркетплейс и ставим плагин
claude plugin marketplace add "$PWD/TokenEconomizer"
claude plugin install tokeneconomizer@tokeneconomizer
Дальше запусти claude, подтверди доверие к папке и выполни внутри сессии три команды — проверишь статус, обновишь каталог инструментов и включишь микронавыки:
# Проверяем, что плагин подхватился
/tokeneconomizer:status

# Обновляем каталог инструментов (раз на машину и после апдейтов)
/tokeneconomizer:toolprune refresh-catalog

# Включаем Micro-skills (в GitHub-версии они выключены по умолчанию)
/tokeneconomizer:config set microskills=on
Из коробки сразу включены только отсев инструментов и судья зацикливания. Команду refresh-catalog выполняют один раз на компьютер и повторяют после обновлений агента. Для остальных официальных клиентов схема та же:
# GitHub Copilot CLI
copilot plugin marketplace add "$PWD/TokenEconomizer"
copilot plugin install tokeneconomizer@tokeneconomizer

# Codex (после старта проверь статус через $tokeneconomizer:status)
codex plugin marketplace add "$PWD/TokenEconomizer"
codex plugin add tokeneconomizer@tokeneconomizer

# Pi (проверка через /te status)
pi install git:github.com/microsoft/TokenEconomizer
В Copilot CLI после установки нужно зайти в сессию и запустить /tokeneconomizer:status с /tokeneconomizer:toolprune refresh-catalog, а в Codex — перезапустить клиент после подтверждения хуков. Все вызовы идут через твою обычную подписку агента, код на сторонние серверы не уходит.
В новом репозитории первые 2–5 задач могут стоить чуть дороже обычного: плагин собирает статистику и тратит немного токенов на «разгон». В тестах Claude Code суммарный чек во всех репозиториях опускался ниже базового к шестой задаче — главный выигрыш раскрывается там, где ты работаешь регулярно, а не на разовых скриптах.
Если хочешь присмотреться без лишнего риска, оставь toolprune в режиме propose или не включай microskills первые пару дней — даже два базовых модуля сами по себе заметно сбивают расход на длинных сессиях.