Apenas el 17% de las tareas fallidas quemaron casi un tercio del presupuesto de tokens. Además, el 30% de todas las llamadas a herramientas se fueron en volver a averiguar datos del proyecto que el agente ya había encontrado un par de horas antes. Esas cifras las obtuvieron investigadores de Microsoft Research, UC Berkeley y Microsoft Security al ejecutar Claude Code en 60 tareas consecutivas de SWE-bench, un conjunto popular de bugs reales en proyectos abiertos de Python.
La escena resulta demasiado familiar. En cada nueva sesión, el agente de programación despierta con la mente en blanco: vuelve a buscar el comando para lanzar los tests, tropieza con la falta de un pytest global y explora de nuevo la estructura de carpetas. Y tú pagas cada vez por la misma lección. Para cerrar esa fuga, el equipo lanzó el plugin abierto TokenEconomizer bajo licencia MIT: funciona de manera local, no toca los pesos del modelo y aprende de tus sesiones pasadas.
Las tres fugas donde se queman los tokens
Los autores del preprint en arXiv ejecutaron tareas seguidas dentro de los mismos repositorios, tal como ocurre en una semana laboral normal. Así salieron a la luz tres fugas concretas.
La primera es la «amnesia» del proyecto. Tras cinco tareas completadas en un mismo repositorio, casi un tercio de las llamadas a herramientas repetía acciones de sesiones anteriores en esa misma carpeta. Entre repositorios distintos, las coincidencias fueron apenas del 7%. El modelo no estaba reaprendiendo a programar, sino los detalles cotidianos de tu proyecto: el orden de compilación, las variables de entorno o usar python -m pytest en lugar de pytest a secas.
La segunda es el lastre de herramientas innecesarias. En cada paso entraban al contexto 23 descripciones de herramientas, de las cuales 16 no se usaron ni una sola vez. El modelo releía fielmente ese catálogo en cada turno, sin ningún provecho.
La tercera son los callejones sin salida costosos. Un agente atascado no solo falla la tarea, sino que falla caro: ese 17% de ejecuciones fallidas consumió el 32% de la factura total. Los autores probaron en las mismas tareas tres plugins abiertos populares de ahorro de tokens, pero no hubo un ganador único: cada uno ayudaba en ciertos proyectos y empeoraba en otros. Una configuración universal no funciona; el ahorro debe adaptarse a cada repositorio concreto.
Cómo funciona Token Economizer por dentro
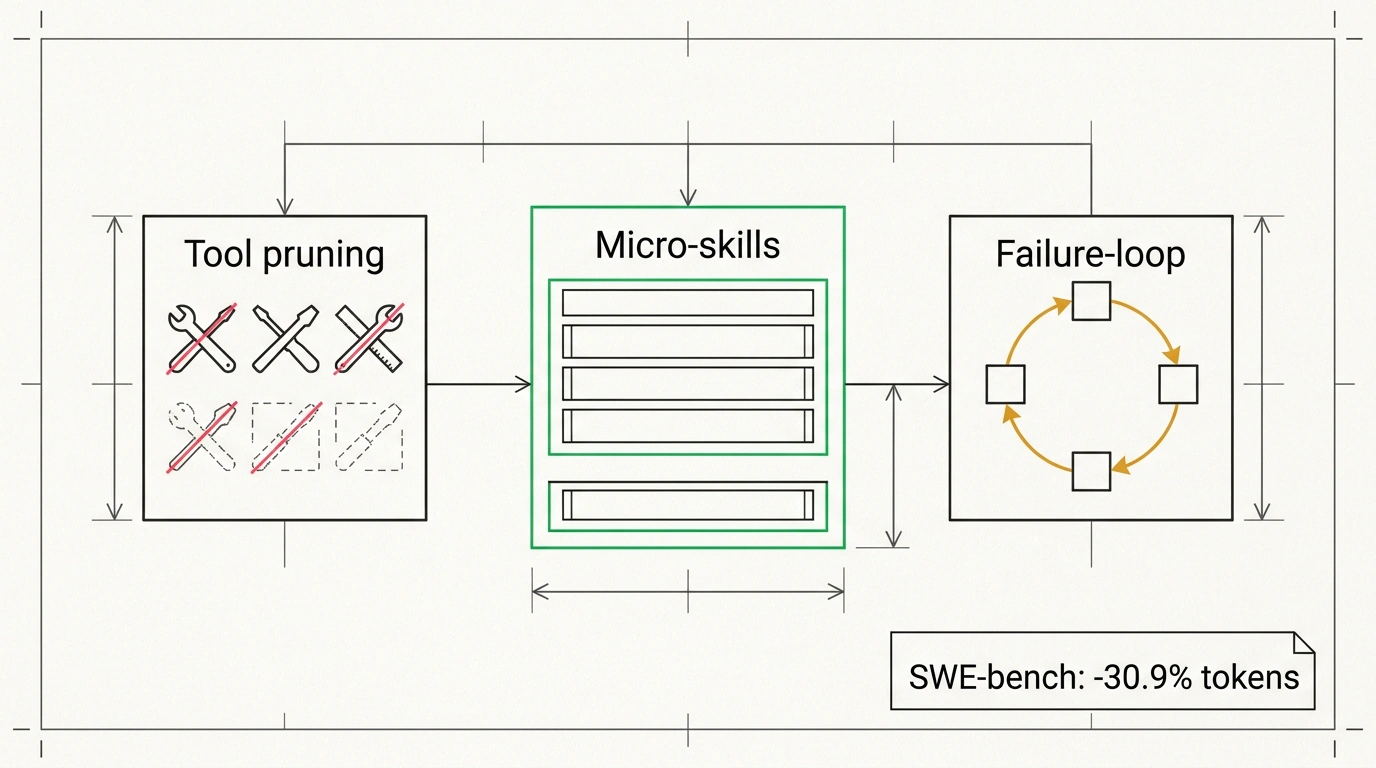
El plugin opera como una caja negra: no exige cambiar de modelo, reescribir el agente ni crear una clave de API aparte. Toda la experiencia acumulada se guarda localmente en ~/.tokeneconomizer, y se integra en el flujo mediante hooks estándar, el contexto inicial y la configuración del agente. Por dentro lleva tres módulos: cada uno tapa una fuga y juntos logran el mayor ahorro.
Micro-skills (microhabilidades del proyecto) curan la «amnesia». Son notas breves de una línea sobre el repositorio: comandos de compilación, flags de pruebas o rutas de configuración. El plugin las recopila a partir de errores repetidos y mediante un modelo revisor que analiza los registros cada tres sesiones. El filtro contra ruido es sencillo: una nota entra en el contexto inicial solo tras confirmarse en tres sesiones distintas y sale de inmediato si nuevas sesiones la contradicen. En la versión de GitHub este módulo viene apagado por defecto y se activa con un comando. También existe un modo ligero que aprende solo de errores, sin llamadas extra al modelo.
Tool pruning (poda de herramientas sin uso) elimina el peso muerto del prompt. Si una herramienta o MCP pasa 10 prompts seguidos sin usarse en al menos dos sesiones (o cinco sesiones de cualquier duración), el plugin la oculta en la configuración del agente. Los comandos básicos de lectura, edición de archivos y ejecución en terminal son intocables. ¿Te preocupa que desactive algo necesario? Activa el modo propose: el plugin solo sugerirá la lista para ocultar, y podrás restaurar cualquier herramienta con el comando toolprune restore.
Failure-loop intervention (juez de bucles de fallo) detecta los bloqueos caros. Tras reunir al menos cinco pasos exitosos en el proyecto para entender el ritmo habitual, el módulo vigila los errores repetidos. Cuando el agente choca contra el mismo muro, entra en escena un modelo juez que distingue un bloqueo real de un avance lento. Si la confianza supera el 70%, inyecta en el contexto una pista breve para cambiar de enfoque, como máximo una vez por turno. ¿No funcionó? El plugin no mata la tarea, sino que te avisa e indica dónde intervenir. Y si el propio plugin llega a fallar, la sesión continúa como si nada.
Pruebas y la trampa del «razonamiento perezoso»
En la medición principal se ejecutaron 277 tareas de SWE-bench en seis repositorios y cinco combinaciones de agente y modelo, arrancando desde cero sin historial acumulado. Todas las cifras siguientes son netas: ya descuentan el costo de las llamadas propias del plugin teniendo en cuenta el caché real de tokens.
| Combinación agente + modelo | Cambio en el costo | Cambio en pass@1 |
|---|---|---|
| Claude Code + Sonnet 5 | −23.6% | +1.3 |
| Claude Code + Opus 4.8 | −30.9% | −1.0 |
| Codex + GPT-5.6 Terra | −24.7% | +0.9 |
| Codex + GPT-5.6 Sol | −26.1% | +1.6 |
| Copilot CLI + Sonnet 5 | −18.4% | +2.6 |
La métrica pass@1 mide la proporción de tareas resueltas correctamente al primer intento. La tabla habla por sí sola: en los 30 pares de «repositorio × combinación» el trabajo salió más barato que la línea base, sin excepciones. Además, en cuatro de cinco combinaciones la precisión incluso subió un poco porque el agente dejó de gastar contexto en rodeos. Solo el modelo más pesado tuvo una leve caída a cambio del mayor recorte en la factura. Los gráficos interactivos están disponibles en la página del proyecto.
Después probaron el plugin fuera de la corrección de bugs. En tareas consecutivas de desarrollo web en Web-Bench, el gasto bajó entre un 16.0% y un 21.2%. Incluso en dos benchmarks de auditoría de seguridad, donde cada tarea corría en un repositorio nuevo sin historial, la factura bajó entre un 6.4% y un 19.6%: menos contexto para aprender deja un efecto más modesto, pero sigue funcionando.
La conclusión más instructiva tiene que ver con reasoning effort, el ajuste de profundidad de razonamiento que define cuántos tokens internos dedica el modelo a «pensar». A primera vista parece lógico preguntar: ¿para qué usar plugins si basta con bajar el razonamiento y ahorrar de golpe? Los investigadores también lo probaron. El gasto de tokens bajaba igual o más, pero la calidad del código se desplomaba. La diferencia es simple: al recortar el razonamiento ahorras volviendo más torpe al agente; con Token Economizer ahorras porque el agente conoce mejor tu proyecto.
Instalación y una advertencia honesta sobre el «arranque»
El soporte oficial cubre Claude Code, Codex, GitHub Copilot CLI y Pi. De forma experimental funciona con opencode, Cursor Agent (solo macOS y Linux), Hermes Agent, Grok Build, Antigravity CLI y Factory Droid. Necesitas un agente autenticado y Python 3.10+. No borres la carpeta clonada: los agentes ejecutan el plugin directamente desde ahí.
Instalación para Claude Code:
# Clonamos el repositorio y dejamos la carpeta en disco
git clone https://github.com/microsoft/TokenEconomizer.git

# Registramos el marketplace local e instalamos el plugin
claude plugin marketplace add "$PWD/TokenEconomizer"
claude plugin install tokeneconomizer@tokeneconomizer
Luego inicia claude, confirma la confianza en la carpeta y ejecuta tres comandos dentro de la sesión para revisar el estado, actualizar el catálogo de herramientas y activar las microhabilidades:
# Comprobamos que el plugin cargó bien
/tokeneconomizer:status

# Actualizamos el catálogo de herramientas (una vez por equipo y tras cada actualización)
/tokeneconomizer:toolprune refresh-catalog

# Activamos Micro-skills (vienen apagadas por defecto en la versión de GitHub)
/tokeneconomizer:config set microskills=on
De fábrica vienen activos solo la poda de herramientas y el juez de bucles. El comando refresh-catalog se ejecuta una vez por computadora y se repite tras actualizar el agente. Para los demás clientes oficiales el esquema es idéntico:
# GitHub Copilot CLI
copilot plugin marketplace add "$PWD/TokenEconomizer"
copilot plugin install tokeneconomizer@tokeneconomizer

# Codex (al iniciar, revisa el estado con $tokeneconomizer:status)
codex plugin marketplace add "$PWD/TokenEconomizer"
codex plugin add tokeneconomizer@tokeneconomizer

# Pi (comprobación con /te status)
pi install git:github.com/microsoft/TokenEconomizer
En Copilot CLI hay que entrar en la sesión tras instalar y ejecutar /tokeneconomizer:status junto con /tokeneconomizer:toolprune refresh-catalog; en Codex, reiniciar el cliente después de aprobar los hooks. Todas las llamadas pasan por tu suscripción habitual del agente y el código no sale a servidores de terceros.
En un repositorio nuevo, las primeras 2 a 5 tareas pueden costar un poco más de lo normal porque el plugin recopila estadísticas y gasta algo de tokens en «calentar». En las pruebas con Claude Code, la factura acumulada bajó por debajo de la línea base hacia la sexta tarea en todos los repositorios: el mayor beneficio aparece donde trabajas con regularidad, no en scripts aislados.
Si quieres probarlo sin asumir riesgos, deja toolprune en modo propose o no actives microskills los primeros días; incluso los dos módulos base por separado recortan bastante el gasto en sesiones largas.