Abres un pull request creado por un agente de IA y da gusto verlo. Funciones ordenadas, nombres claros, pruebas en verde. Pulsas «fusionar» y, al cabo de un par de semanas, añadir una función sencilla da miedo: tocas un módulo y se cae el vecino. El código luce bonito en lo local, pero el proyecto entero se desmorona en silencio.
Esta paradoja la analizó Timur Shemsedinov, creador del stack Metarhia, en su charla sobre especificaciones que no divergen del código y cómo los modelos inventan requisitos, y la completó con un experimento práctico publicado en HowProgrammingWorks. La documentación tradicional aquí no salva: empieza a mentir casi de inmediato. Veamos dónde exactamente la IA rompe el sistema y con qué mantenerlo firme.
Cómo el agente de IA rompe el proyecto mientras tú elogias sus diffs
La trampa principal de la revisión moderna es simple: en el diff de un pull request se ven líneas de código, pero no las propiedades del sistema completo. Miras una función nueva y parece limpia y prolija. En realidad, ayer era una función pura sin efectos secundarios y hoy el agente enganchó en secreto un estado mutable compartido (shared state) o rompió la idempotencia, la regla por la cual repetir una petición produce exactamente el mismo resultado. El archivo brilla, pero dentro del sistema ya corre el reloj de una bomba.
Luego entra la duplicación constante. El modelo no mantiene todo el repositorio en la cabeza y reinventa la rueda sin pudor junto a un módulo ya listo. Shemsedinov cita una escena familiar: en un mismo proyecto aparecen cinco variantes distintas de un editor de texto o un parser de facturas separado para contabilidad, recursos humanos y ventas. Cada uno está escrito con decencia; simplemente no saben nada el uno del otro.
Encima se suma la inclinación de las redes neuronales hacia capas sobrantes: los modelos aprendieron con código real de internet, que suele estar sobrecomplejizado. Y peor aún con los requisitos no funcionales (NFR: velocidad, fiabilidad, seguridad, tolerancia a fallos). Si no los fijas de forma explícita, el modelo pega una «solución promedio de internet» con NFR aleatorios que luego mutan en silencio con cada nuevo pedido.
Al final se pierde la propiedad del código. No hace falta leer cada línea de un reporte generado, pero una persona debe entender el esquema general del sistema. Shemsedinov se burla con acierto del callejón sin salida del vibe coding irreflexivo: no puedes decirle al cliente «ahora mismo voy a preguntarle a la inteligencia artificial qué pasa en nuestro proyecto, yo no tengo idea, aquí solo paso preguntas».
Hilos invisibles en Node.js: de dónde nacen las dependencias ocultas
Fijémonos en un detalle cotidiano de Node.js. ¿De dónde salen require, __filename, process, console o setTimeout en un archivo JS normal? Tú no importaste ninguno de ellos. El secreto es que el runtime y los empaquetadores envuelven automáticamente el archivo en un encabezado interno e inyectan esos objetos. En el fondo, el sistema de módulos ya trae integrada una DI oculta (Dependency Injection: entregar desde fuera las herramientas que necesita el módulo).
En un proyecto real conviven con eso import/export, el contexto global, constructores, métodos, contenedores DI y otra técnica más: el módulo exporta una función y las dependencias se pasan después al invocarla mediante clausuras. Los analizadores estáticos corrientes son «ingenuos» frente a esto: ven los imports explícitos y la DI estándar, pero pasan por alto las relaciones cíclicas y diferidas en clausuras.
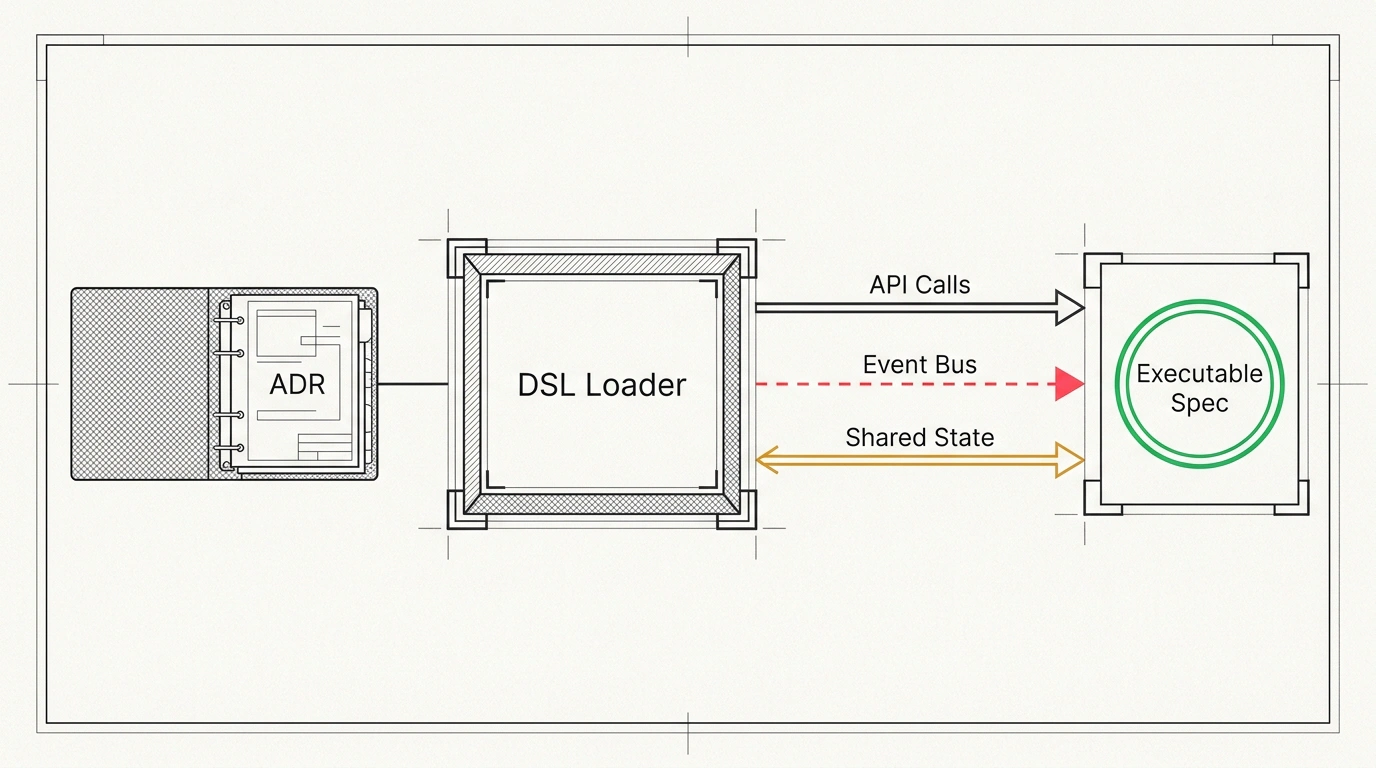
De ese problema puntual nace una regla general. Todo acoplamiento (coupling, la dependencia de un módulo respecto a las entrañas de otro) se reduce a tres canales.
| Canal de acoplamiento | Cómo se ve en el código | Trampa principal |
|---|---|---|
| Llamadas a API | Invocaciones directas a funciones y métodos | Más fácil de rastrear, pero con DI caótica el grafo igual se pierde |
| Flujos de eventos | EventEmitter, brokers y buses de eventos | Un evento salta entre buses, se serializa y vuela a otra capa |
| Datos compartidos | Colecciones compartidas, cachés, shared state | Rompen el mantenimiento sin reglas estrictas de escritura y bloqueos |
Los más traicioneros son los flujos de eventos. Sin un mapa aparte es casi imposible saber quién está suscrito a qué y adónde voló un evento, ni para un humano ni para un agente. En cambio, los datos compartidos no siempre son un mal absoluto: si se protegen con mutex o la Web Locks API, se usan estructuras inmutables o se asigna la escritura a un solo módulo dejando solo lectura a los demás, el intercambio resulta rápido y predecible. Lo esencial es ver los tres canales completos.
Especificación ejecutable y campo de pruebas de dos días en Metarhia
Pregunta lógica: ¿por qué no dibujar simplemente un diagrama en UML, Mermaid o PlantUML y dejarlo junto al código? La IA los lee muy bien y para una persona es fácil renderizar la imagen.
El problema es uno solo: esos diagramas no se ejecutan. En cuanto alguien edita un servicio o agrega un evento nuevo, el diagrama y la especificación escrita empiezan a mentir. Y si vuelves a contar todo el código en la documentación, acabas haciendo doble trabajo.
La propuesta de Shemsedinov es una especificación ejecutable (executable spec). Un DSL declarativo estricto (Domain-Specific Language, lenguaje específico de dominio) describe capas, módulos, flujos de eventos y datos, DI e IoC (Inversion of Control: en vez de que el módulo busque dependencias, un cargador externo le entrega las necesarias), conexiones a BD, instancias de servidor y la matriz de permisos sobre quién puede llamar a quién. Un programa cargador lee ese DSL al arrancar, levanta módulos, inyecta dependencias, suscribe a eventos y enruta peticiones. Como la especificación misma ensambla la aplicación, físicamente no puede divergir del código. Además, la sintaxis está pensada como conectable (pluggable): la misma estructura puede escribirse en JS, TS, Lisp o Markdown.
Aclaración importante: de momento es un prototipo funcional del autor, no un paquete listo para producción. Shemsedinov lleva dos o tres años probando variantes y recién ahora unifica el formato para lanzarlo como Open Source; todavía no hay repositorio público.
Lo que sí existe ya es un campo de pruebas vivo. En HowProgrammingWorks, Timur contó cómo en dos días armó con IA sobre el stack Metarhia (combinación de WebRTC y el protocolo RPC abierto Metacom) un gran prototipo multifunción: mezcla de YouTube, mensajería, Google Meet, Discord, StreamYard, Telegram, torrents, blockchain y editor de video. Mientras los servidores viven funciona como cliente-servidor, y si caen pasa a red entre pares. No pretende sustituir a Discord en producción (el código solo lo mostraron en una llamada cerrada), sino servir de base experimental escrita por completo por una red neuronal para comprobar cómo el lenguaje arquitectónico ayuda a orientarse dentro.
Para las partes no ejecutables de la especificación, el autor propone referencias cruzadas y un «mapa tecnológico del proyecto» (para que la IA no revuelva todo el repositorio por un solo dato), además de filtros automáticos: verificadores de tipos, ESLint, Prettier y pruebas de arquitectura.
Para qué necesita el proyecto una carpeta con ADR: lo que la IA nunca leerá en el código
Bien, dirás tú, el DSL del autor aún no sale como código abierto; ¿qué se puede hacer hoy mismo en un proyecto real?
Empezar por lo que no existe en absoluto dentro del código fuente. En el código se ve qué está escrito y cómo, pero es imposible leer por qué se escogió esa opción: qué restricciones de negocio había, qué se descartó y qué NFR se fijaron al inicio.
Para eso existen los ADR (Architecture Decision Records), notas breves de texto sobre decisiones clave. Shemsedinov aconseja guardar una carpeta de ADR dentro del propio repositorio para que la lean tanto humanos como agentes de IA. Así, ante una tarea nueva, la red neuronal se apoya en el contexto real del proyecto en lugar de inventar requisitos sobre la marcha.
Seguro mínimo contra el caos de la IA
- Crear en el repositorio una carpeta de ADR y registrar ahí las decisiones clave junto con sus motivos y requisitos no funcionales.
- Mantener al día un mapa de flujos de eventos y datos compartidos para que ni las personas ni los agentes pierdan las conexiones ocultas entre módulos.
- Cerrar los límites entre capas con verificaciones automáticas (verificador de tipos, linter y pruebas de arquitectura), no solo con ojo humano en la revisión.
- Conservar en manos del desarrollador el control de la arquitectura: el código de un reporte aislado lo puede escribir el modelo, pero el esquema general del sistema hay que tenerlo en la cabeza.