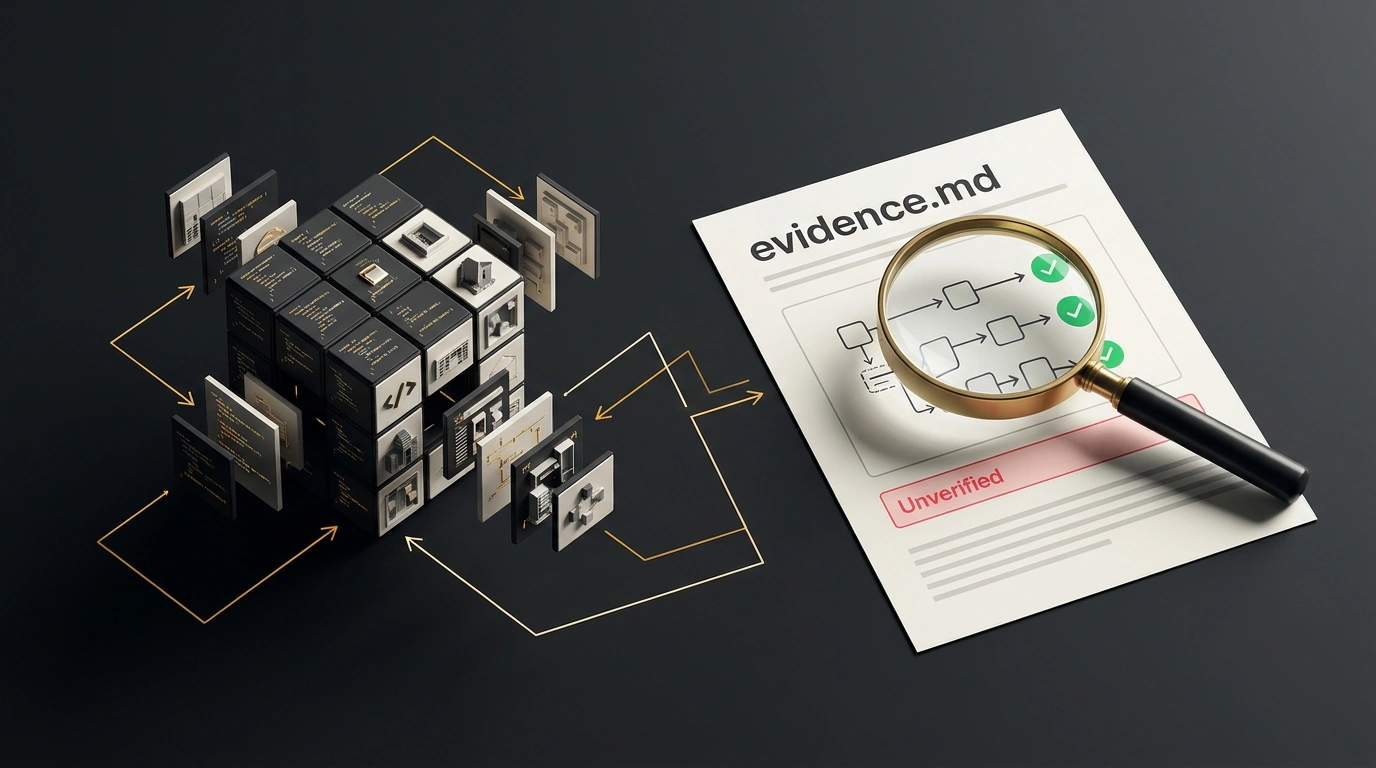
Parece una tarea facilísima: tomas un buen repositorio open source en GitHub, se lo pasas a un agente de IA y le pides «entiende cómo funciona y ármame un equivalente para mi caso», esperando salir con una herramienta lista. En la práctica, casi siempre obtienes una fachada atractiva con puro relleno simulado por debajo.
Para quitarle al modelo la costumbre de inventar, en DeepSeek Harness (aplicación agéntica abierta bajo licencia MIT, con 284,219 estrellas en GitHub) se instala el plugin REA — Reverse Engineer Anything (también MIT, 470,025 estrellas). En DeepSeek Harness todo se extiende mediante plugins sobre la arquitectura Cordis, así que el servidor MCP local REA 6.9.0 del 12 de noviembre de 2026 se acopla directo.
Para qué sirve evidence.md y su sección más honesta
El flujo sigue el esquema Study -> Evidence -> Rebuild -> Polish: estudia el código original, registra los hechos en evidence.md, reconstruye tu versión y pule el acabado. Por dentro corre DeepSeek V4.1 Flash, un modelo rápido capaz de leer capturas de pantalla y comprobar él mismo la maquetación.
El aporte principal de REA es la capa de evidencia. En evidence.md entran únicamente archivos leídos, funciones, líneas y orden de llamadas; al final aparece un apartado de «qué no se pudo demostrar». Cuando el agente admite con claridad hasta dónde no llegó, puedes confiar en el resto del informe.
«Espera, ¿y si el proyecto no está en JavaScript? ¿Se rompe el analizador?»
El análisis estático de código integrado en REA examina un programa sin ejecutarlo, trazando el mapa de funciones y sus conexiones. De fábrica soporta JS/TS, Electron, .NET, sitios web y binarios nativos (vía Ghidra, IDA y Hopper). Sin embargo, tampoco se queda corto en Python o Ruby, como muestran tres ejemplos.
Con el editor visual Puck (TypeScript, MIT), REA jugó en casa. DeepSeek empaquetó el núcleo en un único bundle JS y el analizador recorrió 32,000 nodos de código, arrojó 81 hallazgos y más de 1,500 relaciones de llamadas. Identificó con precisión dos funciones clave: insertAction (inserta un bloque en los datos) y moveComponent (arrastre). Siguiendo el patrón «bloques -> datos -> renderizado», construyeron un creador de landing pages.
Con la librería Python smolagents de Hugging Face el comportamiento fue igual de transparente: el analizador JS reportó 0 archivos JS y no inventó nada. DeepSeek leyó el código Python por su cuenta, fijó 7 archivos centrales del ciclo del agente (controlador, planificador, generador de pasos, ejecutor y respuesta final) y armó un agente de reportes para clientes; eso sí, para la demo el modelo inventó una «clínica local» y hubo que cambiarla por un negocio de coaching.
En el foro Discourse (Ruby), solo entregaron al agente el recorte necesario: la clase de búsqueda de más de 1,700 líneas y el plugin Solved. Ahí encontró la función que clasifica temas en tres estados (resolved, in progress, unanswered), y sobre esa lógica montaron un «radar de preguntas sin respuesta».
Instalación y dos tropiezos comunes al empezar
Necesitas tener instalado DeepSeek Harness (dsh) y Node.js versión ^22.23.4, ^24.22.1 o >=26.12.1. El paquete rea-agents se conecta desde la terminal:
# Conectamos el servidor MCP de REA y su skill a DeepSeek Harness
npx rea-agents@latest setup --client dsh

# Verificamos la integración (la línea DeepSeek Harness debe marcar healthy)
npx rea-agents doctor --client dsh

# Listamos las herramientas de análisis disponibles (opcional)
npx rea-agents capabilities

# Iniciamos la interfaz web de DeepSeek Harness
dsh web
Tras arrancar, crea una carpeta de trabajo y dentro coloca source estrictamente en modo read-only para que el agente lea el código sin modificarlo. Basta con guardar allí un shallow clone (clon superficial), es decir, descargar el repositorio Git solo con la última foto de archivos sin todo el historial de commits.
Aquí es fácil caer en dos errores. El primero es pasar un repositorio gigante entero: el reporte se diluye y conviene acotar un módulo concreto, como con Discourse. El segundo es inflar el contexto. REA registra unas 139 herramientas MCP que en tareas cotidianas consumen memoria del modelo sin necesidad; la comunidad ya creó envoltorios como dsh-rea con un interruptor rápido. Además, el README deja una advertencia clave: instala el paquete solo desde fuentes oficiales (morluto/rea, rea.tools, npm rea-agents), porque ya circulan clones falsos.
Cinco reglas para analizar código sin riesgos
- Revisa
evidence.md: el informe debe citar archivos y funciones reales. - Lee el apartado «qué no se pudo demostrar» y profundiza aparte si hace falta.
- Ejecuta la compilación y prueba cada botón a mano.
- Comprueba que debajo corre la lógica hallada y no una simulación vacía.
- Mantén
sourceenread-onlyy verifica la licencia original (MIT, GPL/AGPL o código cerrado).
Ese último punto no es un trámite menor. El código ajeno está protegido por su licencia, así que el método correcto aquí es una reconstrucción clean-room: documentas la idea en una especificación y escribes tu propio código desde cero sin copiar el producto original.