Todo desarrollador backend conoce esa encrucijada. La primera opción es mantener abierto un monstruo pesado aparte como DataGrip o DBeaver: funciones de sobra, pero la memoria se evapora y pasas el día saltando entre ventanas. La segunda es usar el cliente integrado en el editor: todo queda a mano, aunque suele llevarse bien solo con PostgreSQL o MySQL básicos y se rinde ante SQL Server, Kerberos o distribuciones corporativas específicas.
En OpenIDE 2026.2 redujeron bastante esa brecha: el equipo de Haulmont publicó el cliente de BD integrado versión 0.0.23 (los detalles salieron en un artículo en Habr). La actualización llegó densa: seis SGBD nuevos de golpe, SQL parametrizado y autenticación corporativa.
Seis SGBD nuevos y mejoras útiles para los ya conocidos
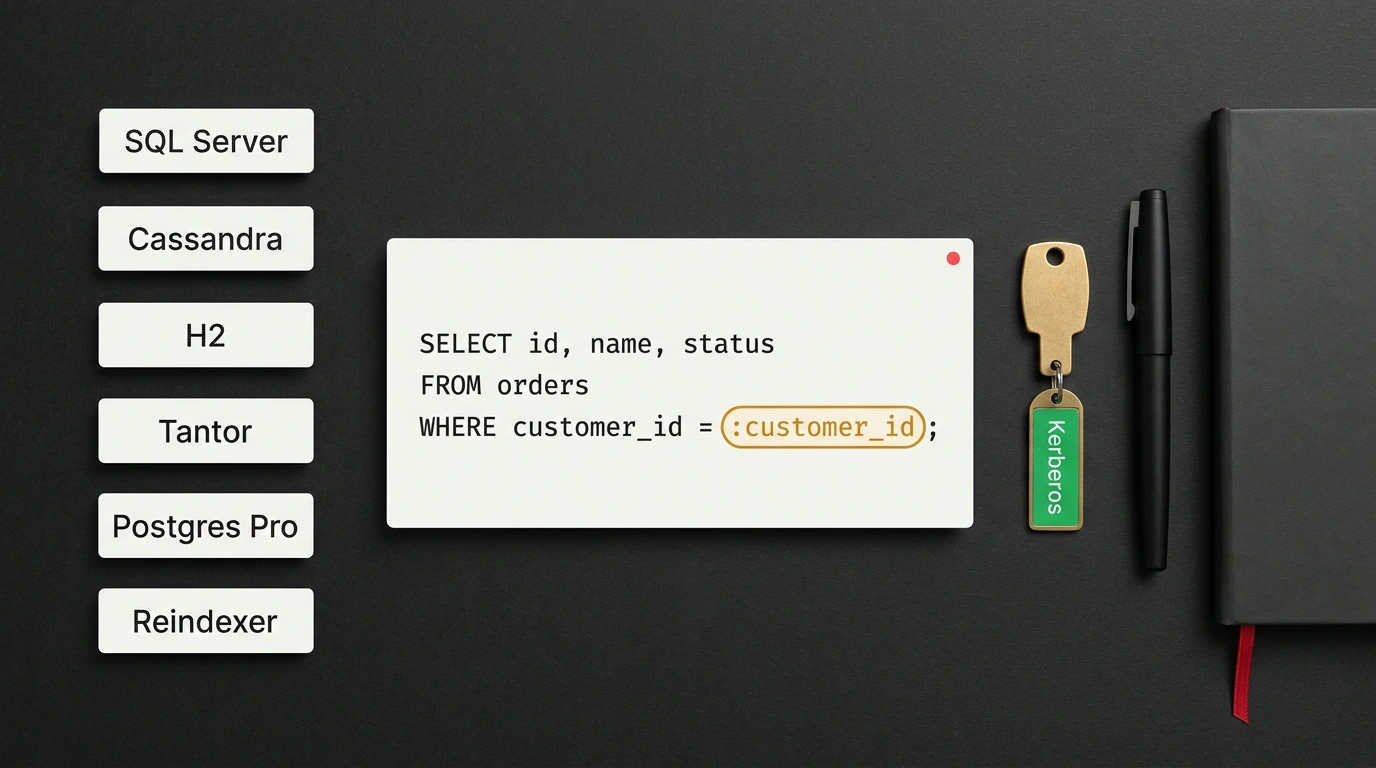
Al cliente añadieron Microsoft SQL Server, Apache Cassandra, H2, Tantor Postgres, Postgres Pro y Reindexer. La selección apunta a producción real: Tantor Postgres y Postgres Pro son compilaciones corporativas rusas de PostgreSQL, mientras Reindexer es un SGBD documental rápido y embebible con lenguaje de consultas similar a SQL.
Cada base nueva cuenta con su propia consola y resaltado del dialecto nativo: T-SQL para SQL Server, CQL para Cassandra, funciones de H2 y sintaxis de Reindexer. El autocompletado conoce las columnas de las tablas y los caracteres cirílicos en los resultados se muestran sin distorsión.
También reforzaron tres SGBD que ya estaban presentes. En Oracle ampliaron el árbol de objetos, la generación de DDL y la migración de datos contemplando PL/SQL y tipos complejos. En Greenplum la exportación de tablas distribuidas conserva los parámetros de almacenamiento, compresión y particiones. Y en SQLite ahora puedes adjuntar archivos de base adicionales mediante ATTACH, y al reconectar esos vínculos se restauran solos.
SQL parametrizado sin cambios sobrantes en Git
Una escena conocida: en el proyecto hay un archivo .sql con un WHERE o.customer_id = 1042 fijo. Necesitas revisar los pedidos de otro cliente, cambias el número a mano y antes del commit te toca acordarte de revertir el cambio.
En 0.0.23 esto funciona como un formulario plantilla en papel: el archivo en el repositorio queda intacto y tú rellenas los números en una copia antes de ejecutar, verificándolos a simple vista.
-- En lugar del número fijo 1042 ponemos el parámetro :customer_id:
-- el archivo en Git queda limpio y OpenIDE muestra el SQL final
SELECT o.id, o.status, o.total, o.created_at
FROM orders o
WHERE o.customer_id = :customer_id
ORDER BY o.created_at DESC
LIMIT 20;
Al ejecutar, el cliente pide introducir el valor de :customer_id, indicar su tipo y muestra al instante una vista previa del SQL resultante. Puedes elegir entre dos modos: sustituir el valor directo en el texto de la consulta o pasarlo al driver como parámetro enlazado, exactamente como opera el backend. El archivo original no cambia y el diff en Git permanece limpio.
Acceso por URL con Kerberos, exportación y escudo contra DROP accidentales
Una conexión nueva ahora se arma desde una cadena lista: copias la URL desde la configuración de la aplicación en vez de teclear host y puerto a mano, y para servidores corporativos activas Kerberos en la autenticación avanzada.
# URL JDBC típica de configuración que puedes pegar en el cliente
jdbc:postgresql://db:5432/app?gssEncMode=require&jaasApplicationName=pgjdbc
Kerberos funciona como una credencial de acceso en la oficina: verificas tu identidad una vez, recibes un ticket temporal y te conectas a los servidores sin enviar la contraseña en cada petición. Además, el ajuste keep-alive pasó a ser individual para cada conexión.
Las filas seleccionadas de los resultados se copian en cinco formatos: CSV, JSON, XML, Markdown y SQL. Markdown entrega al instante una tabla lista para un ticket o merge request, y SQL resulta práctico para llevar un par de filas a la base de pruebas. Para limpiar tablas temporales añadieron borrado masivo: antes de ejecutar, el cliente muestra el script DROP TABLE final y pide escribir una frase de control (desactivable en ajustes), haciendo mucho más difícil tocar por accidente una tabla viva.
Para la depuración diaria en proyectos de Java, Python, Go y TypeScript esto ya alcanza con creces, sobre todo en entornos corporativos. Los límites son claros: la versión 0.0.23 aún es joven y exige OpenIDE 2026.2, mientras que la edición ampliada OpenIDE Pro se ofrece ahora gratis dos meses sin recorte de funciones. Si eres DBA de tiempo completo y vives entre diagramas complejos de esquemas, todavía es pronto para desinstalar DataGrip aparte.