El controlador de la base envía una verificación de salud al maestro de PostgreSQL y recibe... silencio. En ese instante ya se cocina un problema serio tras bambalinas: las aplicaciones no pueden escribir con normalidad y el nodo de control intenta adivinar qué ocurrió. ¿Murió el servidor de verdad o simplemente parpadeó la red hacia el controlador mientras el maestro sigue atendiendo clientes sin problemas? Si te apresuras a promover una réplica, terminarás con dos maestros vivos al mismo tiempo. Bienvenido al split-brain y a los datos divergentes.
Cómo evitarlo lo explicó Shlomi Noach, ingeniero de PlanetScale, en un artículo del 5 de noviembre de 2026 sobre el failover de emergencia en Neki, su PostgreSQL con sharding. En el análisis anterior se trataba el cambio planificado, donde todos los nodos están sanos, el sucesor se elige de antemano y los routers almacenan en búfer las consultas. Ante un corte repentino de red o un fallo de hardware no existe ese lujo: el sistema debe decidir sobre la marcha si el maestro realmente quedó inaccesible y qué réplica puede reemplazarlo de forma segura.
Por qué el silencio en el health check no basta para cambiar de maestro
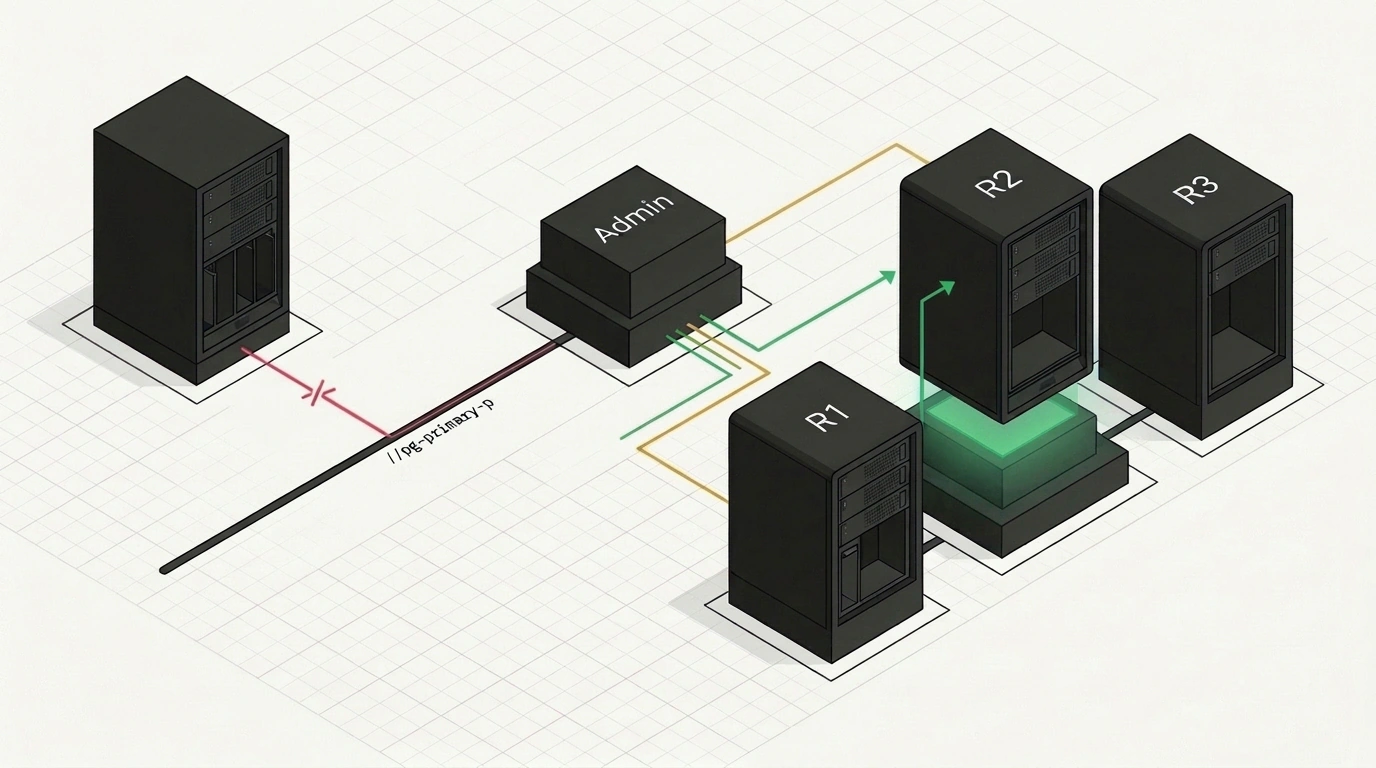
Imagina un shard típico de Neki: el maestro P recibe escrituras, mientras las réplicas R1, R2 y R3 descargan y reproducen continuamente el WAL (Write-Ahead Log, el registro previo a la escritura donde PostgreSQL guarda primero todos los cambios). Si el nodo de control Admin pierde contacto con P, repetir la comprobación no sirve de mucho: ayuda ante una pérdida puntual de paquetes, pero si el propio Admin quedó aislado en la red, no habrá respuesta aunque el maestro y las réplicas sigan trabajando con normalidad.
Muchos sistemas de alta disponibilidad confían en leases distribuidos: un agente en el maestro renueva una clave con temporizador en un almacenamiento compartido y, si la clave caduca, el servidor se da por muerto. En Neki descartaron los leases para comprobar la salud. En su lugar, Admin consulta a las réplicas mediante la vista del sistema pg_stat_wal_receiver.
-- Admin comprueba el estado de recepción de WAL en cada réplica viva
SELECT status,
       written_lsn,
       flushed_lsn,
       last_msg_receipt_time
FROM pg_stat_wal_receiver;
La lógica de decisión es directa. Si Admin no ve a P, pero al menos una réplica sigue recibiendo datos de él, no hay cambio: lo más probable es que falló el propio Admin. Si Admin no ve a P, al menos una réplica disponible reporta corte y ninguna la contradice, el maestro se declara caído. Y si no responden ni P ni las réplicas, el controlador simplemente espera: promover a alguien a ciegas es el camino directo hacia un segundo maestro.
La confianza aquí proviene de la replicación síncrona. Por defecto, Neki configura en synchronous_standby_names la política ANY 1 (R1, R2, R3) con synchronous_commit = on: el maestro no confirma un commit al cliente hasta que al menos una réplica haya volcado el WAL a disco. En el instante T puede confirmar R1, y en T+1, R3. Pero si ninguna réplica logra comunicarse con el maestro, este no podrá completar físicamente ni una sola escritura, incluso si sigue vivo.
Cuatro fallos y una sola señal: cómo atrapar incluso un Postgres colgado
Para que el sondeo de réplicas reaccione rápido, estas deben detectar el corte sin demora. Y una base de datos falla de muchas formas.
Ante una caída normal del proceso, el gestor local PostgresManager (cuya goroutine espera a que termine el proceso) envía al instante a Admin el evento PROCESS_EXITED, aunque el controlador igual contrasta con las réplicas. Si entre los nodos se interpone un firewall bloqueando tráfico, las conexiones fallan de inmediato con error.
Peor es la pérdida silenciosa de paquetes: el socket calla y la conexión TCP parece viva durante mucho tiempo. Pero el caso más traicionero, según Noach, es un proceso de PostgreSQL congelado: el kernel del servidor responde bien por TCP, la conexión luce sana, pero la base no hace absolutamente nada.
La réplica no necesita distinguir estos escenarios. Neki ajusta los timeouts para que cualquier fallo termine cortando la replicación: la pérdida de paquetes la atrapan TCP keepalive cortos y tcp_user_timeout, mientras que al proceso colgado lo remata wal_receiver_timeout. En PostgreSQL viene en 60 segundos por defecto, pero Neki lo reduce a unos pocos segundos: si el maestro guarda silencio más tiempo, la réplica corta la conexión por su cuenta.
# En el maestro (postgresql.conf): el commit espera flush de WAL de 1 réplica
synchronous_commit = on
synchronous_standby_names = 'ANY 1 (R1, R2, R3)'

# En las réplicas (postgresql.conf): corte rápido ante maestro colgado
# El valor por defecto en PostgreSQL es 60s; aquí 5s ilustra «unos pocos segundos»
wal_receiver_timeout = 5s
Así, cuatro averías muy distintas se reducen a una única señal en pg_stat_wal_receiver, sin parches separados para cada tipo de fallo.
El truco de las dos barras: cómo cortarle el paso al maestro «resucitado»
En cuanto Admin decide hacer el cambio, se activa una regla estricta: «A partir de este momento asumimos lo peor: el maestro antiguo puede volver a la vida en cualquier segundo». Antes de iniciar el failover, el regreso de P es inofensivo porque las réplicas simplemente se reconectan. En cambio, si resucita en mitad del cambio, las réplicas volverán a él por sí solas, el WAL volverá a fluir y P podrá cerrar commits de nuevo según ANY 1.
En MySQL existe STOP REPLICA IO_THREAD para detener la recepción del log, pero la replicación física de PostgreSQL no tiene ese interruptor. Por eso Neki aplica un cambio reversible en primary_conninfo en todas las réplicas disponibles: añade // delante del nombre del host del maestro.
# Antes del failover: la réplica está conectada al maestro pg-primary-p
primary_conninfo = 'host=pg-primary-p port=5432 application_name=R2'

# Inicio del failover: el prefijo // rompe la resolución del host,
# impide que la réplica vuelva a un P resucitado y congela su posición en el WAL
primary_conninfo = 'host=//pg-primary-p port=5432 application_name=R2'
El mismo recurso funciona en Neki durante el cambio planificado. El beneficio es doble: un P resucitado se queda sin réplicas y no puede escribir nada, mientras las posiciones del WAL en todos los nodos quedan congeladas para compararlas con justicia.
Selección del nuevo líder por LSN, cambio y destino del maestro antiguo
La posición en el registro la marca el LSN (Log Sequence Number): receive_lsn indica cuánto log descargó la réplica por la red, y replay_lsn, cuánto aplicó ya. Este es un ejemplo de corte tras la congelación:
| Réplica | Recibido (receive_lsn) | Aplicado (replay_lsn) |
|---|---|---|
R1 | 120 | 120 |
R2 | 125 | 122 |
R3 | 123 | 123 |
La segunda réplica descargó más registros por la red, pero aún está terminando de aplicar la cola del log local. La tercera va un poco detrás en recepción, aunque ya aplicó todo lo recibido. La primera simplemente quedó rezagada. Primero Admin busca un nodo que ya haya reproducido el log más reciente; como no hay ninguno, espera una breve ventana para que el líder en recepción termine su cola. Si en esa ventana nadie lo alcanza, elige al candidato con mayor receive_lsn y, en caso de empate, al de mayor replay_lsn.
Como el WAL es estrictamente secuencial, el máximo en recepción garantiza que el candidato posee toda la historia confirmada, sin importar qué réplica haya confirmado cada commit individual. Como ventaja adicional, las demás réplicas contienen un prefijo del nuevo maestro y pasan sin problema al nuevo timeline. La excepción ocurre si al frente quedó una réplica en mantenimiento que no se puede promover: después habrá que revertirla mediante rewind o reconstruirla.
Luego Admin crea los slots de replicación en el nodo elegido, lo promueve en PostgreSQL, redirige los Routers y reorienta a las demás réplicas. Las primeras escrituras en el nuevo maestro esperarán un poco: por la regla ANY 1 necesita al menos una réplica conectada.
Al maestro antiguo P nunca se lo devuelve automáticamente como réplica tras un fallo, porque podría conservar escrituras sin confirmar. Se lo pasa a TEARDOWN (fuera de tráfico, replicación y monitoreo), pero no se borra el disco de inmediato: los logs, el último WAL y el estado del disco son la mejor evidencia para el postmortem.
Los límites del diseño también son claros. Si P y una sola réplica quedan aislados juntos, podrán seguir confirmando commits bajo ANY 1; ese riesgo se reduce con confirmaciones entre zonas de disponibilidad (cross-AZ) a costa de mayor latencia de escritura. Tampoco salva la automatización si mueren a la vez el maestro y la réplica más adelantada, y en modo asíncrono la desconexión de réplicas solo da una señal fuerte, no una garantía. Por último, también puede caer el propio Admin, un análisis que Shlomi Noach dejó para el próximo artículo.