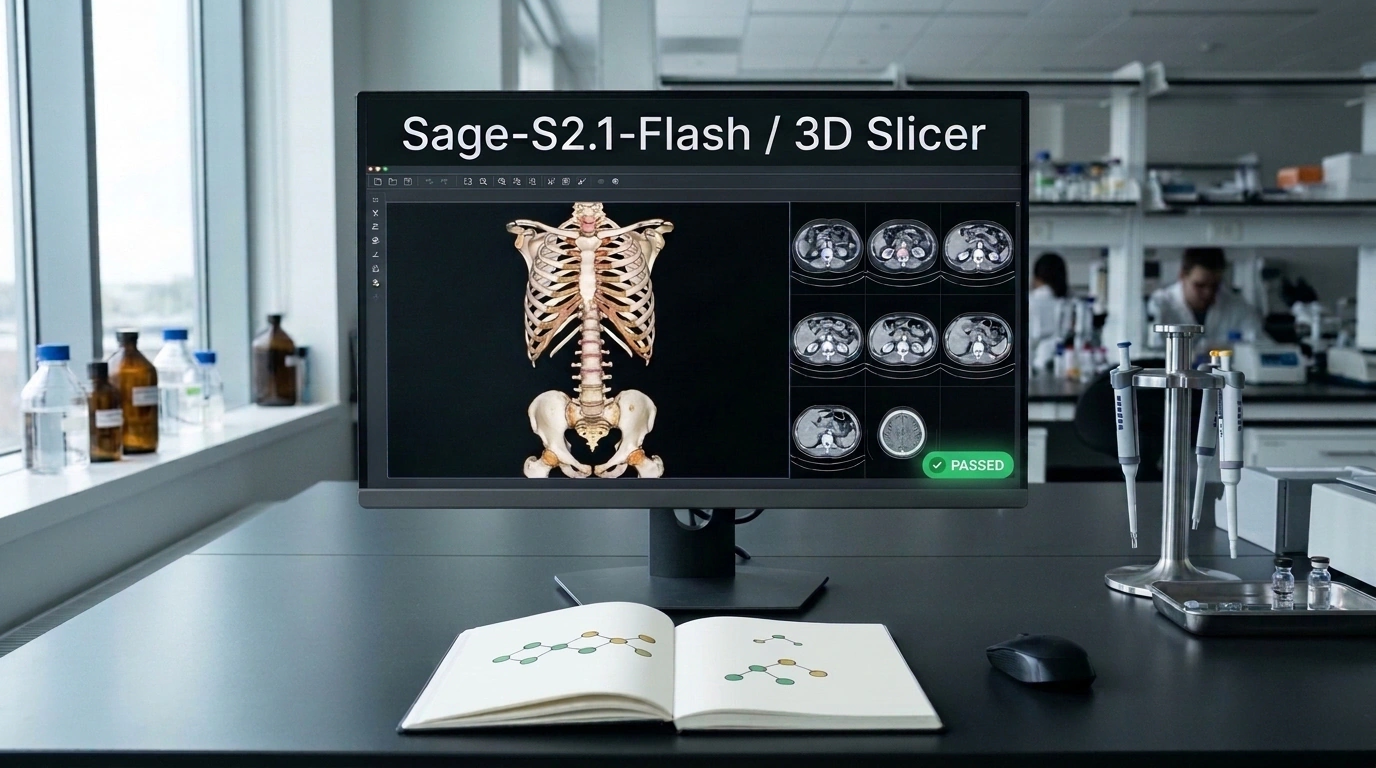
Sube a un chatbot común una carpeta con 12,487 imágenes médicas desordenadas y pídele reconstruir un esqueleto humano en 3D. Como mucho recibirás instrucciones amables para hacerlo a mano. El nuevo modelo abierto Sage-S2.1-Flash, del equipo InternLM en Shanghai AI Lab, hizo algo distinto: abrió por su cuenta 3D Slicer (el software gratuito que usan médicos e investigadores para analizar tomografías y resonancias), extrajo los 139 cortes de TC necesarios, verificó el orden, detectó un fallo propio, reordenó la secuencia y completó el modelo 3D.
Ese resultado se apoya en dos pilares: el modelo lee de forma nativa archivos científicos crudos y trabaja en un ciclo agéntico con autoverificación. Los pesos se publicaron bajo licencia libre MIT, así que puedes descargarlos, ajustarlos e integrarlos incluso en productos comerciales.
Qué lleva por dentro: un equipo de expertos y «traductores» para ciencia
En el núcleo de Sage-S2.1-Flash hay una arquitectura Mixture of Experts (MoE): suma 320 mil millones de parámetros en total, pero para cada palabra (token) nueva activa solo unos 18 mil millones. Imagina un gran instituto científico: para una tarea puntual no reúnes a los trescientos investigadores, sino solo a una brigada de veinte especialistas. El modelo conserva el conocimiento de un gigante, pero responde mucho más rápido que redes densas del mismo tamaño.
La pieza clave es el módulo Sage SciPerception. A las redes multimodales habituales hay que pasarles los datos científicos como capturas de pantalla o resúmenes en texto. Eso equivale a mirar la foto de una fórmula en la pizarra en lugar de la fórmula misma: se pierden relaciones y con los números empieza la adivinanza.
En Sage integraron codificadores específicos —«traductores» especializados— que convierten formatos científicos crudos directo en vectores numéricos comprensibles para la red. Lee de forma nativa más de diez tipos de datos: grafos moleculares, estructuras cristalinas, proteínas, ADN y ARN, espectros (incluidos difracción de rayos X y espectrometría de masas), bioseñales EEG y ECG e incluso curvas de luz de satélites. El investigador entrega el espectro o la estructura del cristal y pide identificar el compuesto o estimar propiedades del material.
Cómo detecta el agente sus propios errores
El momento más revelador de la demo en el sitio del proyecto no es la selección de 139 cortes entre 12,487 archivos, sino lo que pasó después. Tras ordenar las imágenes, Sage-S2.1-Flash ejecutó una prueba de consistencia del orden y el test falló.
Un script normal en ese punto habría generado un modelo deformado o se habría detenido con error. Aquí el modelo vio el fallo, retrocedió, reconstruyó por sí solo la secuencia correcta de cortes y recién entonces generó el esqueleto 3D en 3D Slicer. Toda la diferencia entre «una IA que aconseja» y «una IA que ejecuta» cabe en ese ciclo corto: abrir la herramienta, dar un paso, comprobarse y arreglar el tropiezo sobre la marcha.
Dónde supera a sus rivales y dónde cede con claridad
Shanghai AI Lab comparó seis modelos —Sage S2.1 Flash, DeepSeek-V4.1-Flash-1017, Qwen3.8-Max, GLM-5.3-Flash, GPT-5.6 Sol y Claude Opus 5— en 15 benchmarks. En el balance general, Sage obtuvo el primer puesto en cuatro pruebas y el segundo en otras siete. Estas son las cifras clave de la ficha oficial:
| Benchmark | Tarea | Sage S2.1 Flash | Principal competidor |
|---|---|---|---|
| MLE-bench Lite | Ingeniería de ML | 90.3 | DeepSeek-V4.1-Flash-1017 — 89.2 |
| OfficeQA Pro | Documentos complejos | 72.2 | DeepSeek-V4.1-Flash-1017 — 69.7 |
| Harvey LAB | Tareas jurídicas | 25.0 | Qwen3.8-Max — 24.2 |
| SpreadsheetBench 2 | Hojas de cálculo | 37.1 | DeepSeek-V4.1-Flash-1017 — 35.8 |
| Terminal-Bench 2.1 | Trabajo en terminal | 87.9 | Claude Opus 5 — 90.2 |
| SWE-bench Pro | Desarrollo de software | 60.6 | Claude Opus 5 — 76.5 |
En ingeniería de ML, documentos densos y hojas de cálculo, Sage iguala o supera a los líderes. Pero no es un reemplazo universal de los modelos insignia: en programación pura, tareas de terminal y compilación de repositorios queda claramente por detrás de Claude Opus 5 y en algunos puntos por debajo de DeepSeek-V4.1-Flash-1017.
Conviene tener presentes dos límites. Primero, la tabla proviene de la propia Shanghai AI Lab y aún faltan evaluaciones independientes. Segundo, la «ligereza» de MoE engaña al desplegarlo: se activan 18 mil millones de parámetros, pero en la memoria de las GPU hay que cargar los 320 mil millones de pesos. Una laptop doméstica no puede con eso; el formato apunta a clústeres de GPU universitarios y corporativos que no pueden enviar datos científicos a nubes externas.
El modelo se puede descargar en Hugging Face en formato original BF16, y para ahorrar memoria los autores también publicaron una versión oficial en FP8.